 xoreaxeaxeax/skitter-creek-bath-salts
DRAM 스크램블링으로 CPU의 _모든 것_ 잠금 해제

DRAM 스크램블링으로 CPU의 모든 것을 잠금 해제 — PSP, C6, 마이크로코드, SMM, 그리고 명세서가 빠뜨린 다른 모든 것.
&x == &x.
보통은.
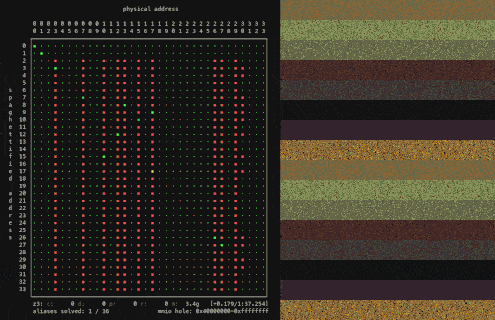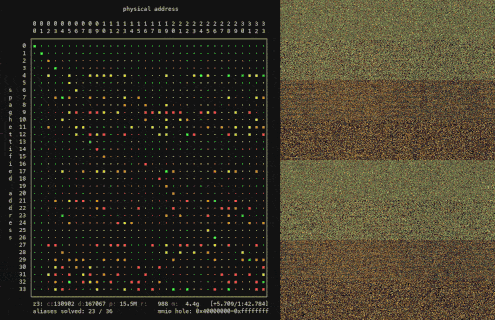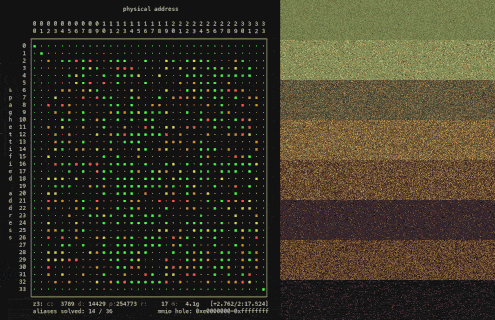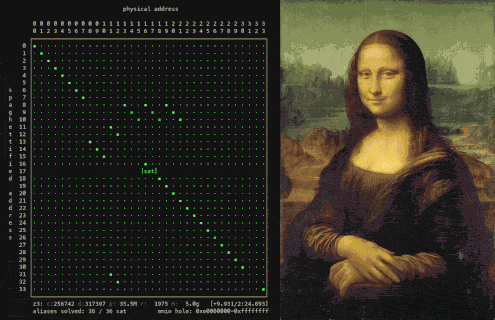
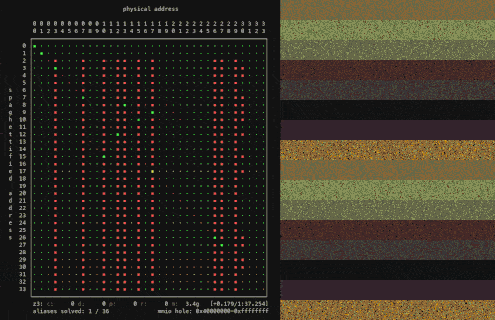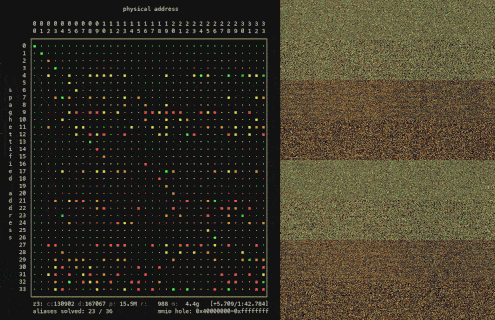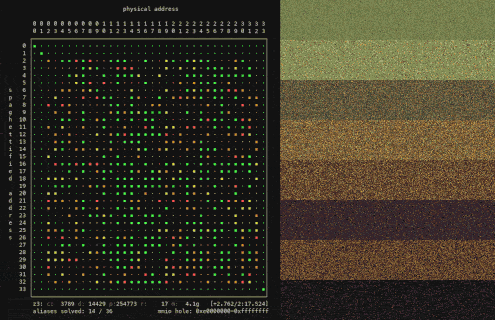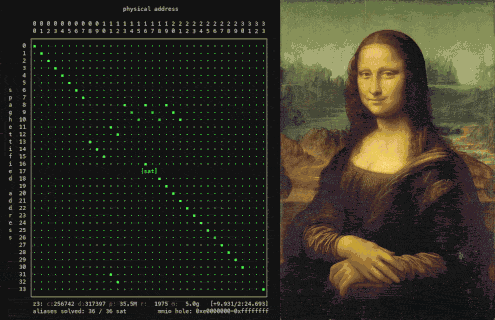
DRAM 컨트롤러를 건드리면 주소가 메모리 내 원하는 위치에 도달하도록 만들 수 있다. skitter-creek-bath-salts는 메모리 계층의 최하위 레이어를 수정하여 물리적 DRAM 주소 변환을 재배선한다. 이는 플랫폼 메모리를 스크램블하여 커널조차 볼 수 없는 DRAM의 보호된 영역 — carveout — 을 노출시킨다. 주소 변환이 깨지면 그 위에 구축된 보안 원시 요소들도 깨지고, 우리는 모든 것을 잠금 해제한다.
AMD Family 16h CPU에서 개발 및 테스트되었으며, 이는 데이터시트에 DRAM 컨트롤러의 변환 레지스터가 문서화된 마지막 세대다 — 그리고 그것들이 잠길 수 없음을 보여준다. 17h 이후는 단순히 이 정보를 생략한다. *p의 오디세이는 세대와 아키텍처 전반에 걸쳐 유사하며, 그 기저의 변환은 ARM, RISC-V, 그 너머까지 확장된다; skitter-creek-bath-salts는 우리에게 시작하는 방법만을 보여준다.
*p의 오디세이내려가는 길은 멀다.
메모리는 거의 부조리할 정도로 깊은 추상화 계층 위에 구축되어 있다. 코드가 *p를 역참조할 때, p의 DRAM에 접근하는 것처럼 보인다. 그렇지 않다 — p는 가상 주소이며, DRAM의 단 하나의 비트라도 건드리기 전에 아래의 관문을 통과해야 한다:```
── CPU core / MMU ─────────────────────────────────────────────────
┌─ VA ← 64-bit virtual address from load/store
│
└> canonical-form check ──────────────────────┐ ← bits [63:48] sign-extend from bit 47
┌─ segment base add <─────────────────────────┘ ← FS.base / GS.base (MSR_FS_BASE, MSR_GS_BASE)
│
└> TLB probe ─────────────────────────────────┐ ← tagged by PCID (host) / VPID (guest)
hit → physical address k │
miss → engage hardware page walker │
┌─ page walk (from CR3) <─────────────────────┘ ← walked only on TLB miss
│ PML5[VA 56:48] ← only if CR4.LA57
│ PML4[VA 47:39]
│ PDPT[VA 38:30] ← 1 GiB leaf possible
│ PD [VA 29:21] ← 2 MiB leaf possible
│ PT [VA 20:12]
│ PTE ← R/W · U/S · NX · A/D · PAT · PCD · PWT · G
│
└> per-level checks ──────────────────────────┐ ← evaluated at every level of the walk
privilege (U/S) │ ← CPL vs PTE.U/S
write (R/W) │ ← + CR0.WP
execute (NX) │ ← EFER.NXE
SMEP / SMAP │ ← CR4.SMEP · CR4.SMAP · EFLAGS.AC
protection keys │ ← PKRU (user) · IA32_PKRS (supervisor)
┌─ A/D bit update <───────────────────────────┘ ← locked RMW on PTE
│
└> if guest: EPT / NPT re-walk ───────────────┐ ← each guest-PA above re-walked
EPT-PML4 → EPT-PDPT → EPT-PD → EPT-PT │ ← + EPT memory-type override
⇒ ~5× walks per single guest walk │
┌─ TLB shootdown IPIs <───────────────────────┘ ← invlpg broadcast to peer vCPUs
│
│ ── IOMMU (chipset / I/O fabric) ──────────────────────────────────
│
└> if device-initiated, IOMMU page walk ──────┐ ← VT-d / AMD-Vi: device-ID → domain → tables
│
┌── physical address k <─────────────────┘
│
│ ── CPU core / MMU — memory-type resolution ────────────────────────
│
└> MTRR range match ──────────────────────────┐ ← IA32_MTRR_DEF_TYPE + fixed/variable MTRRs
┌─ PAT entry select <─────────────────────────┘ ← IA32_PAT[ PTE.PAT:PCD:PWT ]
│
└> effective memory type ─────────────────────┐ ← { WB, WT, WC, WP, UC-, UC }
│
── CPU uncore — caches & coherence ────────────────────────────────
│
┌─ L1-D probe <───────────────────────────────┘ ← VIPT, per-core
│
└> L2 probe ──────────────────────────────────┐ ← per-core / per-CCX
┌─ LLC probe + directory consult <────────────┘ ← shared, sliced
│
└> snoop / coherence ─────────────────────────┐ ← MESI / MOESI broadcast
intra-socket │ ← broadcast to peer cores
inter-socket │ ← QPI · UPI · Infinity Fabric · CXL.cache
home-node directory response │ ← data | intervention | abort
│
── system data fabric / interconnect ──────────────────────────────
│
┌─ if MMIO range or sub-4 GiB MMIO hole <─────┘ ← uncore/data fabric posted/non-posted txn
│ → device BAR; done
│
└> else DRAM-bound: data fabric / mesh ───────┐ ← AMD DF · Intel mesh-or-ring uncore
│
┏━━ ── MCT / IMC (memory controller) ────────────────────────────────
W ┃ ┌─ DRAM hole remap <──────────────────────────┘ ← high-memory remap above TOM
E ┃ │
┃ └> memory-region exclusion remap ─────────────┐ ← reserved / protected ranges
┃ ┌─ channel interleave hash <──────────────────┘ ← XOR of selected PA bits → channel
A ┃ │
R ┃ └> rank interleave hash ──────────────────────┐ ← XOR of selected PA bits → rank
E ┃ ┌─ bank interleave hash <─────────────────────┘ ← XOR of selected PA bits → bank
┃ │
┃ └> bank swizzle / XOR scramble ───────────────┐ ← vendor- and BIOS-configurable
H ┃ ┌─ chip-select normalize (DCT) <──────────────┘ ← per-rank CS line
E ┃ │ rank → CS map
R ┃ │
E ┃ └> sub-channel select ────────────────────────┐ ← DDR5 / LPDDR5 only
┗━━ │
│
DRAM coordinates <─────────────────────────┘ ← bank group · bank · row (RAS) · column (CAS)
이 프로젝트는 `*p` 파이프라인의 가장 깊은 계층, 즉 MCT/DCT 계층에서 동작한다
— 데이터 패브릭/인터커넥트로부터의 물리 주소가 메모리
컨트롤러로 들어와 DIMM에 발행되는
최종 원시 DRAM 좌표로 마지막 한 번 재작성되는 지점이다.

---

## DRAM 스파게티화

> 물리 주소는 사실상 권고 사항에 가깝다.```nasm
xor dword [0xf80c2094], 0x00400000
그게 익스플로잇이다. 전부다.
DRAM 컨트롤러에서의 단 하나의 비트 플립이 *p 파이프라인의 하단을 재배선하고,
&x에 있던 데이터는 이제 비행 중 어딘가 다른 곳에 있다. 갑자기 &x != &x가 된다.
CPU, 펌웨어, uncore, 칩셋이 보호 메모리를 격리하기 위해 사용하는 모든 메커니즘은
메모리 컨트롤러 위에 위치하며, 그중 어느 것도 아래에서 벌어지는 일을 보지 못한다.
펜스는 물리 주소를 보호하지, DRAM 좌표를 보호하지 않는다; 좌표를 재배열하면
위쪽의 배리어들은 결코 알아차리지 못한다.
하지만 DRAM을 재배선하는 것은 쉽다. 위의 비트는 DCT의 뱅크-스위즐-모드이며, 이는 최종 계층에서 주소 재매핑을 제어하는 수십 개 중 하나에 불과하다 — 그것들을 찔러서 그 위에 구축된 모든 것을 무너뜨리기만 하면 된다. 그 다음 더 어려운 부분은 시스템 메모리 전체가 그 아래에서 뒤섞이는 동안 플랫폼을 계속 살려두는 것이다.
