 xiaoyan-lisa/defenses-for-tool-integrated-llm
툴 통합 LLM 에이전트를 적대적 공격으로부터 방어하기 위한 연구 코드와 실험으로, Agent Security Bench를 새로운 방어 전략과 공격 시나리오로 확장합니다.

이 저장소에는 도구 통합 대규모 언어 모델(LLM) 에이전트를 적대적 공격으로부터 방어하는 프로젝트의 코드와 실험이 포함되어 있습니다.
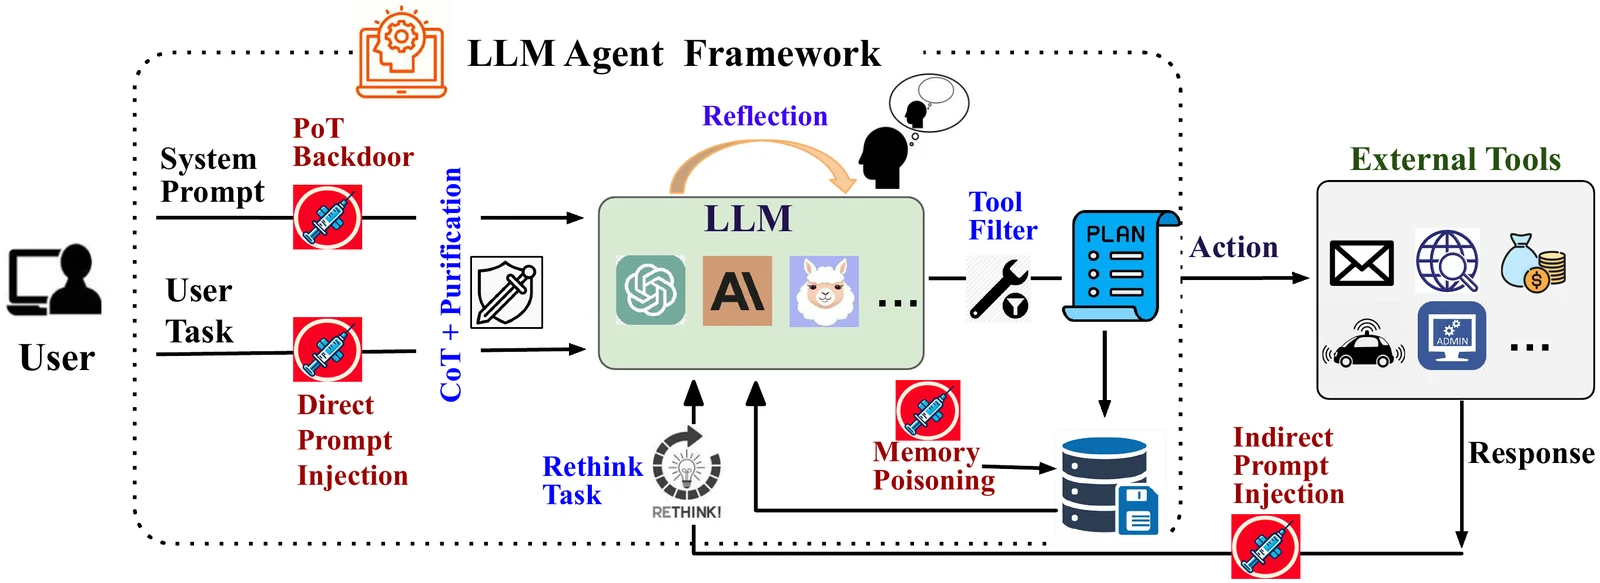
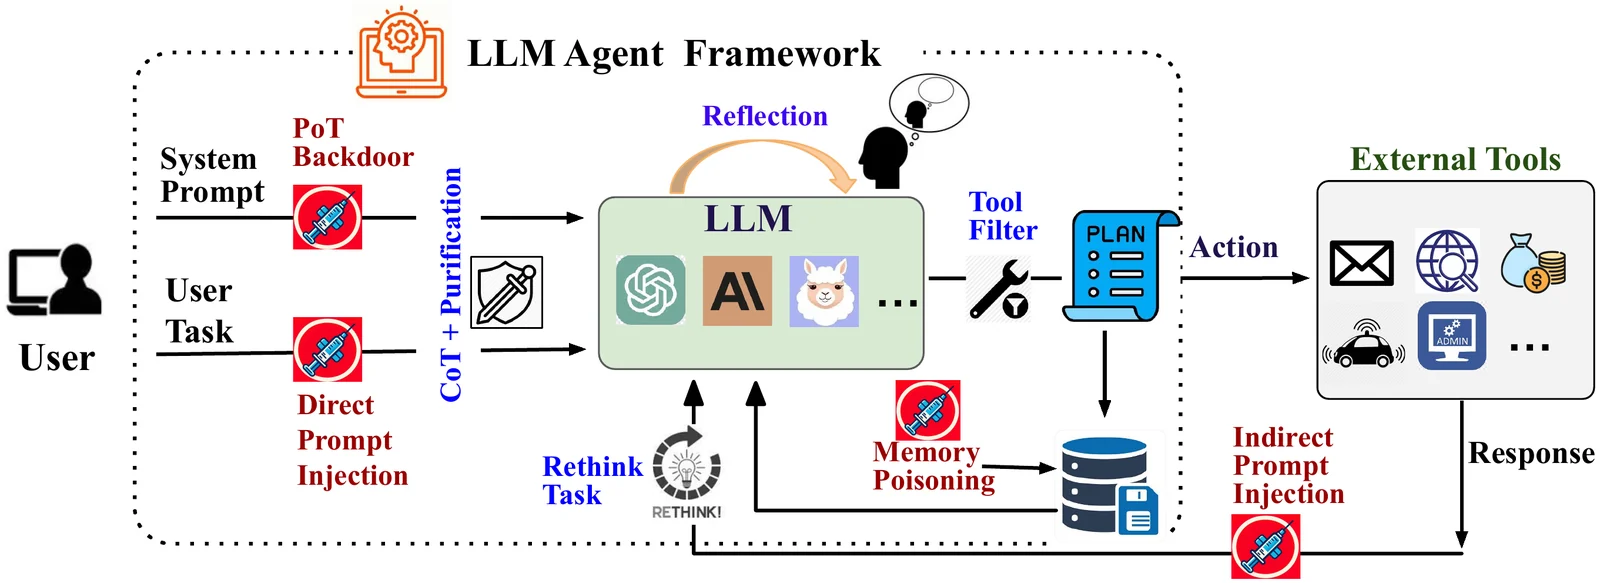
우리는 Agent Security Bench (ASB)를 기반으로 하여, 도구와 구조화된 추론(예: 사고 연쇄, 성찰)을 통합하는 것이 여러 작업 시나리오에서 LLM 에이전트의 적대적 프롬프트 취약성에 어떤 영향을 미치는지 평가합니다.
이 저장소에는 다음이 포함됩니다:
이 프로젝트는 공식 ASB 저장소의 코드를 각색하고 확장합니다:
Agent Security Bench (ASB): Formalizing and Benchmarking Attacks and Defenses in LLM-based Agents
GitHub: https://github.com/agiresearch/ASBench
Paper: https://openreview.net/forum?id=V4y0CpX4hK
ASB 저자들이 프레임워크를 공개해 주신 것에 감사드립니다.
pip install -r requirements.txt
DPI를 평가하려면:
python attack_launcher.py --cfg_path ./config/DPI.yml
IPI를 평가하려면:
python attack_launcher.py --cfg_path ./config/IPI.yml
MP를 평가하려면:
python attack_launcher.py --cfg_path ./config/MP.yml
백도어 공격을 평가하려면:
python agent_attack_pot.py
