 ucsb-mlsec/vulnllm-r
C/C++ 및 Python 소스코드 취약점 탐지를 위한 특화 추론 LLM으로, 데이터셋 구축, SFT/DPO 훈련 및 결과 재현 스크립트를 포함합니다.

git lfs install          # one-time setup
git clone https://github.com/ucsb-mlsec/VulnLLM-R.git
cd VulnLLM-R
# If you cloned before installing Git LFS, run: git lfs pull
conda create -n vulnscan python=3.11
conda activate vulnscan
pip install -e . -e ./vulscan/train/LLaMA-Factory -e ./vulscan/model_zoo
# generate VulnLLM-R-7B's results
python -m vulscan.test.test --output_dir results/test_data --dataset_path ./datasets/test/function_level/ ./datasets/test/repo_level/ --language python c java --model UCSB-SURFI/VulnLLM-R-7B --requests_per_minute 1000 --save --use_cot --batch_size 4 --tp 2 --vllm --max_tokens 8192 --random_cwe

python -m vulscan.test.test_hf \
      --output_dir results/test_hf \
      --hf_dataset UCSB-SURFI/VulnLLM-R-Test-Data \
      --hf_split repo_level function_level \
      --language c python java \
      --model UCSB-SURFI/VulnLLM-R-7B \
      --save --use_cot --vllm --tp 2

# [optional] generate other models' results with our shell script
# remember to add your API keys to .env file if you want to run commercial models
# use ./run_test.sh -h for more options
./vulscan/test/run_test.sh -o results/test_data -t 2 # -o means output directory, -t means tensor parallelism
./vulscan/test/run_test.sh -o results/test_data -M o3-mini # -M means model name, which runs only one model.
./vulscan/test/run_test.sh -o results/test_data -M gpt-5.4 -e high # -e sets reasoning effort (e.g., none/low/medium/high/xhigh)
./vulscan/test/run_test.sh -o results/test_data -M claude-opus-4-6 -e high

# [optional] draw plot to compare with other models
python plots/plot_language_comparison_models.py --results-dir results/test_data
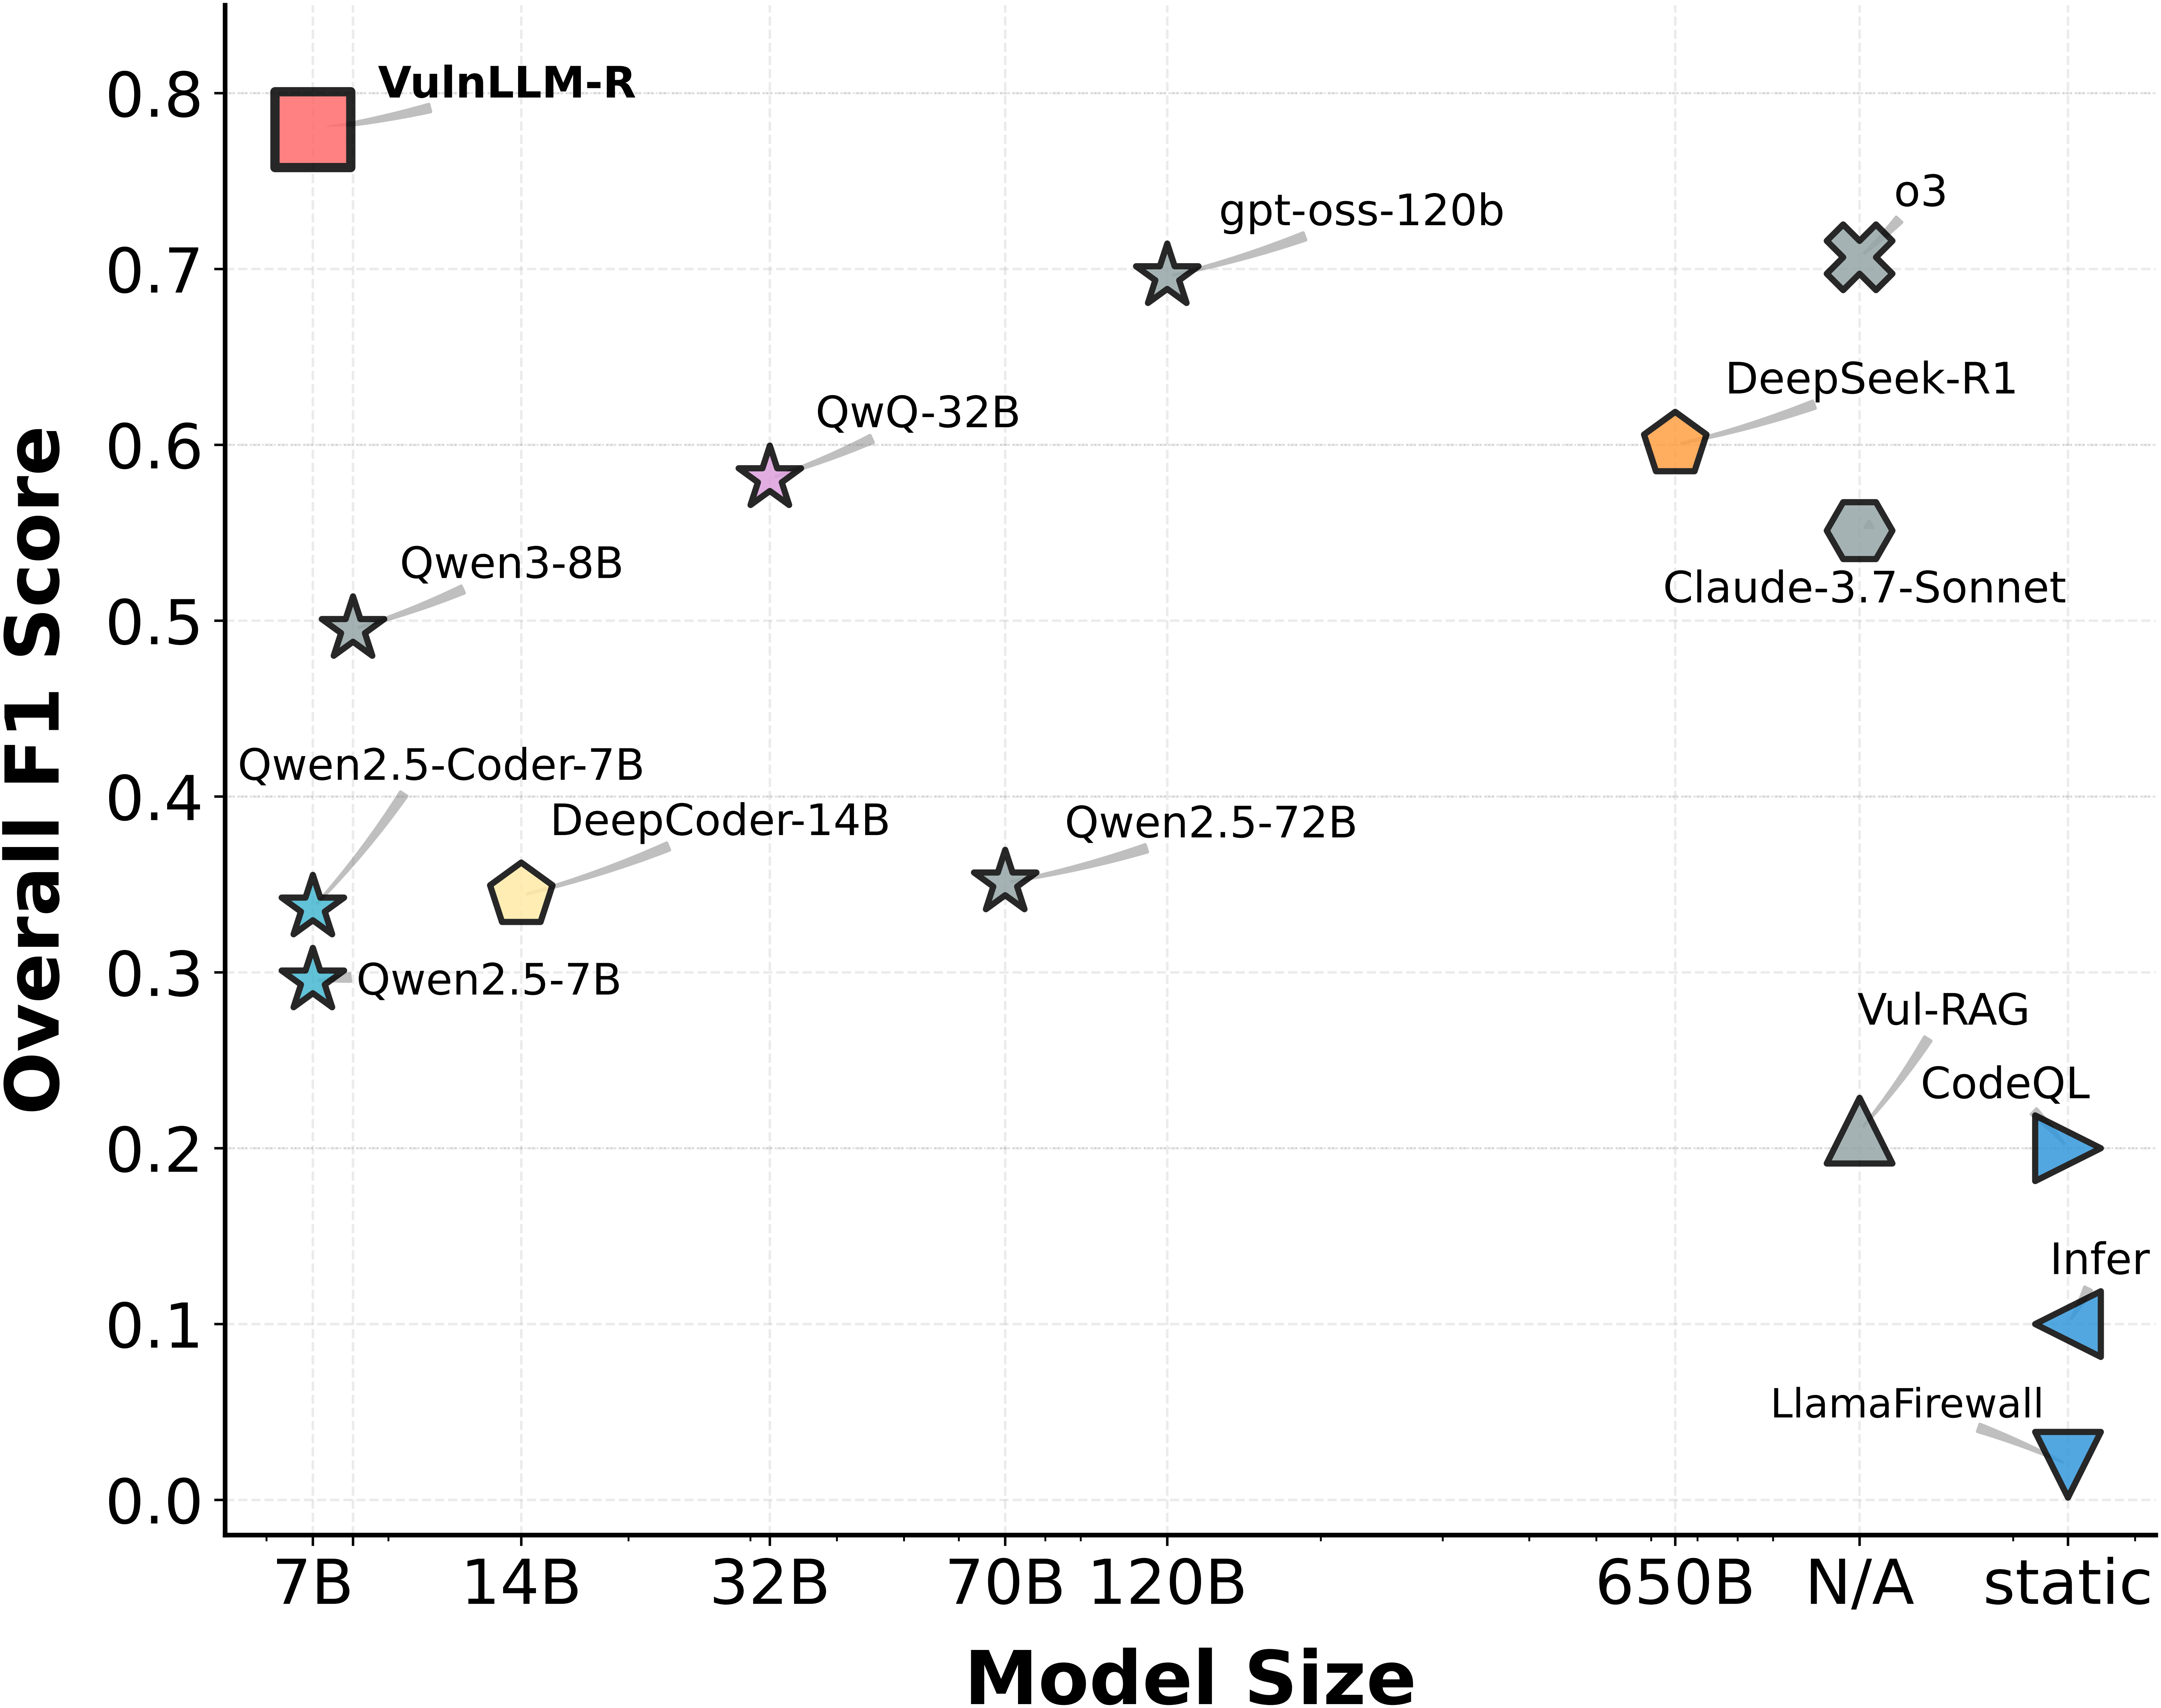
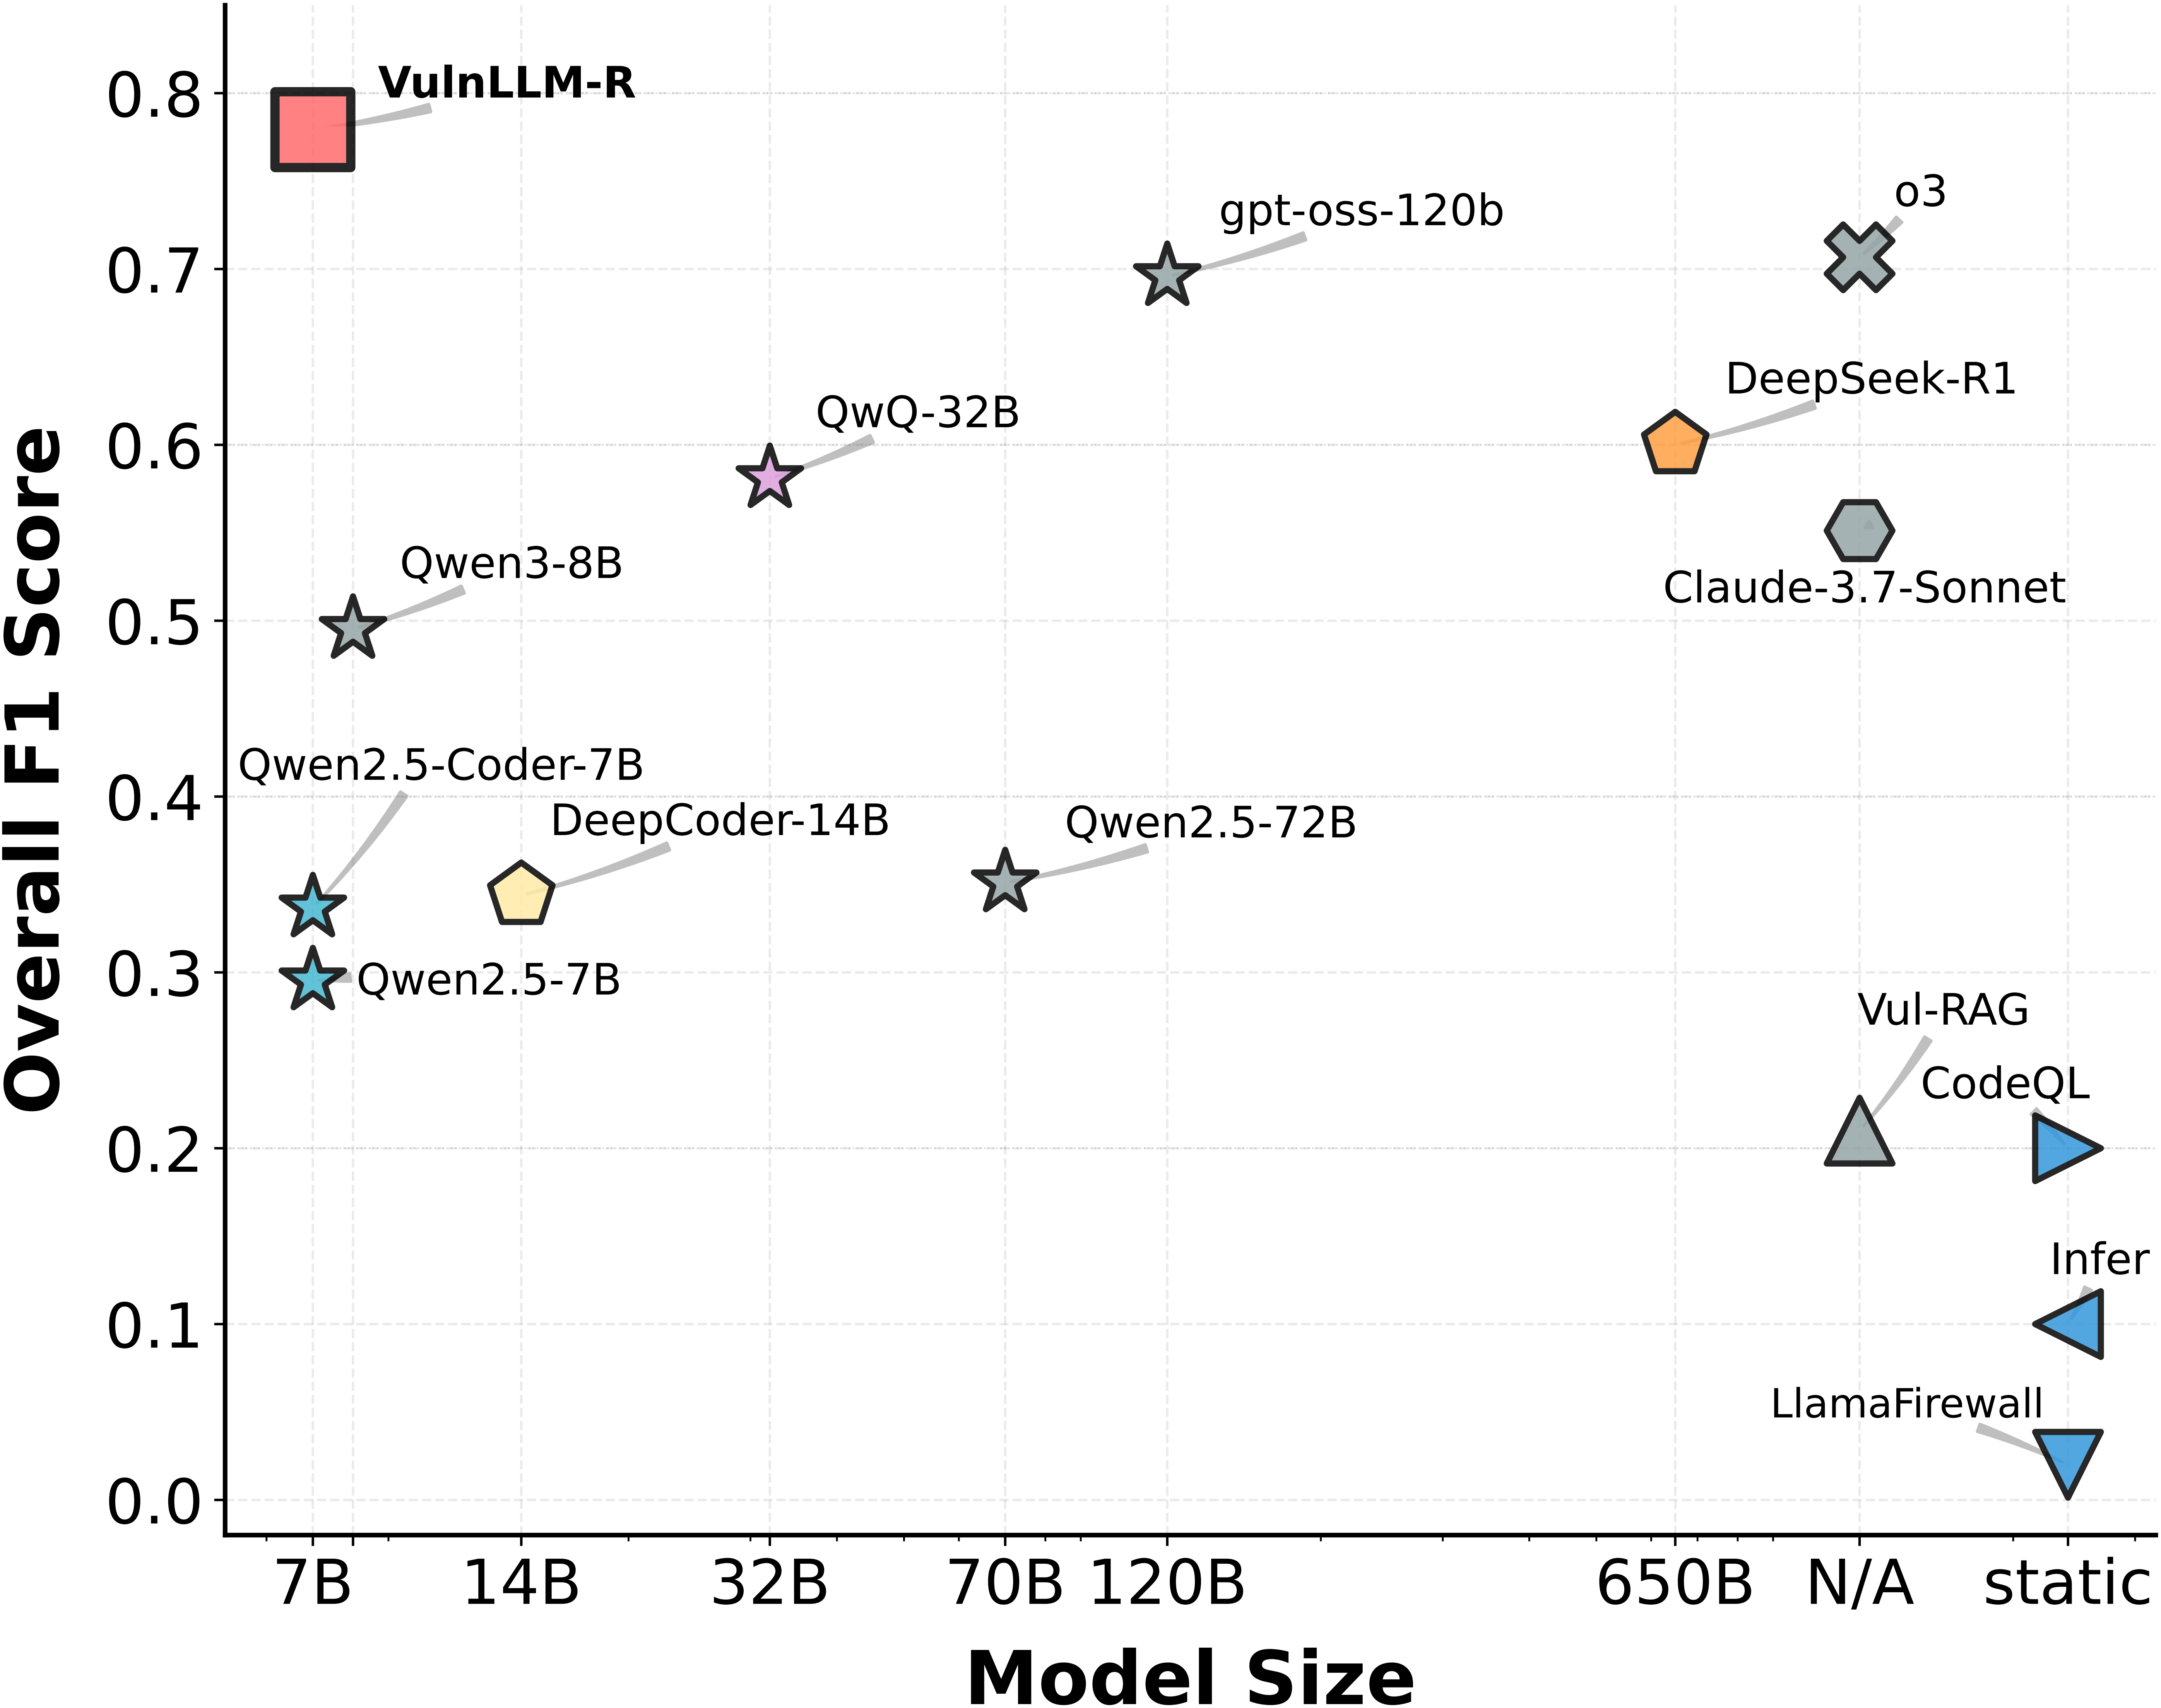
python plots/plot_model_size_scatter.py --results-dir results/test_data # Note: Labels may overlap with scatter points. Adjust text positions manually if needed.
또한 증류 데이터셋의 축소된 추론 버전도 제공합니다:
기존의 함수 수준(function-level) 취약점 탐지 데이터셋을 병합합니다: PrimeVul [1], SecCodePLT [2], Juliet [3], Sven [4], 및 Arvo [5]. 이 데이터셋들 중 PrimeVul이 가장 복잡한 함수를 포함합니다. 우리는 clean(PrimeVul 제외)과 noisy(PrimeVul 포함)라는 두 개의 학습 세트를 생성합니다. 이를 통해 비교적 단순한 데이터셋에서 학습하고 복잡한 PrimeVul 데이터셋에서 테스트할 수 있습니다. 참고로, PrimeVul이 포함된 학습 세트를 noisy라고 명명한 것은 데이터셋이 noisy하다는 의미가 아닙니다. 이는 초기에 사용한 다소 임의적인 이름입니다.
vulscan/data_process/data_utils에는 데이터셋을 처리하고 병합하는
일련의 스크립트가 있습니다.
raw_to_us.py: 원시 데이터를 우리 데이터셋으로 병합하고 중복 데이터를 제거합니다check_cwe_correct.py: 각 CWE 범주에 대한 정확도를 계산합니다generate_arvo_raw_data.py: arvo 데이터셋에서 구조화된 원시 데이터를 생성합니다arvo_to_us.py: arvo 구조화 원시 데이터를 우리 데이터셋 형식으로 재구성합니다split_good_bad_for_juliet.py: 원시 Juliet 1.3 데이터셋에서 데이터를 추출하여 필요한 형식으로 변환하며,
이는 우리 c clean_dataset의 일부를 구성합니다add_sven_to_clean_dataset.py: Sven 데이터셋에서 데이터를 추출하여 우리 C clean 데이터셋의 일부를 구성합니다sync_large_small.py: noisy_dataset/large_train/c의 수정 사항을 noisy_dataset/small_train/c와 동기화합니다remove_testing_from_training.py: 각 데이터에 human 태그를 추가하여, 해당 데이터가 사람에 의해 검증되었고
테스트 데이터로 사용되었음을 나타냅니다
-data_utils.py: 데이터셋에 related_cwe 필드를 추가합니다.datasets/clean_dataset: PrimeVul이 없는 학습 데이터
datasets/clean_dataset/python에는 SVEN 및 SecCodePLT의 데이터가 있습니다datasets/clean_dataset/c에는 Juliet 및 SVEN의 데이터가 있습니다datasets/noisy_dataset
datasets/noisy_dataset/small_train: 선택된 CWE가 있는 PrimeVul 및 SVEN의 학습 데이터를 포함합니다 (
이 데이터셋의 PrimeVul 데이터를 학습에 사용합니다)datasets/noisy_dataset/large_train: 더 많은 CWE가 있는 PrimeVul, SVEN 및 SecCodePLT의 학습 데이터를
포함합니다 (이 데이터셋은 나중에 더 큰 모델을 학습하는 데 사용할 수 있습니다)datasets/noisy_dataset/test: 사람이 검증한 PrimeVul의 작은 테스트 세트datasets/test
datasets/test/test_clean: SVEN, SecCodePLT 및 Juliet의 테스트 데이터; 학습 세트에 포함되지 않은 OOD
CWE를 포함합니다datasets/test/test_primevul_pair: 원본 PrimeVul 테스트 데이터vulscan/data_process/data_utils/get_cwe_stat.py를 실행하여 데이터셋의 히스토그램을 얻을 수 있습니다| 데이터셋 | 언어 | 학습/테스트 | CWE | # 정상 | # 취약 | 평균 길이 |
|---|---|---|---|---|---|---|
| Clean (seccodeplt) | Python | 학습 | 20 | 1281 | 1281 | 741 |
| Clean (juliet) | C/C++ | 학습 | 22 | 1716 | 1653 | 3689 |
| Hard (primevul filtered) | C/C++ | 학습 | 26 | 2717 | 2952 | 4689 |
| Long Context (Oss-fuzz) | C/C++ | 학습 | 3 | 475 | 604 | 12761 |
| Simple (seccodeplt) | Python | 테스트 | 24 (6 ood) | 74 | 74 | 814 |
| Simple (juliet) | C/C++ | 테스트 | 38 (14 ood) | 358 | 376 | 2575 |
| Hard (PrimeVul, SecLLMHolmes) | C/C++ | 테스트 | 13 (5 ood) | 145 | 152 | 4545 |
| Long Context (Oss-fuzz) | C/C++ | 테스트 | 3 (0 ood) | 0 | 320 | 18929 |
| primevul test (noisy) | C/C++ | 테스트 | 56 (34 ood) | 421 | 422 | 5341 |
데이터셋을 구축한 후, 학습 세트에 대한 추론 데이터를 생성합니다.
DeepSeek-r1 및 QwQ 추론 모델을 쿼리하여 추론 데이터를 생성하고, 추론 체인이 매우 긴 데이터는 걸러냅니다.
추론 데이터 생성 코드는 vulscan/data_process/generate_reasoning에 있으며, 추론 데이터는
datasets/reasoning_data에 저장됩니다.
cd vulscan/data_process/generate_reasoning
generate_reasoning/generate.py는 추론 데이터를 생성하는 주요 스크립트입니다.
각 데이터 포인트에 대해 n개의 추론 데이터 샘플을 생성하고, 정답이 맞으면서 길이가 가장 짧은 샘플을 선택합니다.
QwQ 및 DeepSeek-r1 모델로 실행하는 예시는 다음과 같습니다 (공식 API보다 느리지만 더 안정적인 together.AI API 사용):
python generate.py \
--tp 2 \
--dataset_type clean_dataset \
--batch_size 200 \
--n 8 \
--training_set train \
--model_name Qwen/QwQ-32B

# or
python generate.py \
--dataset_type noisy_dataset \
--batch_size 200 \
--n 8 \
--training_set small_train \
--model_name together-deepseek-reasoner \
--together_deepseek
원시 추론 데이터를 생성한 후, 다른 모델을 사용하여 구조를 깨지 않으면서 요약하여 더 짧게 만들 수도 있습니다
python extract_reasoning.py
generate_reasoning/filter.py를 사용하여 특정 길이에 따라 추론 데이터를 추가로 필터링할 수 있습니다.
num_processes는 CPU 코어 수에 따라 변경합니다.
python filter.py \
--dataset_type noisy_dataset \
--training_set small_train \
--model_name Qwen/QwQ-32B \
--filter_input_length 16000 \
--filter_all_length 32000 \
--num_processes 16 \
--filter_correct_only # for filtering wrong predictions
# --model_name together-deepseek-reasoner \
마지막으로, 학습할 대상 모델(Qwen-Instruct)에 맞게 생성된 추론 데이터를 재구성해야 합니다.






