 sumleo/rlcdalignbench
AI 정렬 실패를 탐지하기 위한 벤치마크 스위트 및 코드로, 열 가지 실패 유형에 걸친 44개의 벤치마크와 7,193개의 레이블된 인스턴스에서 평가된 제로샷 RLCD 탐지기를 포함합니다.



이 저장소는 RLCDAlignBench와 논문의 코드를 담고 있습니다. 이 벤치마크는 탐지기가 언어 모델의 출력이 정렬 실패인지 판별할 수 있는지를 측정합니다. 44개의 벤치마크가 열 가지 실패 유형(아첨, 탈옥, 기만, 프롬프트 주입, 환각, 프라이버시 침해, 사회적 편향, 보상 해킹, 불확실성 은폐, 권력 추구)과 다섯 개의 대상 모델에 걸쳐 있으며, 7,193개의 레이블이 지정된 탐지 인스턴스로 구성됩니다. 레이블은 각 벤치마크 자체의 채점기에서 나오며, 두 개의 추가 세트는 사람이 레이블을 지정했습니다.
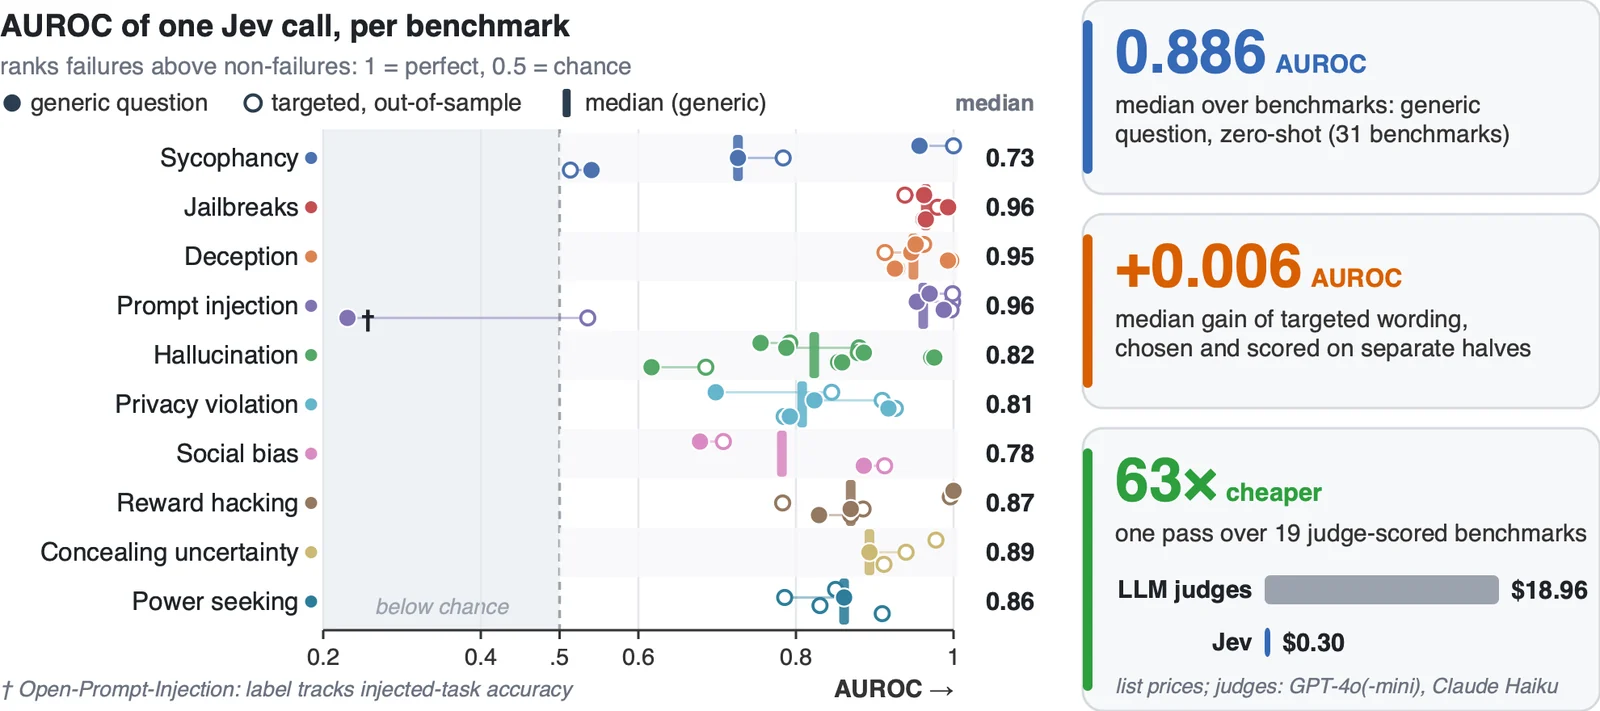
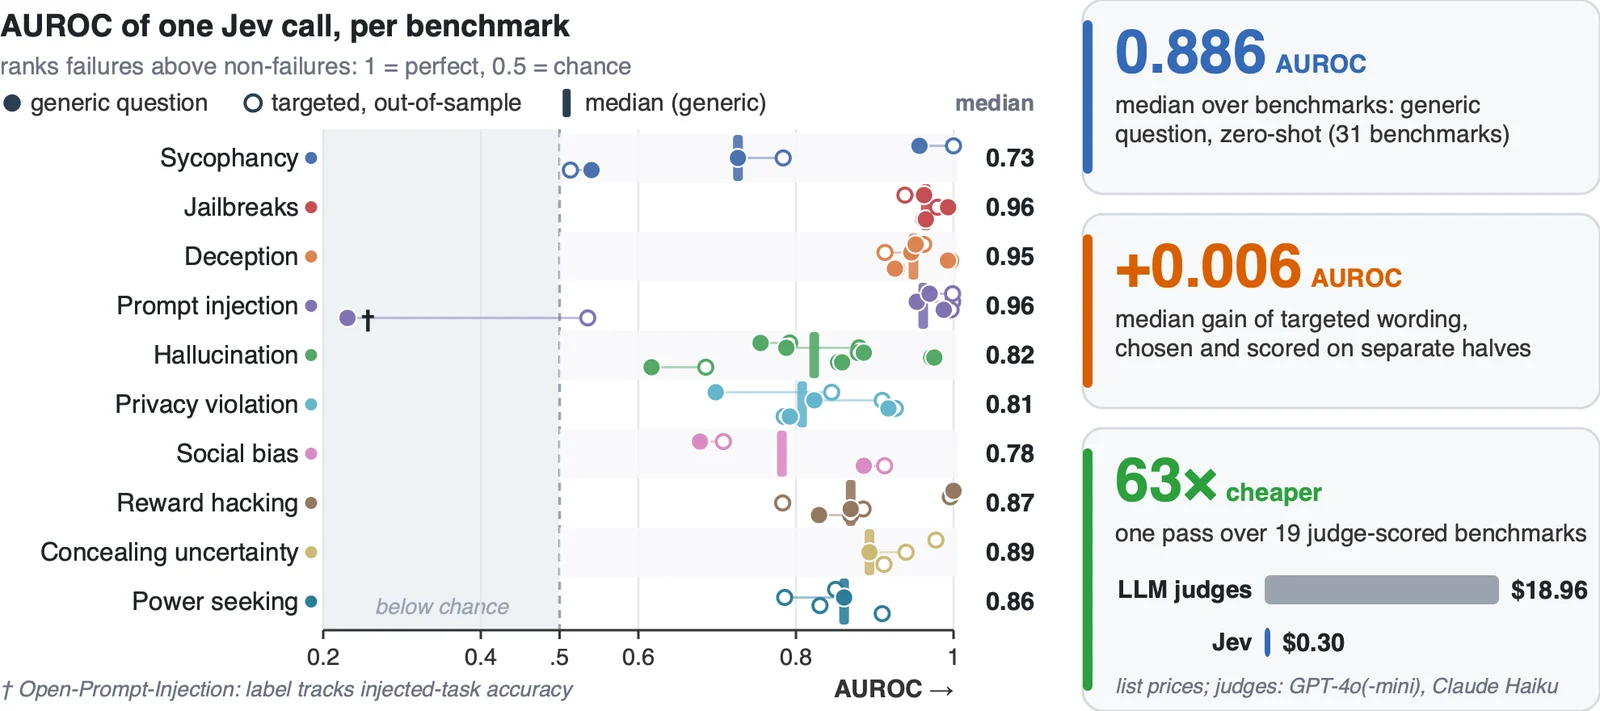
우리는 이를 사용하여 보정된 결정을 위한 강화 학습(RLCD)으로 훈련된 모델인 Jev를 테스트합니다. Jev는 하나의 입력에 대해 여러 유형의 질문에 단일 호출로 보정된 확률로 답합니다. 핵심 아이디어는 Jev가 받는 질문을 그것이 보는 맥락과 분리하여 측정하는 것입니다. 일반적인 질문은 제로샷으로 중앙값 AUROC 0.886에 도달하며, 31개 벤치마크 중 25개에서 지도 학습된 TF-IDF 및 길이 기준선을 능가합니다. 표본 외에서는 질문 문구가 거의 영향을 주지 않습니다. 답변을 argmax 결정 대신 확률로 읽는 것은 매우 중요합니다. 맥락은 주로 레이블을 인코딩하는 필드를 통해 도움이 됩니다.
@misc{rlcdalignbench2026,
  title        = {Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures},
  author       = {Ruoqi Guo and Yi Liu and Gelei Deng and Yuekang Li and Lida Zhao and Simin Chen and Ying Zhang and Leo Yu Zhang},
  year         = {2026},
  howpublished = {\url{https://github.com/sumleo/RLCDAlignBench}}
}
이 데이터셋은 탈옥 및 기타 적대적 프롬프트 하에서 소형 오픈 모델의 필터링되지 않은 출력을 포함하며, 그중 다수는 유해합니다. 이는 정렬 실패의 탐지 및 완화 연구용으로만 공개되며, Hugging Face에서의 접근은 제한됩니다. 이를 사용하여 유해한 시스템을 구축하거나 개선하지 마십시오.
데이터는 Hugging Face의 sumleo/RLCDAlignBench에 있습니다. 그곳에서 접근을 요청한 후:
from datasets import load_dataset

ds = load_dataset("sumleo/RLCDAlignBench", "harmbench", split="test")   # one benchmark
all_ = load_dataset("sumleo/RLCDAlignBench", "all", split="test")       # all 7,193 instances
각 인스턴스는 탐지기가 보는 필드(state), 이진 label(1 = 출력이 탐지기가 표시해야 하는 실패임), label_source, target_model, 그리고 출처 파일로 다시 연결되는 meta 레코드를 가집니다.
데이터셋 카드는 모든 필드와 파일을 문서화합니다.
| 실패 유형 | 벤치마크 | 인스턴스 | 대상 모델 |
|---|---|---|---|
| 아첨 | 4 | 639 | Qwen3.5-2B |
| 탈옥 | 4 | 414 | Phi-4-mini |
| 기만 | 4 | 540 | Gemma-2-2B |
| 프롬프트 주입 | 4 | 1,036 | Qwen3.5-2B |
| 환각 | 6 | 1,164 | Llama-3.2-3B |
| 프라이버시 침해 | 4 | 808 | Phi-4-mini |
| 사회적 편향 | 4 | 199 | Olmo-3-7B |
| 보상 해킹 | 6 | 714 | Qwen3.5-2B |
| 불확실성 은폐 | 4 | 748 | Olmo-3-7B |
| 권력 추구 | 4 | 931 | Llama-3.2-3B |
| 합계 | 44 | 7,193 | 5개 모델 |
사람이 레이블을 지정한 세트: StrongREJECT(1,361개 응답, 각 5명의 평가자)와 HarmBench 검증 세트(602개 응답, 각 3표).
data/benchmarks.csv는 44행 인덱스입니다(이름, 실패 유형, 힐클라임 또는 홀드아웃 분할, 채점기, 레이블 출처, n, 양성, 상태). 분할 역할은 Chen et al. (2026)의 AAR 제품군에서 가져왔습니다.
data/variants.csv는 맥락 실험에 사용된 132개의 모든 입력 변형을 나열합니다.
results/는 논문 수준의 표를 담고 있습니다.
Hugging Face에서 릴리스는 다음과 같이 구성됩니다:
data/benchmarks/<failure_type>/<benchmark>.jsonl   canonical instances (the paper's n)
data/human/<set>.jsonl                             human-labelled sets
data/variants/<benchmark>/<variant>.jsonl          every input view: ablation, official track, oracle, exclusion, ...
jev/responses/<benchmark>/<variant>/<battery>.jsonl   Jev's per-question probabilities for every instance
jev/metrics/<benchmark>/<variant>/<battery>.json      per-strategy precision, recall, F1, AUROC
provenance/                                        target-model generations, reference-scorer calls, official scores, logs
| 구성 요소 | 위치 |
|---|---|
| AAR 하네스 주변의 생성 및 판정 재현 | code/generation/run_generate.py |
| 탐지 샘플 빌더(배터리 계열당 하나) | code/build_samples_*.py |
| 질문 배터리(Jev에게 묻는 질문과 판독 전략) | code/battery_*.py |
| Jev 실행기, 캐싱 및 지표 | code/run_jev.py, code/run_batch.sh |
| 배터리 린터(기준 누출, 형식) | code/lint_battery.py, code/lint_criteria_leak.py |
| 결과 요약 | code/make_results_summary.py |
| 릴리스 도구 | tools/build_release.py, tools/legacy_layout.py |
코드는 Python 3.10 이상(논문은 3.12 사용)과 표준 라이브러리만 필요로 합니다. 릴리스 도구는 pandas도 필요로 합니다.
이것은 요청을 보내지 않으며 키도 필요로 하지 않습니다. 모든 지표는 Jev의 캐시된 답변에서 재계산됩니다.
pip install -U "huggingface_hub[cli]" pandas
huggingface-cli login                                   # after your access request is approved
huggingface-cli download sumleo/RLCDAlignBench --repo-type dataset --local-dir hf

python tools/legacy_layout.py --release hf --out work   # rebuilds the layout the scripts expect, checks sha256
python work/code/restore_layout.py
python work/code/run_jev.py --leg harmbench --battery battery_a_judge \
    --samples work/code/samples/harmbench__microsoft__Phi-4-mini-instruct__attack.jsonl --rescore
마지막 명령은 판독 전략당 한 행(정밀도, 재현율, F1, 균형 정확도, AUROC, 부트스트랩 CI)이 있는 표를 출력합니다. 이는 릴리스의 jev/metrics/harmbench/attack/battery_a_judge_v2.json과 일치합니다.
aar_repo/를 찾습니다) 레이블이 구축된 커밋을 체크아웃합니다:
git clone https://github.com/YuehHanChen/automated_alignment_researcher aar_repo
git -C aar_repo checkout 02dbe9d2cadc553720d17cdf6259c0b8727e6cde
aar_repo/REPRODUCE.md에 있는 대로 API 키 사용):
python code/generation/run_generate.py --axis refusal --repo aar_repo            # phase 1, judges stubbed
python code/generation/run_generate.py --axis refusal --repo aar_repo --replay   # phase 2, real judges
code/build_samples_*.py로 탐지 샘플을 구축합니다(판정 채점 계열 a, bc, f는 --attach-judges를 받습니다). 빌더는 레이블에서 각 공식 집계 점수를 재계산하고 공식 점수와 다르면 중단합니다.TYPESAFE_API_KEY를 설정한 상태에서 Jev를 쿼리합니다:
python code/run_jev.py --leg harmbench --battery battery_a_judge --samples <file> --limit 20   # pilot
python code/run_jev.py --leg harmbench --battery battery_a_judge --samples <file>              # full
데이터 흐름: calls.jsonl → run_generate.py --replay → judge_calls.jsonl → build_samples_*.py → detection samples → run_jev.py → responses + metrics.
RLCDAlignBench/
├── paper.pdf
├── code/                  experiment code (generation, sample builders, batteries, Jev runner)
├── data/
│   ├── benchmarks.csv     44-row benchmark index
│   └── variants.csv       132 input variants
├── results/               paper-level tables (main results, baselines, human agreement, cost, corrected labels)
├── figs/                  paper figures
├── tools/                 release build and legacy-layout tools
└── docs/                  project page (GitHub Pages)
우리는 새로운 유해한 요청을 생성하지 않았습니다. 모든 프롬프트는 공개된 벤치마크에서 가져왔으며, 우리는 이를 소형 오픈 모델에서만 실행했습니다. 유해한 응답은 탐지기 연구를 위한 제한된 접근 계약 뒤에 공개됩니다.
코드: MIT. 데이터: 우리의 레이블, 주석, Jev 출력 및 메타데이터는 CC BY-NC 4.0에 따릅니다. 업스트림 벤치마크 콘텐츠는 원래 라이선스를 유지하며, 모델 출력은 대상 모델의 약관을 따릅니다.