
 siquanhuang/detectvit
백도어가 삽입된 Vision Transformer를 위한 학습 불필요, 트리거 비의존적 테스트 시점 탐지기로, 헤드 간 어텐션 일관성과 엔트로피 분산을 활용하여 오염된 샘플을 식별합니다.

Siquan Huang1, Yijiang Li2, Xingfu Yan3,*, Ningzhi Gao1, Leyu Shi1, Ying Gao1,*
1사우스차이나 공과대학 2캘리포니아 대학교 샌디에이고 3사우스차이나 사범대학
*교신저자


Vision Transformer(ViT)는 대부분의 멀티모달 모델의 시각 인코더이며, 실무자들은 백도어가 포함되어 있을 수 있는 제3자 사전 학습 체크포인트를 기반으로 일상적으로 시스템을 구축합니다. DetectViT는 모델의 출력이나 임베딩 대신 어텐션 헤드를 읽어들이는 ViT용 테스트 시점 백도어 샘플 탐지기입니다.
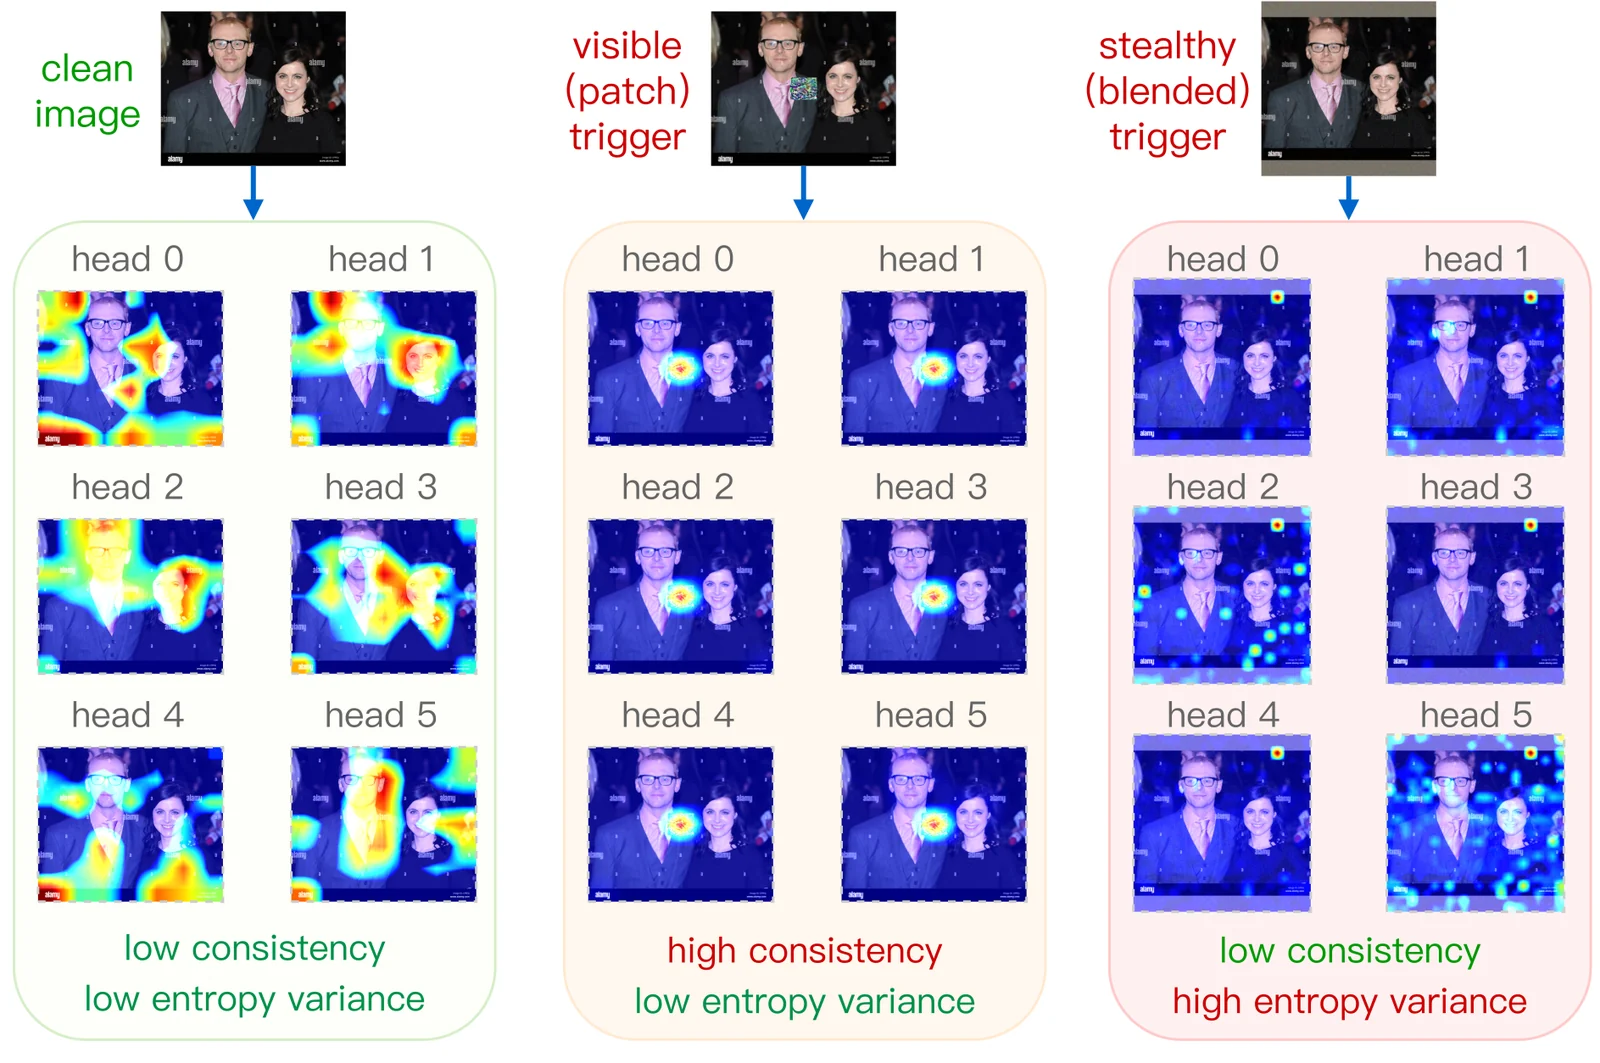
깨끗한 이미지에서 어텐션 헤드들은 서로 다른 영역에 비슷한 집중도로 주목합니다. 백도어 트리거는 두 가지 방식으로 이 균형을 깨뜨립니다:
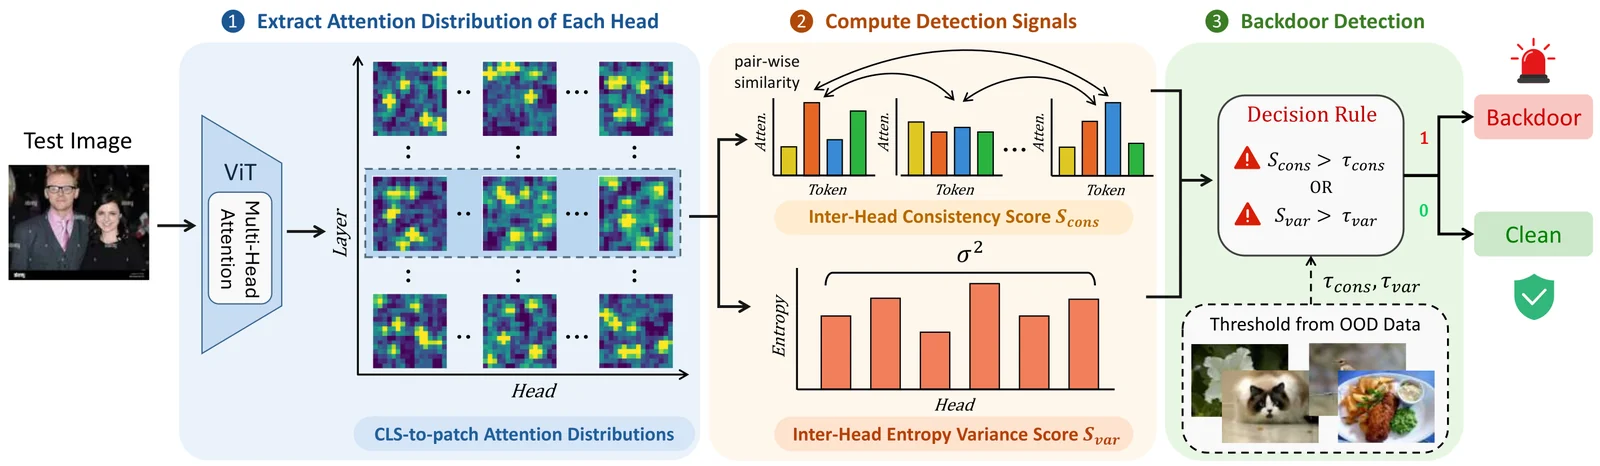
DetectViT는 모든 헤드의 CLS-대-패치 어텐션 분포를 추출하고 두 가지 상호 보완적인 신호를 계산합니다:
임계값은 임의의 소스에서 얻은 단 64~128장의 깨끗한 분포 외 이미지로부터 3시그마 규칙 $\tau = \mu + 3\sigma$을 사용하여 추정됩니다. 테스트 샘플은 $\mathcal{S}{\text{cons}} > \tau{\text{cons}}$ 또는 $\mathcal{S}{\text{var}} > \tau{\text{var}}$인 경우 백도어로 표시됩니다.
네 가지 ViT 백도어 공격에 대한 탐지 성능. TPR과 FPR은 % 단위이며, AUC는 [0, 1] 척도입니다. "–"는 해당 방법이 적용 불가능하거나(레이블 기반 방법은 자유 형식 캡션을 처리할 수 없음) 연속적인 점수를 산출하지 못함을 의미합니다.
| 방어 기법 | BadViT TPR↑ / FPR↓ / AUC↑ | TrojViT TPR↑ / FPR↓ / AUC↑ | BadCLIP TPR↑ / FPR↓ / AUC↑ | BadVision TPR↑ / FPR↓ / AUC↑ |
|---|---|---|---|---|
| TeCo | 77.95 / 61.86 / 0.63 | 55.00 / 51.76 / 0.51 | 99.20 / 39.52 / 0.89 | – |
| Scale-Up | 88.65 / 30.66 / 0.81 | 85.00 / 41.98 / 0.74 | 91.84 / 65.03 / 0.66 | – |
| PatchProc | 90.61 / 18.42 / 0.89 | 87.60 / 21.44 / 0.85 | 86.97 / 26.78 / 0.82 | – |
| DeDe | 63.97 / 23.29 / 0.78 | 50.20 / 25.80 / 0.72 | 55.12 / 27.97 / 0.69 | 7.00 / 29.68 / 0.50 |
| BackdoorIDS | 80.79 / 9.73 / – | 5.00 / 10.84 / – | 93.24 / 16.88 / – | 96.00 / 15.96 / – |
| DetectViT | 100.00 / 1.58 / 1.00 | 90.80 / 5.94 / 0.95 | 100.00 / 0.17 / 1.00 | 96.00 / 3.00 / 0.99 |
추가 공격. 자기지도 인코더(BadEncoder, DRUPE), 클린 레이블 포이즈닝(Label-Consistent), 주파수 영역 트리거(Low-Frequency), 최적화된 전역 트리거(Blended-Optimized)를 아우르는 다섯 가지 추가 공격에서 DetectViT는 모든 공격에 대해 AUC 0.97 이상을 유지하는 유일한 방법입니다. 전체 결과는 논문 부록에 있습니다.
실행 시간. 샘플당 평균 탐지 시간(s):
| 방어 기법 | BadViT | TrojViT | BadCLIP | BadVision |
|---|---|---|---|---|
| TeCo | 2.5094 | 4.2920 | 1.8448 | – |
| Scale-Up | 0.0246 | 0.0261 | 0.0696 | – |
| PatchProc | 0.6686 | 0.6926 | 0.8257 | – |
| DeDe | 0.0206 | 0.0279 | 0.1034 | 0.6060 |
| BackdoorIDS | 0.1734 | 0.1982 | 0.2560 | 3.3458 |
| DetectViT | 0.0124 | 0.0134 | 0.0163 | 0.0226 |
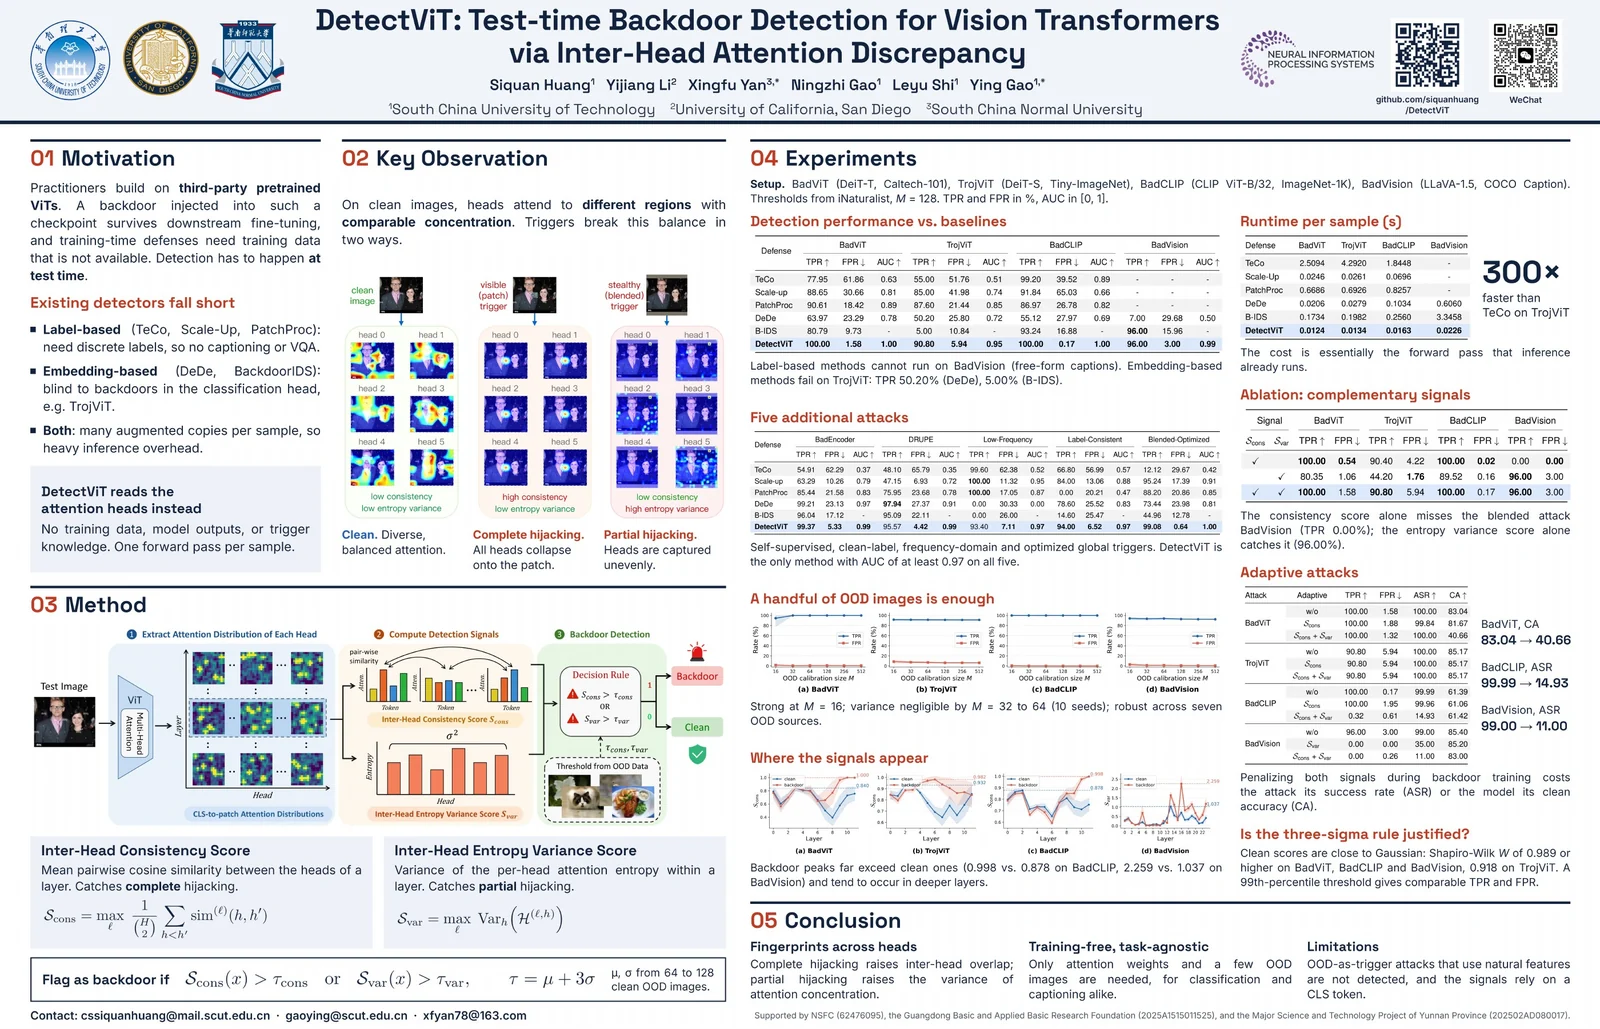
이미지를 클릭하면 전체 해상도 PDF가 열립니다.
git clone https://github.com/siquanhuang/DetectViT.git
cd DetectViT
Google Drive에서 사전 학습된 백도어 모델 체크포인트와 최적화된 트리거를 다운로드하세요:
탐지 방법은 detectvit.py에 구현되어 있습니다. 각 공격에 대해 DetectViT를 평가하려면 main.py를 실행하세요.
python3 main.py \
  --defense DetectViT \
  --attack_type badvit \
  --trojvit_attack_dir TrojViT/logs/Caltech101_DeiT-T_target0_BadViT \
  --trojvit_network DeiT-T \
  --trojvit_num_classes 102 \
  --trojvit_data_dir ./data
python3 main.py \
  --defense DetectViT \
  --attack_type trojvit \
  --trojvit_attack_dir TrojViT/logs/Tiny-ImageNet_DeiT-S_target2_TrojViT \
  --trojvit_data_dir ./data/tiny-imagenet-200 \
  --trojvit_network DeiT-S \
  --gpu 0
python3 -u main.py \
  --defense DetectViT \
  --attack_type badclip \
  --gpu 0 \
  --eval_data_type ImageNet1K \
  --eval_test_data_dir BadCLIP/data/ImageNet1K/validation/ \
  --add_backdoor \
  --asr \
  --label banana \
  --patch_type ours_tnature \
  --patch_location middle \
  --patch_name BadCLIP/opti_patches/tnature_eda_bs64_ep50_32_middle_01_05_pos_neg.jpg \
  --patch_size 32
python3 -u main.py \
  --defense DetectViT \
  --attack_type badvision \
  --gpu 0
| 인자 | 설명 | 기본값 |
|---|---|---|
--defense | 탐지 방법 (DetectViT, DeDe, BackdoorIDS, ...) | DetectViT |
--attack_type | 평가할 공격 (badvit, trojvit, badclip, badvision) | — |
--gpu | GPU 장치 ID | 0 |
이 작업이 유용하다고 생각되시면, 저희 논문을 인용해 주시기 바랍니다.
@misc{huang2026detectvittesttimebackdoordetection,
      title={DetectViT: Test-time Backdoor Detection for Vision Transformers via Inter-Head Attention Discrepancy},
      author={Siquan Huang and Yijiang Li and Xingfu Yan and Ningzhi Gao and Leyu Shi and Ying Gao},
      year={2026},
      eprint={2611.23770},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2611.23770},
}
이 프로젝트는 다음 오픈소스 작업물을 기반으로 합니다. 코드를 공개해 주신 저자분들께 진심으로 감사드립니다:






