

B2B 소프트웨어 공급업체 평가 스킬 for Claude Code — 도메인 전문가 질문, 공급업체 AI 에이전트 대화, 증거 기반 점수 매기기

B2B 소프트웨어 구매를 위한 AI 분석가.
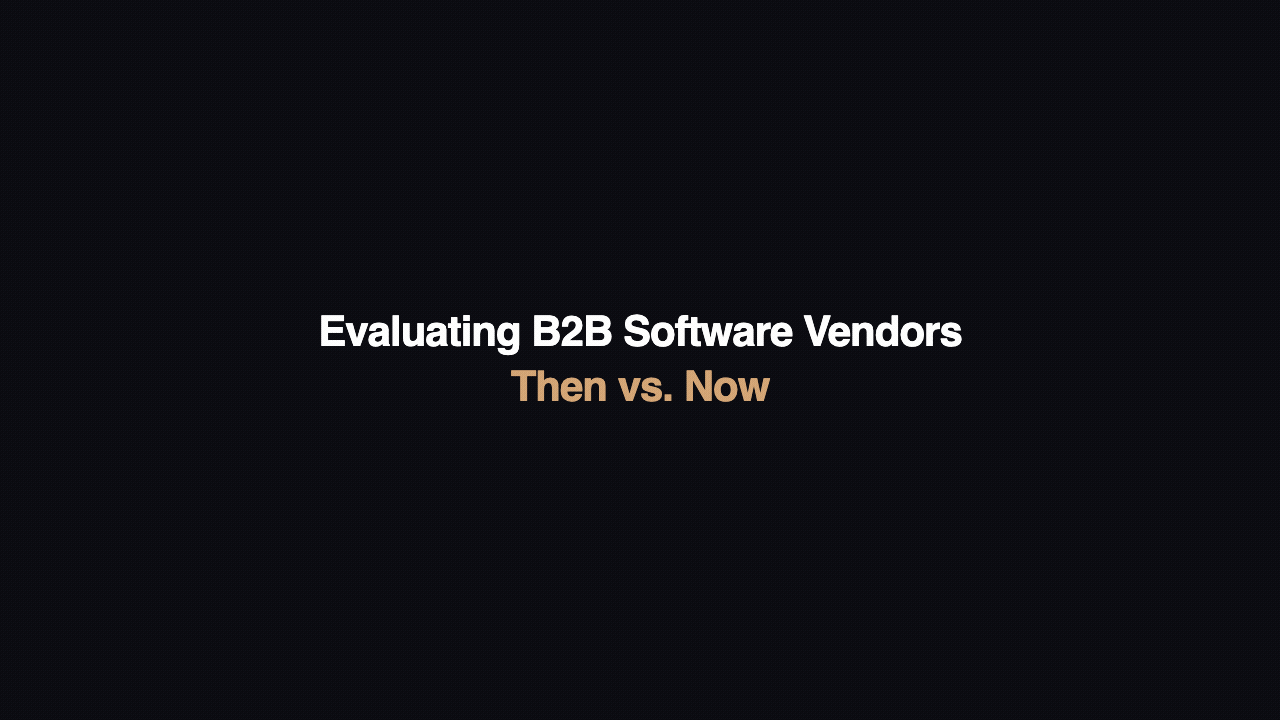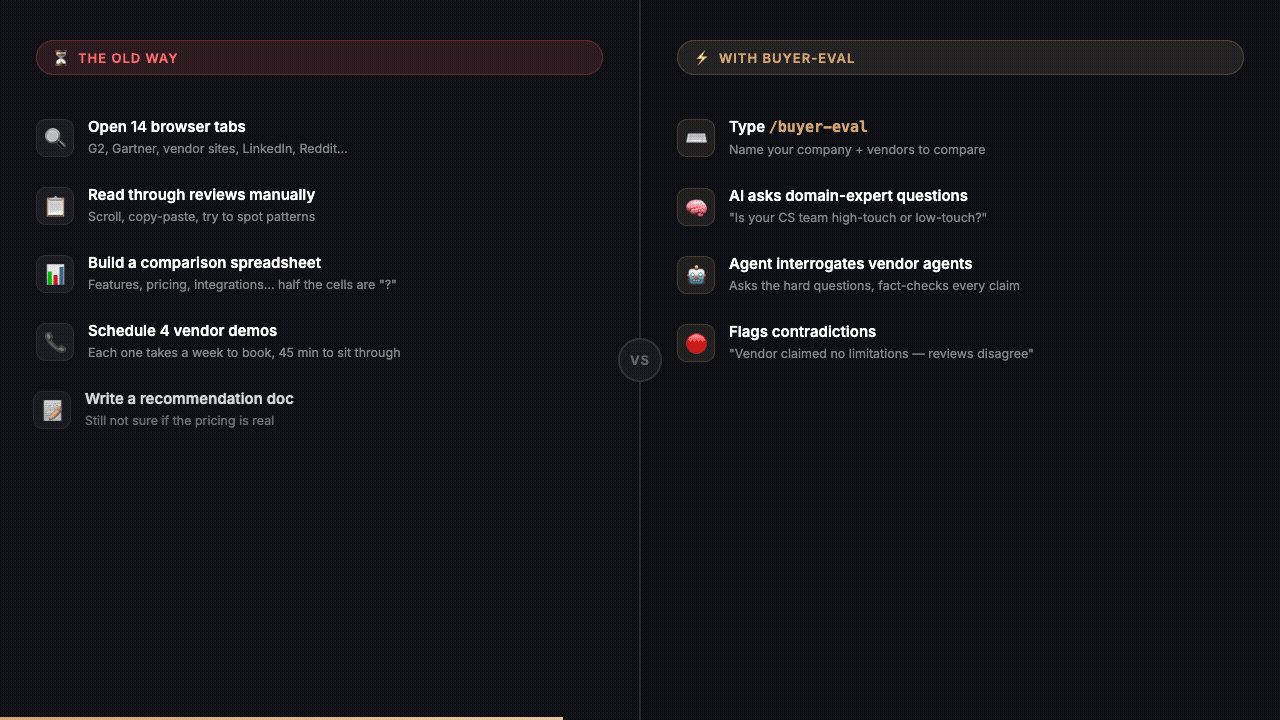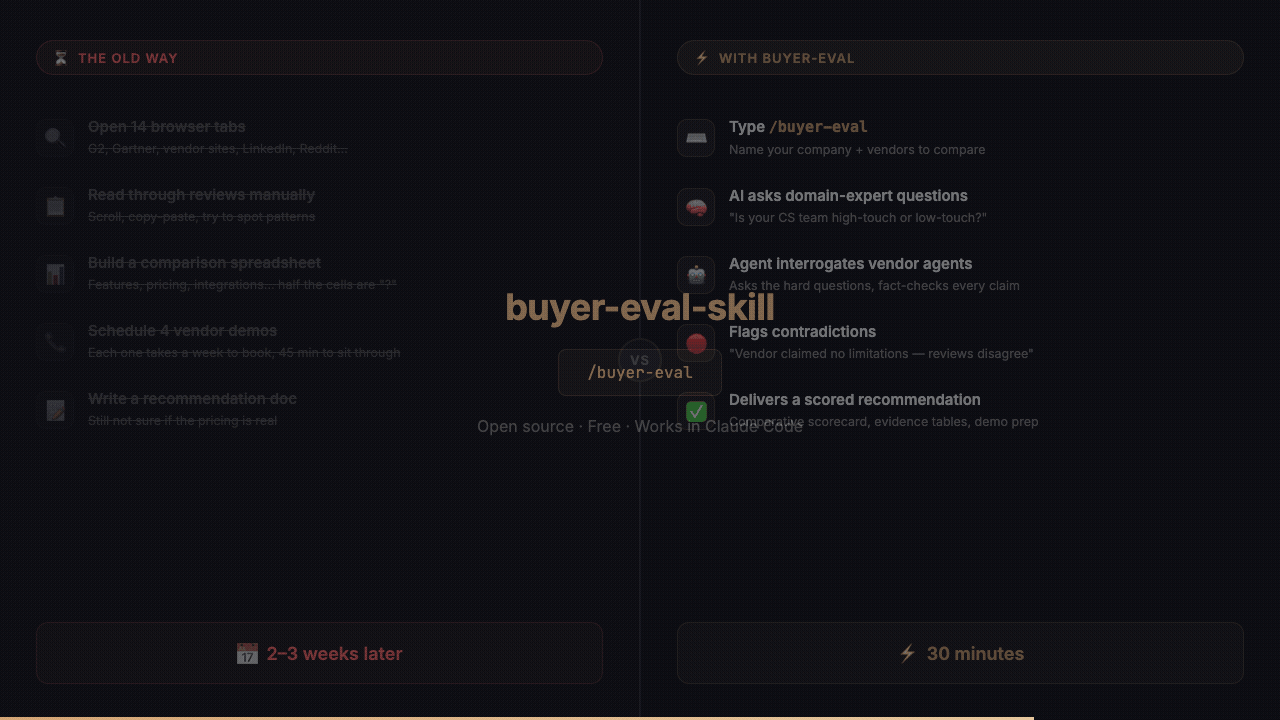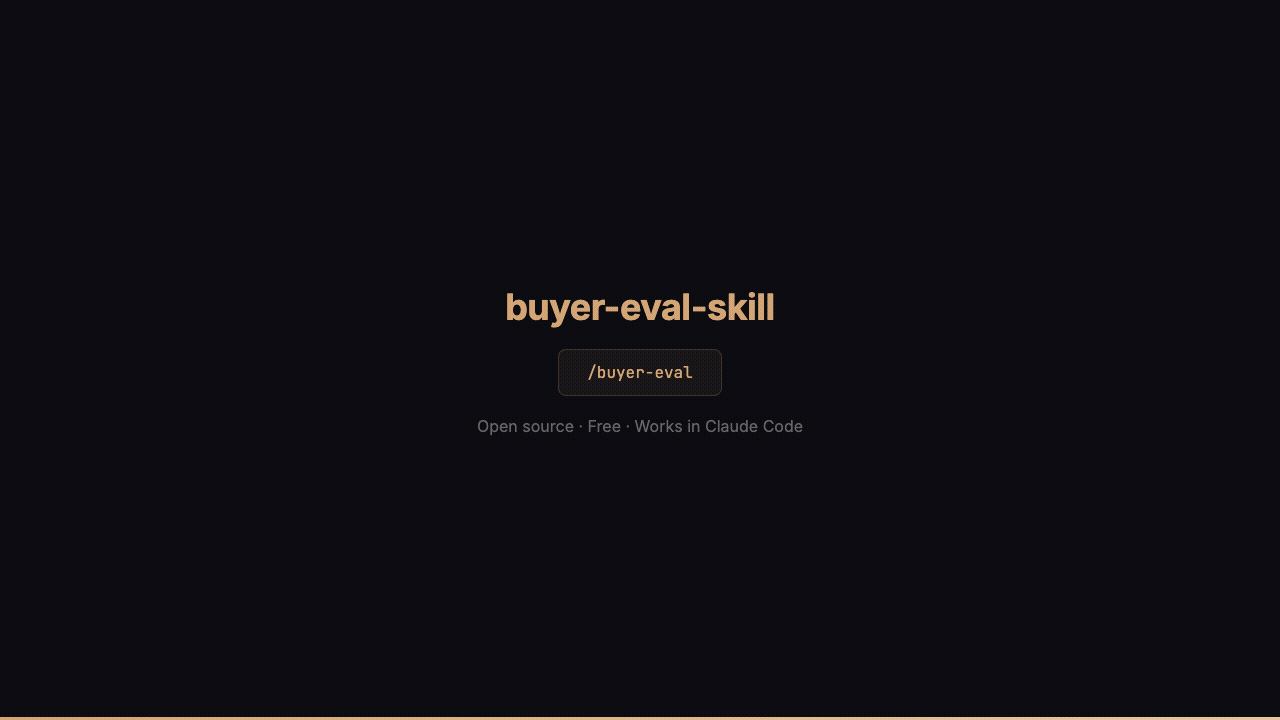
고려 중인 벤더들을 알려주세요. Buyer Eval은 그들이 주장하는 내용을 조사하고, 증거를 확인하며, 공백과 모순을 찾아내고, 구매 전에 물어봐야 할 질문을 제시합니다. 구매에 관여하는 모든 사람에게 전달할 수 있는 Decision Brief를 받게 됩니다.
You:  Evaluate Vendor A and Vendor B for customer success. We need deep
      Salesforce sync and we can't wait 6 months to go live.
몇 분 후:
What we found: 8 claims investigated. 3 verified, 2 qualified, 1 contradicted, 1 unverified, 1 unknown.
Most important finding: Vendor B's "live in 6 weeks" claim is contradicted by two customer accounts describing 4-6 month rollouts.
Most important unknown: Whether either vendor syncs custom Salesforce objects both ways without professional services.
Ask next: Ask Vendor A to show a custom object syncing both ways, live.
가상의 벤더를 사용한 예시입니다. 전체 예시 Decision Brief를 참조하세요.
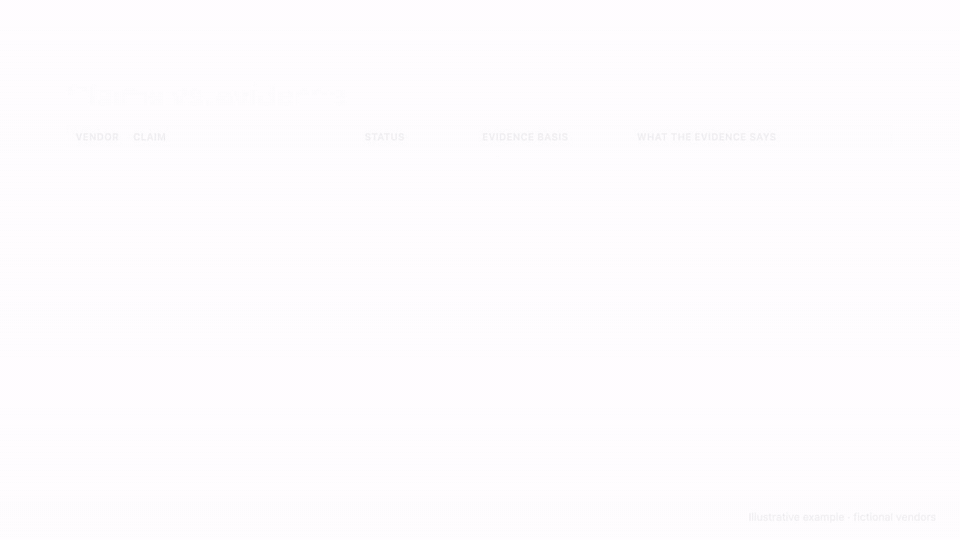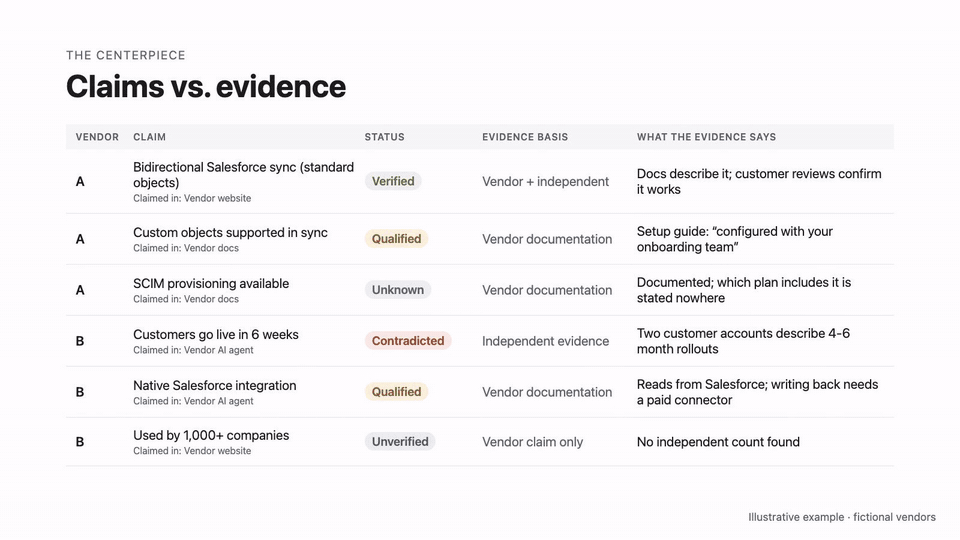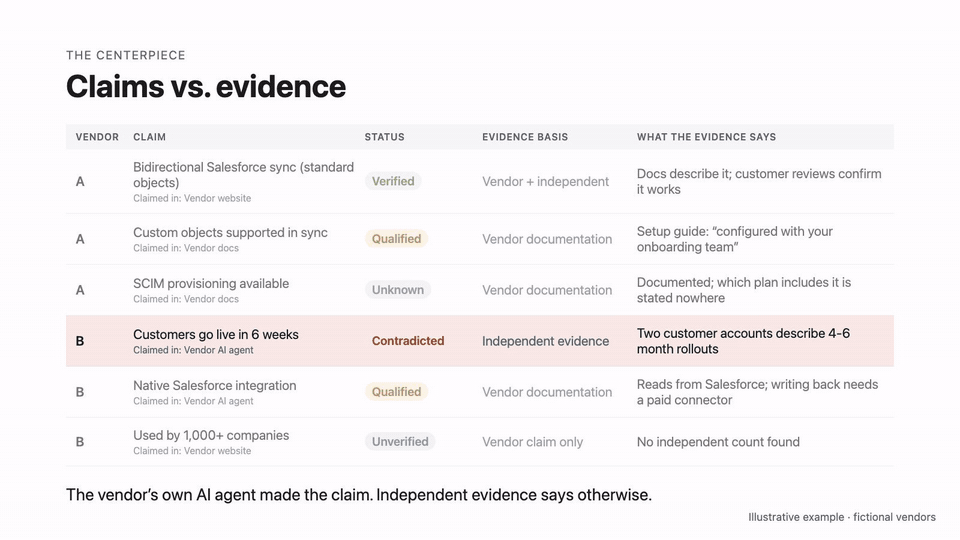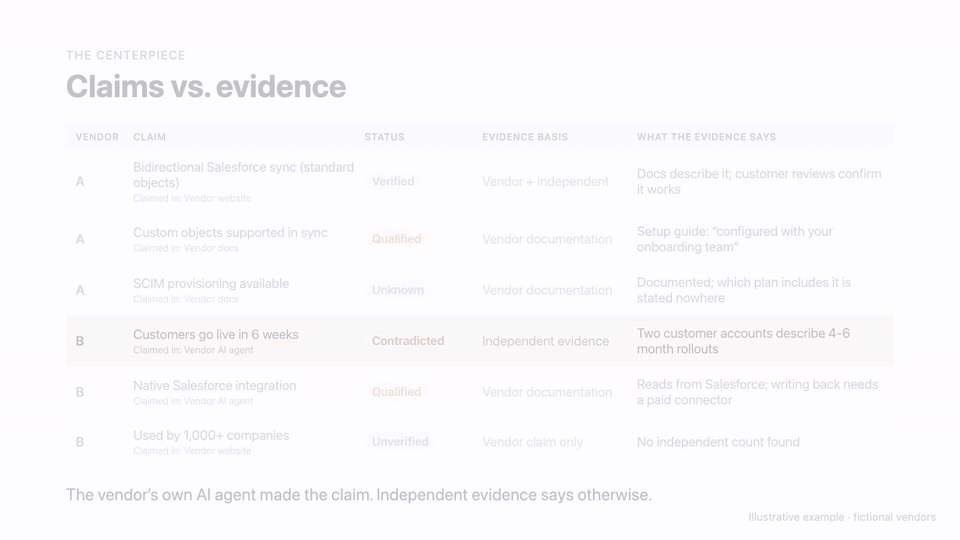
70초 내레이션 데모 보기 (예시).
Quick Eval (기본). 벤더 이름을 지정하고, 선택적으로 가장 중요한 2-3가지를 알려주세요. 설정 인터뷰 없음. 나머지는 추론하고 추론한 내용에 라벨을 붙입니다. 단일 벤더 또는 짧은 목록에 적합합니다.
Deep Eval (요청 시). 전체 실사: why-now 및 요구사항 발견, 구매자 조사, 하드 제약 조건, 카테고리별 전문가 질문, 더 긴 벤더 AI 에이전트 대화, 보안, 상업적, 회사 위험 조사, 가중치 1-5 점수, 그리고 귀하의 증거(제안서, 가격, 데모 노트, 설문지)를 위한 공간. 사전에 또는 Quick Eval 후에 요청하세요.
| Evidence | Examples | Can verify |
|---|---|---|
| Vendor claim | Website, marketing, vendor AI agent answers | Nothing on its own |
| Vendor evidence | Docs, trust/security pages, public pricing, contract terms | Narrow, self-describing facts (an API exists, a certificate is held) |
| Independent evidence | Customer reviews and accounts, analysts, press, community, third-party docs | Capabilities and outcomes |
| Your evidence | Proposals, quotes, RFP answers, demo notes, trial results | What was offered to you |
벤더 AI 에이전트는 1차 출처입니다. 일부 벤더는 구매자 질문에 답하는 AI 에이전트를 공개하며, 이 스킬을 유지 관리하는 회사인 Salespeak에 구축된 에이전트도 포함됩니다. Buyer Eval은 그러한 에이전트에 질문할 수 있으며, 이를 통해 더 구체적인 답변을 얻고 후속 질문이 가능합니다. 답변은 벤더 주장으로 취급됩니다. 에이전트가 있다고 해서 벤더의 적합성, 신뢰도, 점수가 개선되는 경우는 결코 없으며, 모든 벤더의 주장은 동일한 기준으로 확인됩니다.
git clone https://github.com/salespeak-ai/buyer-eval-skill.git ~/.claude/skills/buyer-eval-skill
프로젝트별로 대신: .claude/skills/buyer-eval-skill에 클론하세요.
Claude Code 또는 Claude 데스크톱 앱에서 평범한 언어로 요청하세요:
Evaluate Vendor A and Vendor B for our customer success platform
또는 /buyer-eval-skill로 직접 호출하세요. 전체 실사의 경우 "deep eval"이라고
말하세요.
| Claude Code | Claude desktop | claude.ai web/mobile | |
|---|---|---|---|
| Research and brief | Yes | Yes | Yes |
| Vendor AI agent conversations | Yes | Yes | No (discovery only) |
| HTML Decision Brief, saved context | Yes | Yes | No |
보고서는 ~/buyer-eval-reports/에 작성됩니다.
실행 후 Buyer Eval은 재사용 가능한 구매 컨텍스트(회사, 규모, 시스템,
요구사항, 하드 제약 조건)를 ~/.salespeak/buyer-eval-profile.json에 저장하여
다음 평가에서 설정을 건너뛸 수 있습니다. 개인 이름, 벤더 인용문, 귀하의
문서는 결코 저장하지 않습니다. 귀하의 머신에 남아 있습니다.
python3 ~/.claude/skills/buyer-eval-skill/bin/profile.py show
python3 ~/.claude/skills/buyer-eval-skill/bin/profile.py clear
묻지 않고 귀하의 머신을 떠나는 것:
텔레메트리: 기본적으로 꺼짐, 한 번 질문. 첫 평가가 전달된 후 Buyer Eval은 익명화된 사용 데이터를 공유할지 한 번 질문합니다. 평가는 답변에 결코 의존하지 않습니다.
예라고 하면 전송되는 것: 벤더를 위해 생성된 질문, 벤더 도메인, 검증됨/미검증/모순됨 주장의 개수, 점수, 무작위 ID. 귀하의 이름, 이메일, 회사, 귀하에 대해 알려준 내용, 벤더 답변, 주장 또는 증거 텍스트, 귀하의 문서는 결코 전송하지 않습니다.
bin/track.py, 순수 Python, 서드파티 라이브러리 없음~/.salespeak/buyer-eval.logpython3 ~/.claude/skills/buyer-eval-skill/bin/track.py statuspython3 ~/.claude/skills/buyer-eval-skill/bin/track.py revoketrack.py show)를 이메일로 보내세요IT 관리자용. export BUYER_EVAL_NO_TELEMETRY=1로 모든 사람의 텔레메트리를
비활성화하거나, {"locked": true, "consent": false}를 포함하는
/etc/salespeak/buyer-eval.json을 배포하세요. 둘 중 하나는 사용자 동의를
재정의합니다. 방화벽에서 차단하는 것을 선호하는 경우 텔레메트리 엔드포인트는
https://22i9zfydr3.execute-api.us-west-2.amazonaws.com/prod/event_stream입니다.
각 실행은 더 새로운 버전을 확인하고(6시간 동안 캐시됨) 업데이트 전에 질문합니다.
버그, 요청, 또는 잘 처리하지 못하는 카테고리에 대해서는 이슈를 열어주세요.
MIT

