 salesforce/merlion
시계열 인텔리전스를 위한 엔드투엔드 Python 프레임워크로, 이상 탐지, 예측, 변경점 탐지, AutoML, 앙상블 및 벤치마킹 파이프라인을 제공합니다.


Merlion은 시계열 인텔리전스를 위한 Python 라이브러리입니다. 데이터 로딩 및 변환, 모델 구축 및 학습, 모델 출력 후처리, 모델 성능 평가를 포함하는 엔드투엔드 머신러닝 프레임워크를 제공합니다. 단변량 및 다변량 시계열 모두에 대해 예측, 이상 탐지, 변화점 탐지 등 다양한 시계열 학습 작업을 지원합니다. 이 라이브러리는 엔지니어와 연구자에게 특정 시계열 요구에 맞는 모델을 신속하게 개발하고 여러 시계열 데이터셋에서 벤치마킹할 수 있는 원스톱 솔루션을 제공하는 것을 목표로 합니다.
Merlion의 주요 기능은 다음과 같습니다.
DefaultDetector 및 DefaultForecaster 모델.아래 표는 Merlion의 주요 기능이 시계열 이상 탐지 및/또는 예측을 위한 다른 라이브러리와 어떻게 비교되는지 시각적으로 보여줍니다.
| Merlion | Prophet | Alibi Detect | Kats | darts | statsmodels | nixtla | GluonTS | RRCF | STUMPY | Greykite | pmdarima | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 단변량 예측 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | |||
| 다변량 예측 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| 단변량 이상 탐지 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | |||
| 다변량 이상 탐지 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| 전처리 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||
| 후처리 | ✅ | ✅ | ||||||||||
| AutoML | ✅ | ✅ | ✅ | |||||||||
| 앙상블 | ✅ | ✅ | ✅ | ✅ | ||||||||
| 벤치마킹 | ✅ | ✅ | ✅ | ✅ | ✅ | |||||||
| 시각화 | ✅ | ✅ | ✅ | ✅ | ✅ |
다음 기능은 Merlion 2.0에서 새로 추가된 것입니다:
| Merlion | Prophet | Alibi Detect | Kats | darts | statsmodels | nixtla | GluonTS | RRCF | STUMPY | Greykite | pmdarima | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 외생 변수 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ||||||
| 변화점 탐지 | ✅ | ✅ | ✅ | ✅ | ✅ | |||||||
| 클릭 가능한 시각적 UI | ✅ | |||||||||||
| 분산 백엔드 | ✅ | ✅ |
Merlion은 두 개의 하위 저장소로 구성됩니다: merlion은 라이브러리의 핵심 시계열 인텔리전스 기능을 구현하고, ts_datasets는 여러 시계열 데이터셋에 대한 표준화된 데이터 로더를 제공합니다. 이러한 로더는 시계열을 메타데이터와 함께 pandas.DataFrame으로 로드합니다.
PyPI에서 pip install salesforce-merlion을 호출하여 merlion을 설치할 수 있습니다. 소스에서 설치하려면 이 저장소를 클론하고 pip install Merlion/을 호출하거나, 편집 가능한 모드로 설치하려면 pip install -e Merlion/을 호출하십시오. 추가 종속성은 pip install salesforce-merlion[all]을 통해 설치하거나, 소스에서 설치하는 경우 pip install "Merlion/[all]"을 호출하여 설치할 수 있습니다.
선택적 종속성에는 개별적으로 GUI 대시보드용 dashboard, PySpark를 사용한 분산 컴퓨팅 백엔드용 spark, 모든 딥러닝 모델용 deep-learning이 포함됩니다.
데이터 로딩 패키지 ts_datasets를 설치하려면 이 저장소를 클론하고 pip install -e Merlion/ts_datasets/을 호출하십시오. 데이터 로더를 초기화할 때 모든 데이터셋의 루트 디렉터리를 수동으로 지정하고 싶지 않다면 이 패키지를 편집 가능한 모드(즉, -e 플래그 포함)로 설치해야 합니다.
다음 외부 종속성에 유의하십시오:
일부 예측 모델은 OpenMP에 의존합니다. conda를 사용하는 경우 패키지를 설치하기 전에 conda install -c conda-forge lightgbm을 실행하십시오. 그러면 conda 환경에서 OpenMP가 (우리 종속성 중 하나인) lightgbm 패키지와 함께 작동하도록 구성됩니다. Mac을 사용하는 경우 Homebrew를 설치하고 brew install libomp를 호출하여 모델에서 OpenMP 라이브러리를 사용할 수 있도록 하십시오.
일부 이상 탐지 모델은 JDK(Java Development Kit)에 의존합니다. Ubuntu의 경우 sudo apt-get install openjdk-11-jdk를 호출하십시오. Mac OS의 경우 Homebrew를 설치하고 brew tap adoptopenjdk/openjdk && brew install --cask adoptopenjdk11을 호출하십시오. 또한 java가 PATH에서 찾을 수 있고 JAVA_HOME 환경 변수가 설정되어 있는지 확인하십시오.
예제 코드와 Merlion 소개는 examples의 Jupyter 노트북과 여기의 안내형 둘러보기를 참조하십시오. 자세한 API 문서(예제 코드 포함)는 여기에서 찾을 수 있습니다. 기술 보고서는 Merlion의 전반적인 아키텍처를 설명하고 단변량 및 다변량 시계열에 대한 시계열 이상 탐지 및 예측의 실험 결과를 제시합니다.
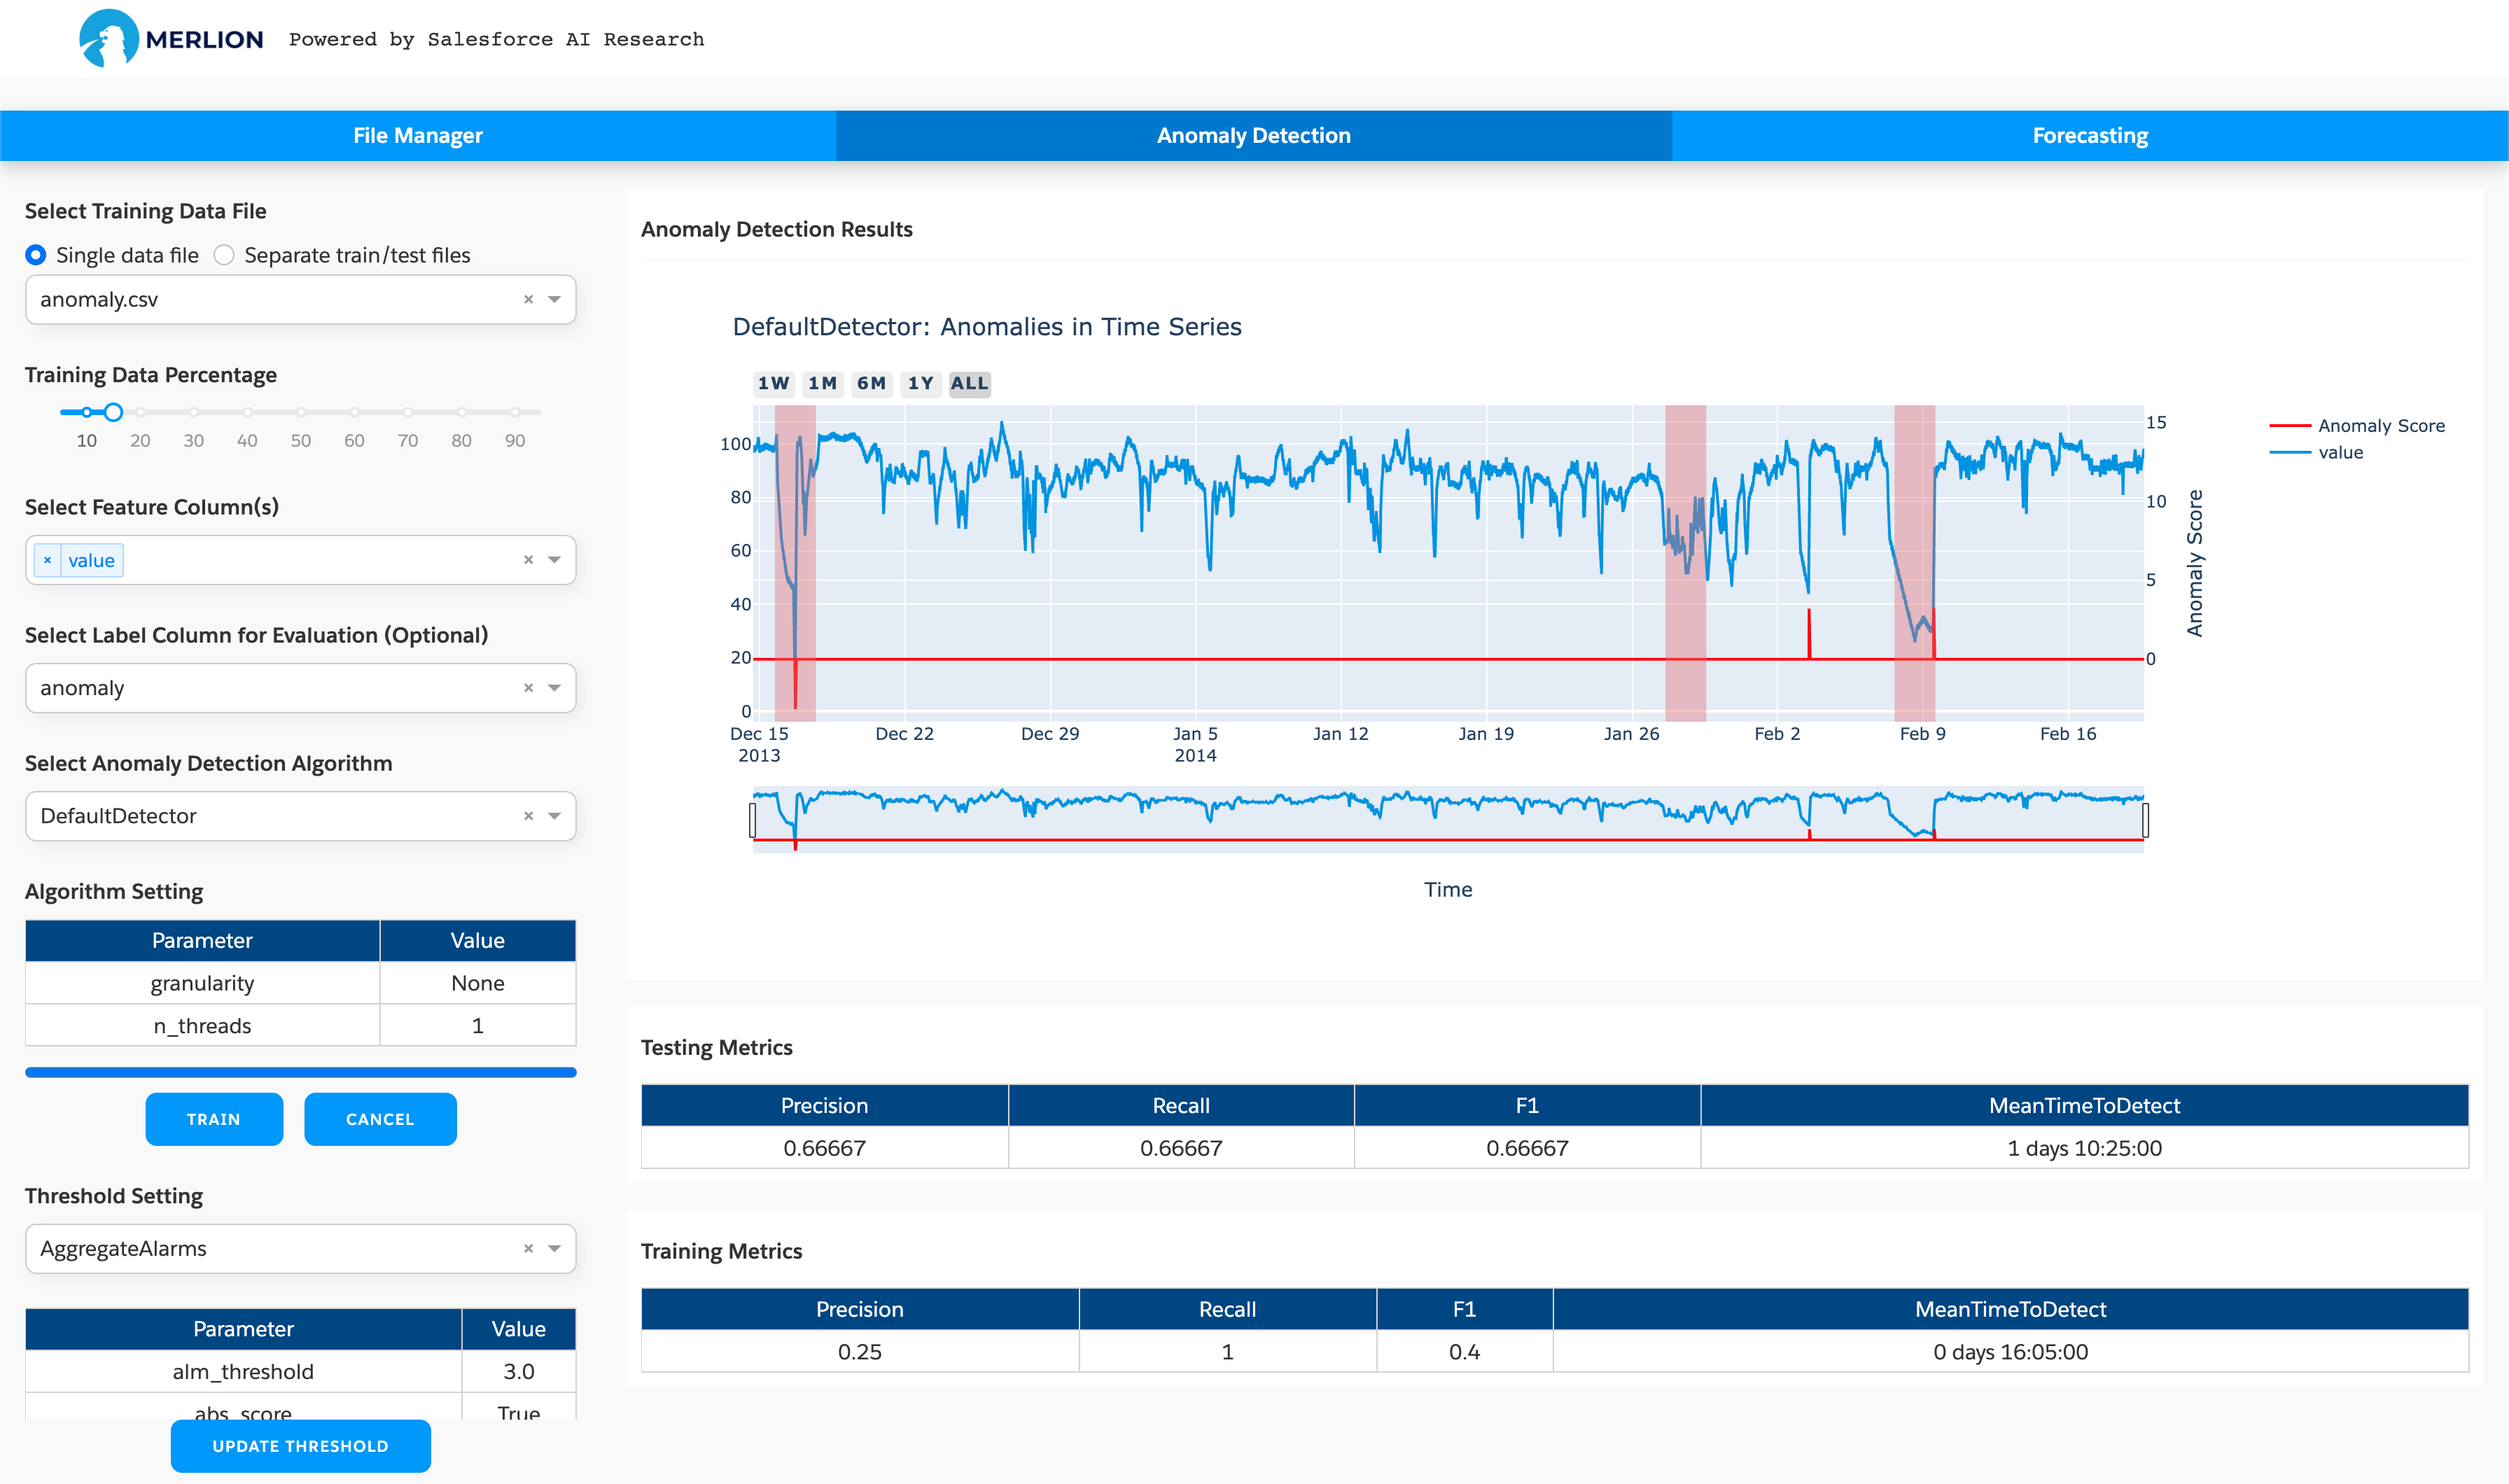
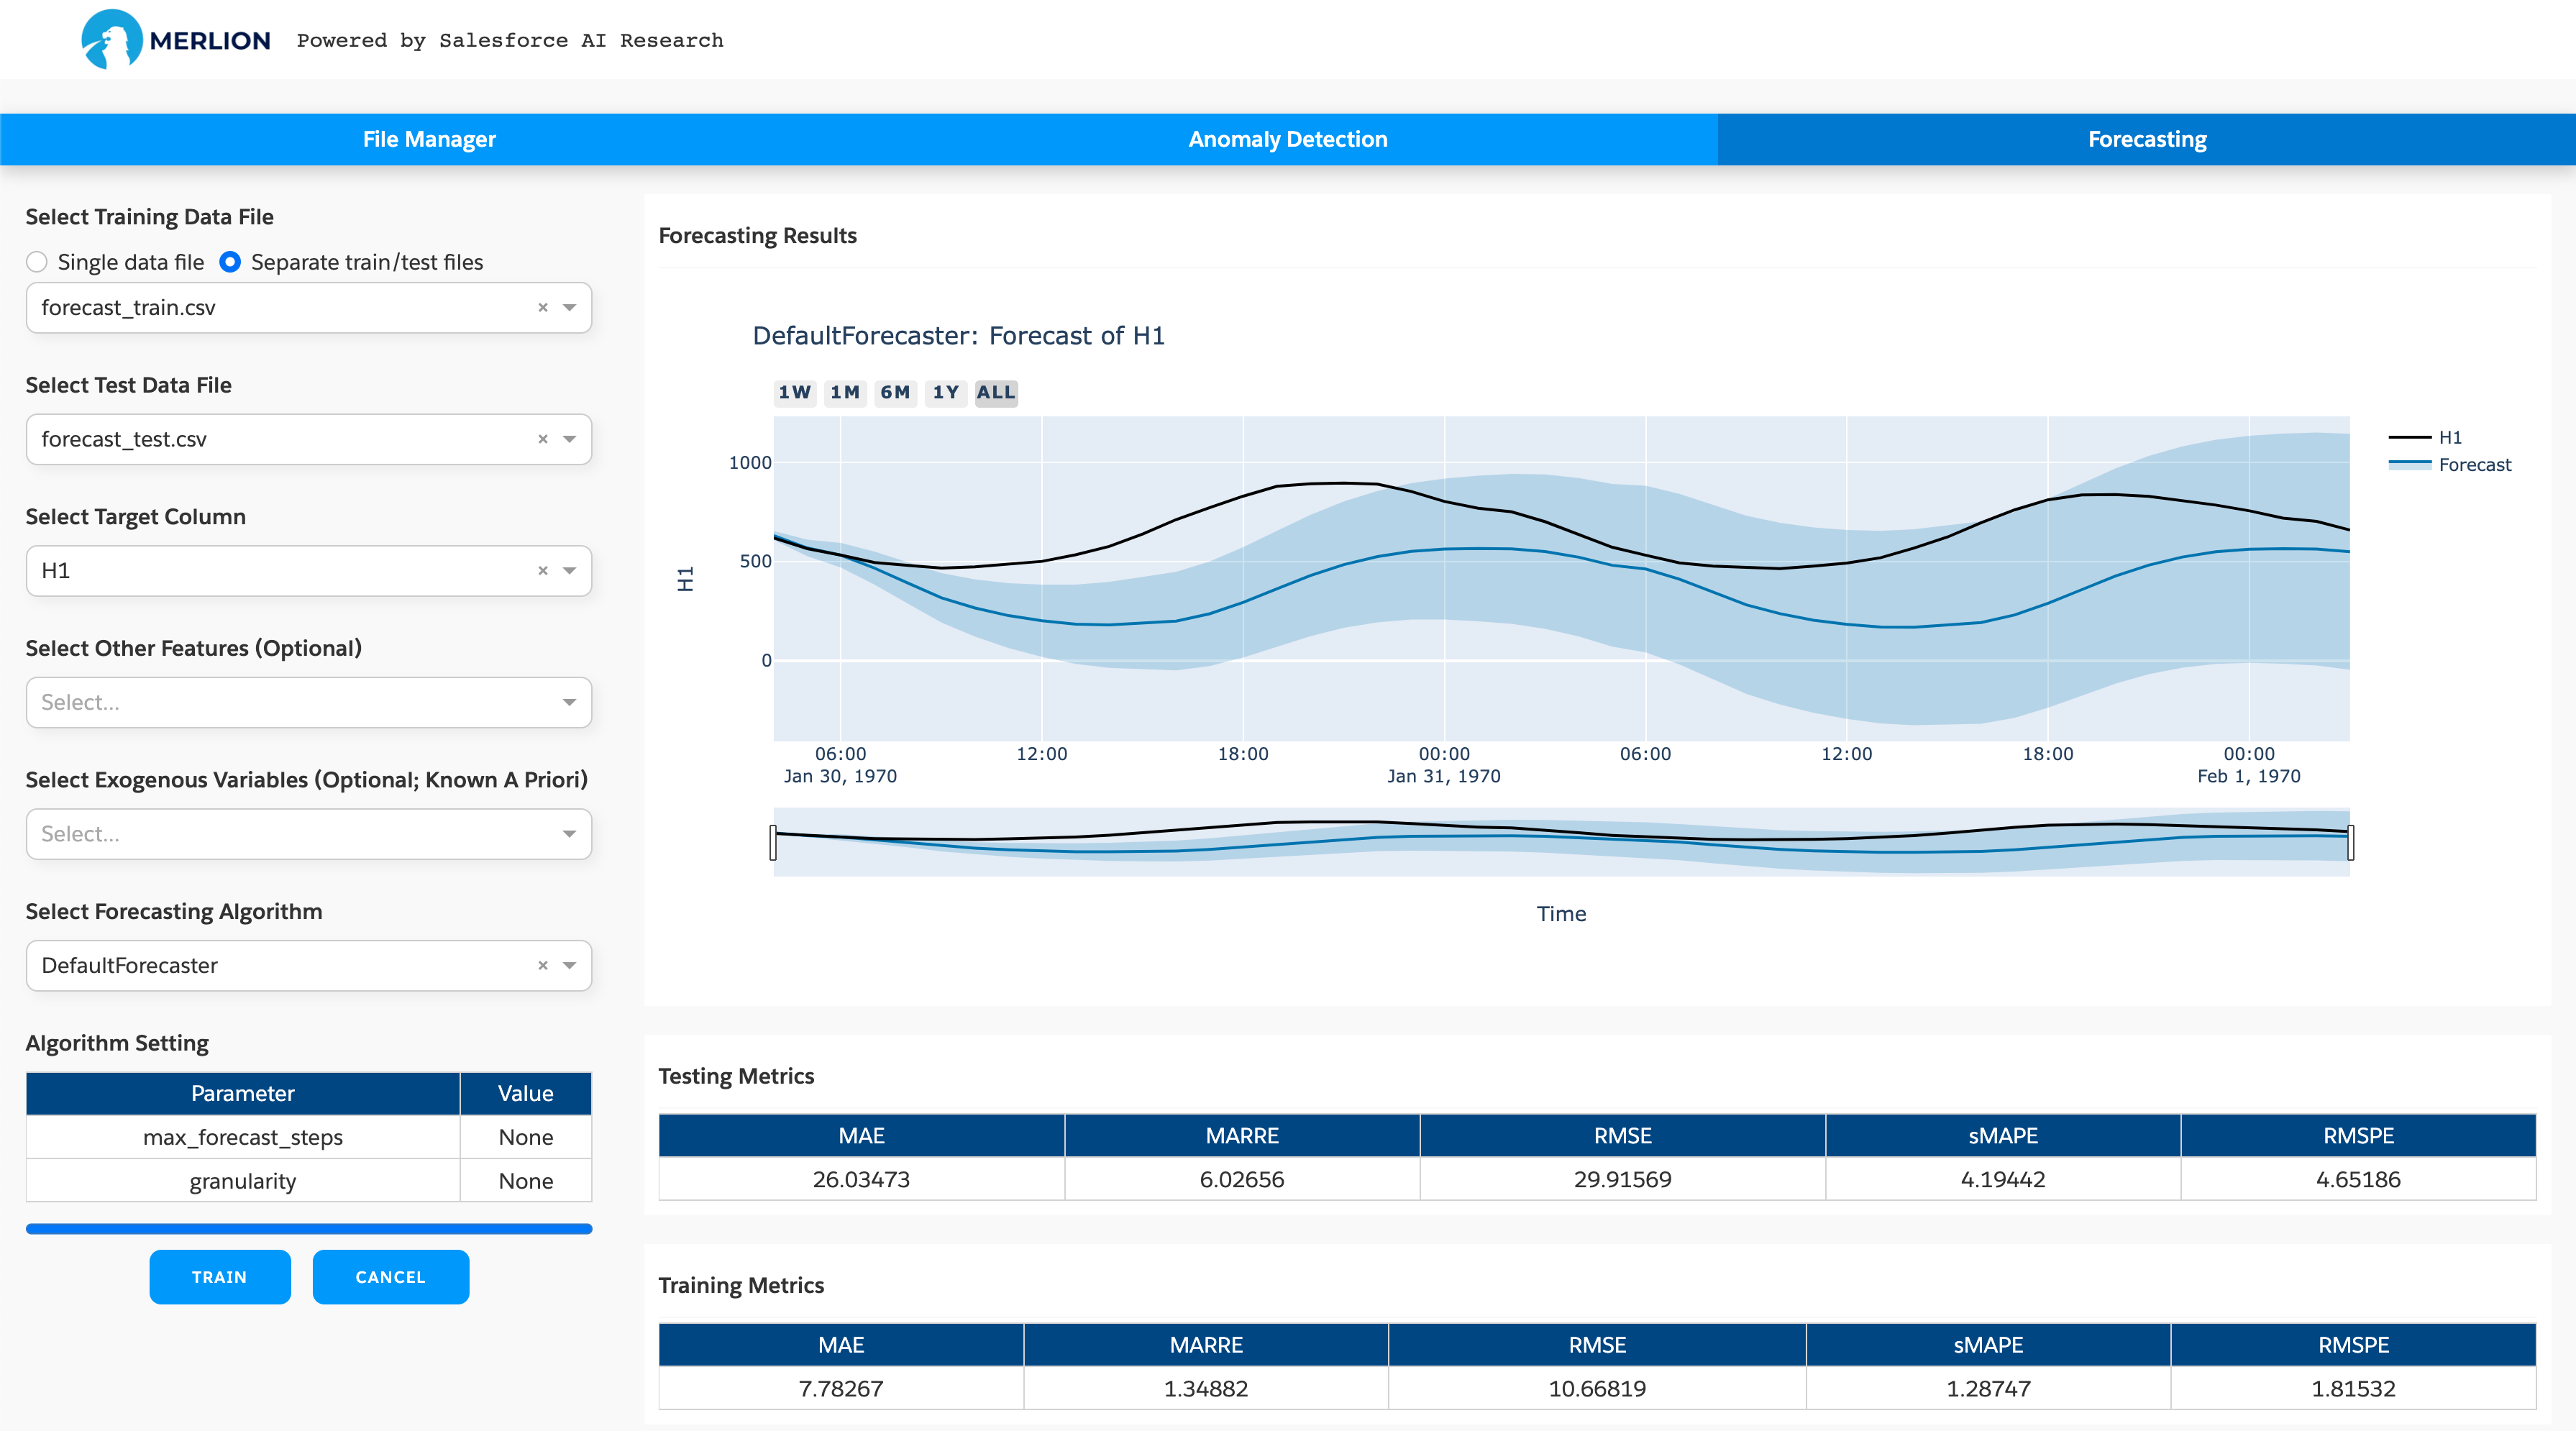
시작하는 가장 쉬운 방법은 GUI 웹 기반 대시보드를 사용하는 것입니다. 이 대시보드는 고유한 사용자 정의 데이터셋에서 많은 모델을 빠르게 실험할 수 있는 훌륭한 방법을 제공합니다. 사용하려면 선택적 dashboard 종속성을 사용하여 Merlion을 설치하고(즉, pip install salesforce-merlion[dashboard]), 명령줄에서 python -m merlion.dashboard을 호출하십시오. http://localhost:8050에서 대시보드를 볼 수 있습니다. 아래에는 이상 탐지와 예측 모두에 대한 대시보드 스크린샷을 보여줍니다.
고유한 코드에서 Merlion 사용을 시작하는 데 도움이 되도록, 이상 탐지와 예측 모두에 대해 Merlion 기본 모델을 사용하는 몇 가지 최소한의 예제를 아래에 제공합니다.
여기서는 위의 이상 탐지 대시보드의 결과를 재현하는 코드를 보여줍니다. Merlion의 TimeSeries 클래스와 Numenta Anomaly Benchmark NAB용 데이터 로더를 가져오는 것으로 시작합니다. 그런 다음 이 데이터셋의 특정 시계열을 학습 및 테스트 분할로 나눌 수 있습니다.
from merlion.utils import TimeSeries
from ts_datasets.anomaly import NAB

# 데이터 로더는 pandas DataFrame을 반환하며, 이를 Merlion TimeSeries로 변환합니다
time_series, metadata = NAB(subset="realKnownCause")[3]
train_data = TimeSeries.from_pd(time_series[metadata.trainval])
test_data = TimeSeries.from_pd(time_series[~metadata.trainval])
test_labels = TimeSeries.from_pd(metadata.anomaly[~metadata.trainval])
그런 다음 Merlion의 DefaultDetector를 초기화하고 학습시킬 수 있습니다. 이는 성능과 효율성의 균형을 맞추는 이상 탐지 모델입니다. 또한 테스트 분할에 대한 예측을 얻습니다.
from merlion.models.defaults import DefaultDetectorConfig, DefaultDetector
model = DefaultDetector(DefaultDetectorConfig())
model.train(train_data=train_data)
test_pred = model.get_anomaly_label(time_series=test_data)
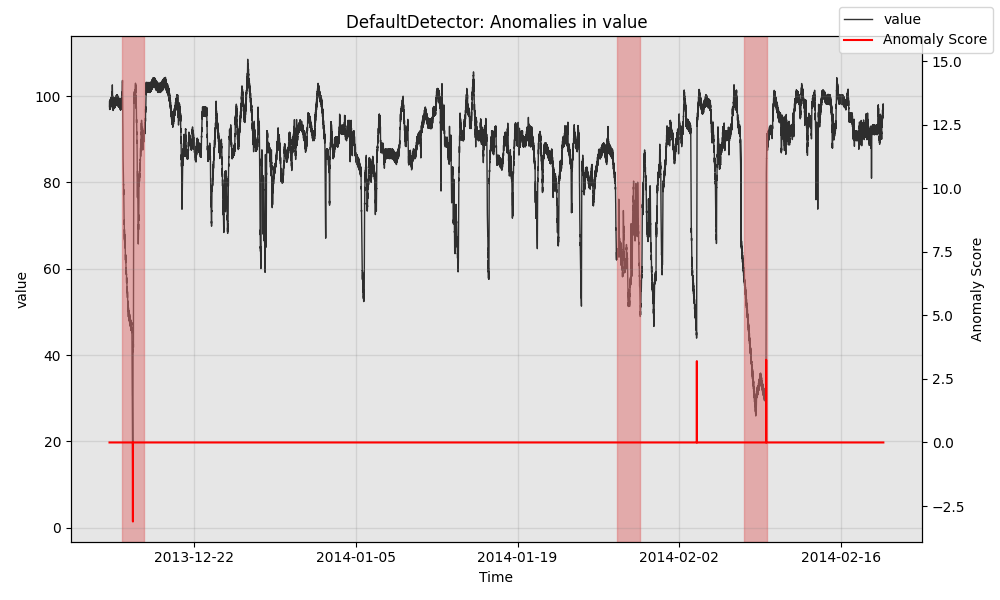
다음으로 모델의 예측을 시각화합니다.
from merlion.plot import plot_anoms
import matplotlib.pyplot as plt
fig, ax = model.plot_anomaly(time_series=test_data)
plot_anoms(ax=ax, anomaly_labels=test_labels)
plt.show()
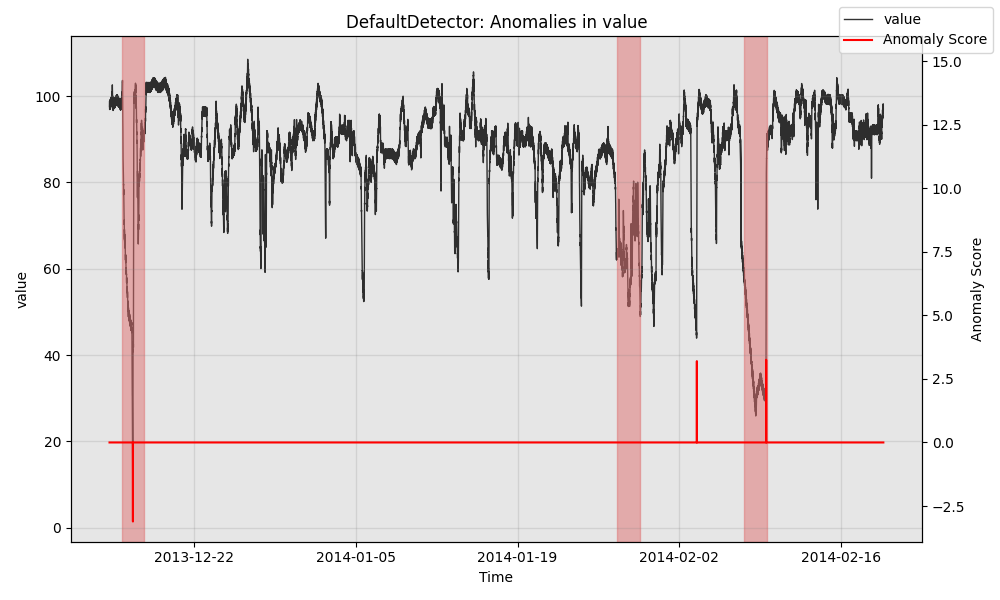
마지막으로 모델을 정량적으로 평가할 수 있습니다. 정밀도와 재현율은 모델이 3개의 알람을 발생시켰고, 그중 2개의 실제 양성(true positive), 1개의 실제 음성(false negative), 1개의 오탐(false positive)이 있었기 때문에 나온 값입니다. 또한 모델이 올바르게 탐지한 각 이상을 탐지하는 데 걸린 평균 시간도 평가합니다.
