 rodricios/wxpath
wxpath - XPath를 사용한 선언적 웹 크롤링; 웹 쿼리 언어 (WQL)


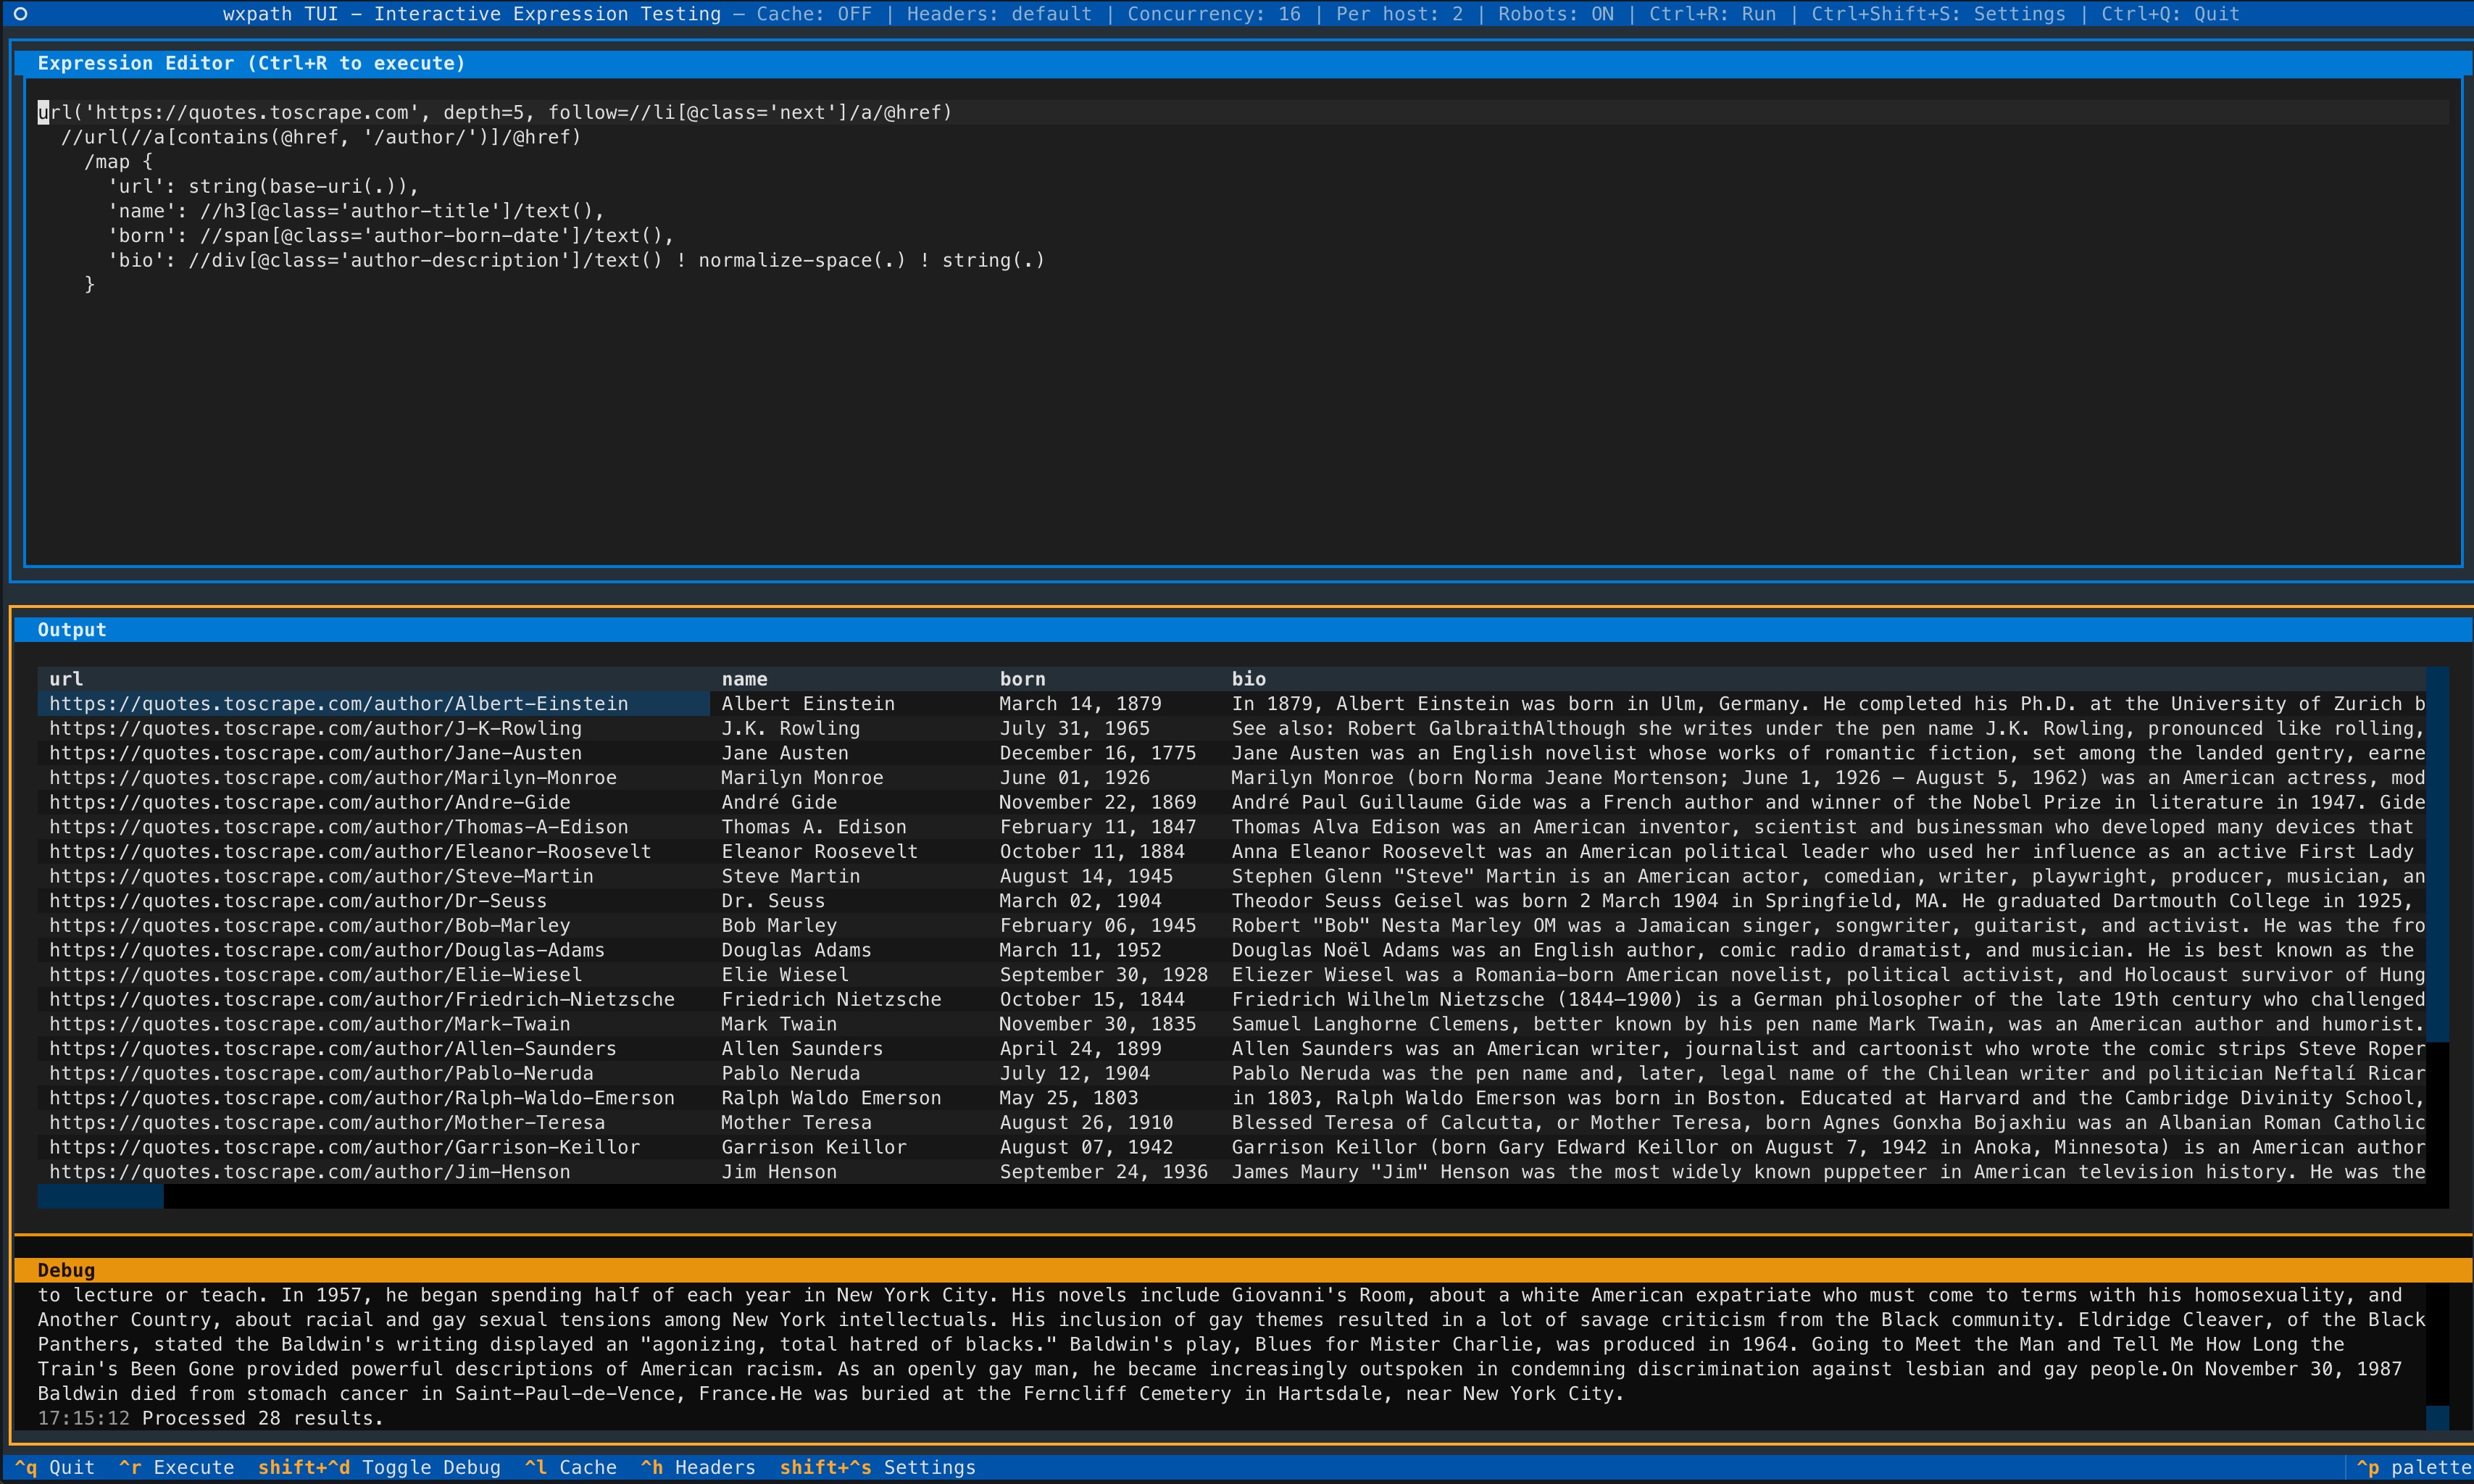
새로운 기능: TUI - wxpath 표현식을 테스트하고 데이터를 내보내기 위한 대화형 터미널 인터페이스(Textual 기반).
Python 3.10+ 필요.
pip install wxpath
# TUI 지원을 위해:
pip install "wxpath[tui]"
# uv를 통해 TUI 즉시 실행:
uvx --from "wxpath[tui]" wxpath-tui
wxpath는 탐색을 XPath로 직접 표현하는 선언형 웹 크롤러입니다. 명령형 크롤링 루프를 작성하는 대신, wxpath는 하나의 표현식에서 무엇을 따라갈지, 무엇을 추출할지 설명할 수 있습니다. wxpath는 해당 표현식을 동시에, 너비 우선(ish)으로 실행하고, 결과가 발견되는 대로 스트리밍합니다.
이 표현식은 페이지를 가져오고, 링크를 추출하며, 동시에 스트리밍합니다. 크롤링 루프가 필요 없습니다:
import wxpath

expr = "url('https://quotes.toscrape.com')//a/@href"

for link in wxpath.wxpath_async_blocking_iter(expr):
    print(link)
url(...) 연산자와 /// 구문을 도입함으로써 wxpath 엔진은 재귀적(또는 페이지네이션된) 웹 크롤링 및 추출을 수행할 수 있습니다:
import wxpath

path_expr = """
url('https://quotes.toscrape.com')
  ///url(//a/@href)
    //a/@href
"""

for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
    print(item)
대부분의 웹 스크래퍼는 먼저 크롤링 제어 흐름을 작성하고, 그 다음 추출을 작성하도록 강제합니다.
wxpath는 이 두 단계를 하나로 통합합니다:
그래프에서 깨끗하고 구조화된 JSON 계층을 직접 추출하세요. LLM에 신호를 공급하고 노이즈는 걸러냅니다. 자세한 내용은 LangChain 통합을 참조하세요.
wxpath는 결정론적입니다(참고: LLM 기반이 아님). 네트워크가 안정적이라고 보장할 수는 없지만, 탐색이 결정론적임은 보장할 수 있습니다.
문서는 현재 여기에서 확인할 수 있습니다.
url(...) 및 ///url(...) 설명import wxpath
from wxpath.settings import CRAWLER_SETTINGS
# 예의를 위한 사용자 정의 헤더; 일부 사이트(예: Wikipedia)에 필요함
CRAWLER_SETTINGS.headers = {'User-Agent': 'my-app/0.4.0 (contact: [email protected])'}
# 크롤링, 필드 추출, 지식 그래프 구축
path_expr = """
url('https://en.wikipedia.org/wiki/Expression_language')
///url(
//main//a/@href[
starts-with(., '/wiki/') and not(contains(., ':'))
]
)
/map{
'title': (//span[contains(@class, "mw-page-title-main")]/text())[1] ! string(.),
'url': string(base-uri(.)),
'short_description': //div[contains(@class, 'shortdescription')]/text() ! string(.),
'forward_links': //div[@id="mw-content-text"]//a/@href ! string(.)
}
"""
for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
print(item)
참고: 일부 사이트(Wikipedia 포함)는 적절한 헤더가 없으면 요청을 차단할 수 있습니다.
사용자 정의 User-Agent 설정은 고급: 엔진 및 크롤러 구성을 참조하세요.
위 표현식은 다음을 수행합니다:
https://en.wikipedia.org/wiki/Expression_language에서 시작합니다.<main> 섹션의 링크 중 /wiki/로 시작하고 콜론(:)을 포함하지 않는 링크를 필터링합니다.url(...) 및 ///url(...) 설명url(...)은 사용자가 지정하거나 내부적으로 생성된 URL의 콘텐츠를 가져와서 추가 XPath 처리를 위해 lxml.html.HtmlElement로 반환하는 사용자 정의 연산자입니다.///url(...)은 심층 크롤링을 나타냅니다. 런타임 엔진에게 지정된 max_depth까지 링크를 계속 따라가라고 지시합니다. 반복적인 url() 홉과 달리, 단일 표현식으로 더 깊은 그래프 탐색을 설명할 수 있습니다. 경고: 크롤링 폭발을 방지하기 위해 제약 조건(max_depth 또는 XPath 조건자)을 사용하여 주의해서 사용하세요.언어 설계에 대한 자세한 내용은 DESIGN.md를 참조하세요. 핵심 개념과 언어를 처음부터 설계하는 과정을 확인할 수 있습니다.
wxpath는 표현식을 일련의 탐색 및 추출 단계(내부적으로 Segment라고 함)로 평가합니다.
url(...)은 정적 URL(고정된 URL) 또는 동적 URL(XPath 표현식에서 파생된 URL)을 통해 크롤링 작업을 생성합니다. URL은 깊이가 아닌 최선의 방식으로 전역적으로 중복 제거됩니다.
XPath 세그먼트는 바로 앞의 url(...) 작업을 통해 가져온 문서에서 작동합니다.
///url(...)은 심층 크롤링을 나타냅니다. 너비 우선(ish) 방식으로 max_depth까지 진행합니다.
결과는 준비되는 대로 생성됩니다.
wxpath는 asyncio/aiohttp 우선으로, 크롤링 및 데이터 추출을 위한 비동기 API를 제공합니다.
import asyncio
from wxpath import wxpath_async

items = []

async def main():
    path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
    async for item in wxpath_async(path_expr, max_depth=1):
        items.append(item)

asyncio.run(main())
wxpath는 또한 asyncio-in-sync API를 제공하므로, 동기 코드의 단순성을 유지하면서 여러 페이지를 동시에 크롤링할 수 있습니다. 이는 엄격하게 동기 실행 환경(asyncio 이벤트 루프 외부)에서 성능이 중요할 때 특히 유용합니다.
from wxpath import wxpath_async_blocking_iter

path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
items = list(wxpath_async_blocking_iter(path_expr, max_depth=1))
wxpath는 기본적으로 WXPathEngine(..., robotstxt=True) 생성자를 통해 robots.txt를 준수합니다.
wxpath Python API는 구조화된 객체를 생성합니다.
표현식에 따라 결과에는 다음이 포함될 수 있습니다:
lxml.* 및 lxml.html.* 객체elementpath.datatypes.* 객체 (XPath 3.1 기능용)WxStr (출처가 포함된 문자열 값)CLI는 이러한 객체를 표시를 위해 일반 JSON으로 평탄화합니다. Python API는 기본적으로 구조를 유지합니다.
wxpath는 elementpath 라이브러리를 사용하여 XPath 3.1을 지원하므로, 맵, 배열 등 고급 XPath 기능을 사용할 수 있습니다. 이를 통해 더 강력한 XPath 쿼리를 작성할 수 있습니다.
path_expr = """
    url('https://en.wikipedia.org/wiki/Expression_language')
    ///url(//div[@id='mw-content-text']//a/@href)
    /map{
        'title':(//span[contains(@class, "mw-page-title-main")]/text())[1],
        'short_description':(//div[contains(@class, "shortdescription")]/text())[1],
        'url'://link[@rel='canonical']/@href[1]
    }
"""
# [...
# {'title': 'Computer language',
# 'short_description': 'Formal language for communicating with a computer',
# 'url': 'https://en.wikipedia.org/wiki/Computer_language'},
# {'title': 'Machine-readable medium and data',
# 'short_description': 'Medium capable of storing data in a format readable by a machine',
# 'url': 'https://en.wikipedia.org/wiki/Machine-readable_medium_and_data'},
# {'title': 'Domain knowledge',
# 'short_description': 'Specialist knowledge within a specific field',
# 'url': 'https://en.wikipedia.org/wiki/Domain_knowledge'},
# ...]
wxpath는 크롤링 진행 상황을 추적하기 위해 진행 표시줄(tqdm 사용)을 제공합니다. 장기 실행 크롤링에 특히 유용합니다.
engine.run(..., progress=True)로 설정하거나, wxpath_async*(...) 함수에 progress=True를 전달하여 활성화합니다.
items = wxpath.wxpath_async_blocking("...", progress=True)
> 100%|██████████████████████████████████████████████████████████▎| 469/471 [00:05<00:00, 72.00it/s, depth=2, yielded=457]
wxpath는 명령줄 인터페이스(CLI)를 제공하여 터미널에서 직접 wxpath 표현식을 빠르게 실험하고 실행할 수 있습니다.
다음 예제는 Wikipedia의 "Expression language" 페이지에서 시작하여 다른 위키 페이지로의 링크를 추출하고, 각 연결된 페이지에서 특정 필드를 검색하는 방법을 보여줍니다.
