 pvharmo2/gha-lab-e8902eccd3
보안 연구 랩: CVE-2025-52467 (pgai pull_request_target 워크플로 코드 실행 / GITHUB_TOKEN 탈취) 재현 — timescale/pgai 스냅샷

자동화된 연구 산출물 — 업스트림 프로젝트가 아님.
이 저장소는 Université Laval의 석사 논문을 위해 자동화된 하네스가 구축한 일회용 실험실로, 게시된 GitHub Actions 워크플로우 취약점을 재현하기 위한 것입니다. 이는 커밋
2a209b058c60823b57e8b7775b10244ff340eb8b(2025-05-14) 시점의timescale/pgai의 축어적 스냅샷이며, 해당 프로젝트의 자체 라이선스 하에 재배포되며, 그 라이선스 파일은 이 스냅샷에 변경 없이 포함되어 있습니다.업스트림 프로젝트는 관여하지 않으며, 결코 대상이 되지 않고, 여기서 연구된 취약점은 이미 공개된 것입니다. 이 저장소의 모든 시크릿과 변수는 무작위로 생성된 더미 값입니다 — 실제 자격 증명은 존재하지 않습니다. 액션 참조와 러너 이미지는 2025-05-14에 확인된 값으로 고정되어 있습니다. 스냅샷에 적용된 모든 변경 사항은 하네스 출력의
pinning.md를 참조하세요.질문 또는 이의 제기: [email protected]
PostgreSQL을 RAG 및 에이전틱 애플리케이션을 위한 강력하고 프로덕션 준비가 된 검색 엔진으로 변환하는 Python 라이브러리입니다.
🔄 PostgreSQL 데이터와 S3 문서에서 벡터 임베딩을 자동으로 생성하고 동기화합니다. 데이터가 변경되면 임베딩도 자동으로 업데이트됩니다.
🔍 pgvector 및 pgvectorscale을 사용한 강력한 벡터 및 의미론적 검색.
🛡️ 기본 제공되는 프로덕션 준비 기능: 효율적인 임베딩 생성을 위한 배치 처리를 지원하며, 모델 실패, 속도 제한, 지연 시간 급증에 대한 내장 처리를 제공합니다.
🐘 Timescale Cloud, Amazon RDS, Supabase 등을 포함한 모든 PostgreSQL 데이터베이스에서 작동합니다.
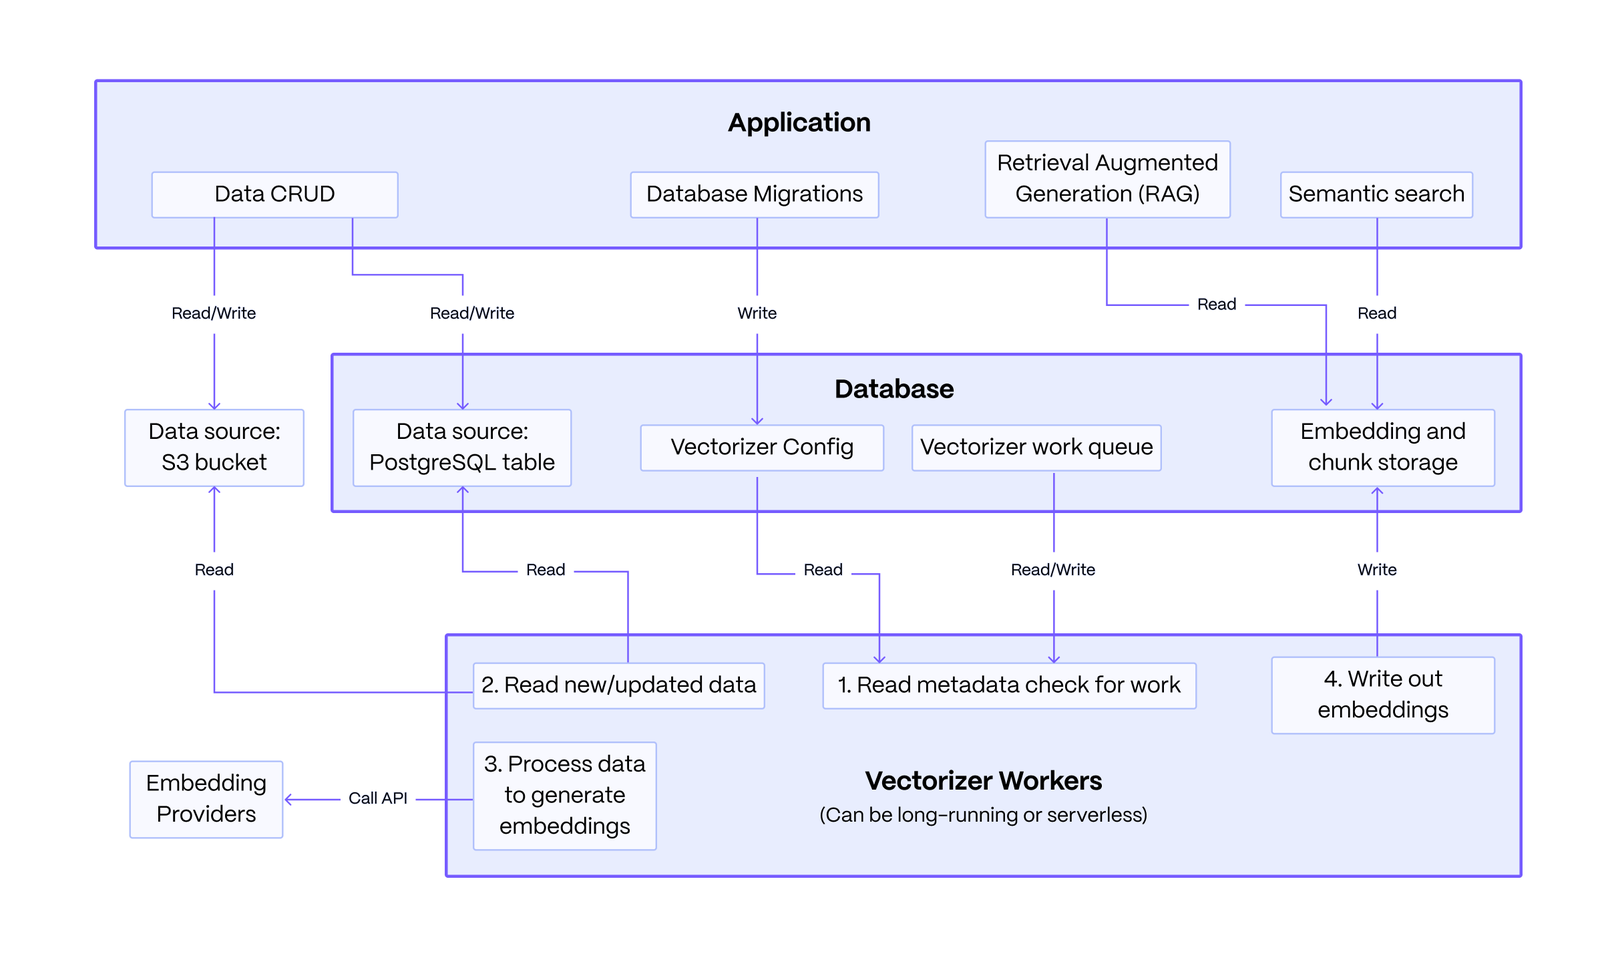
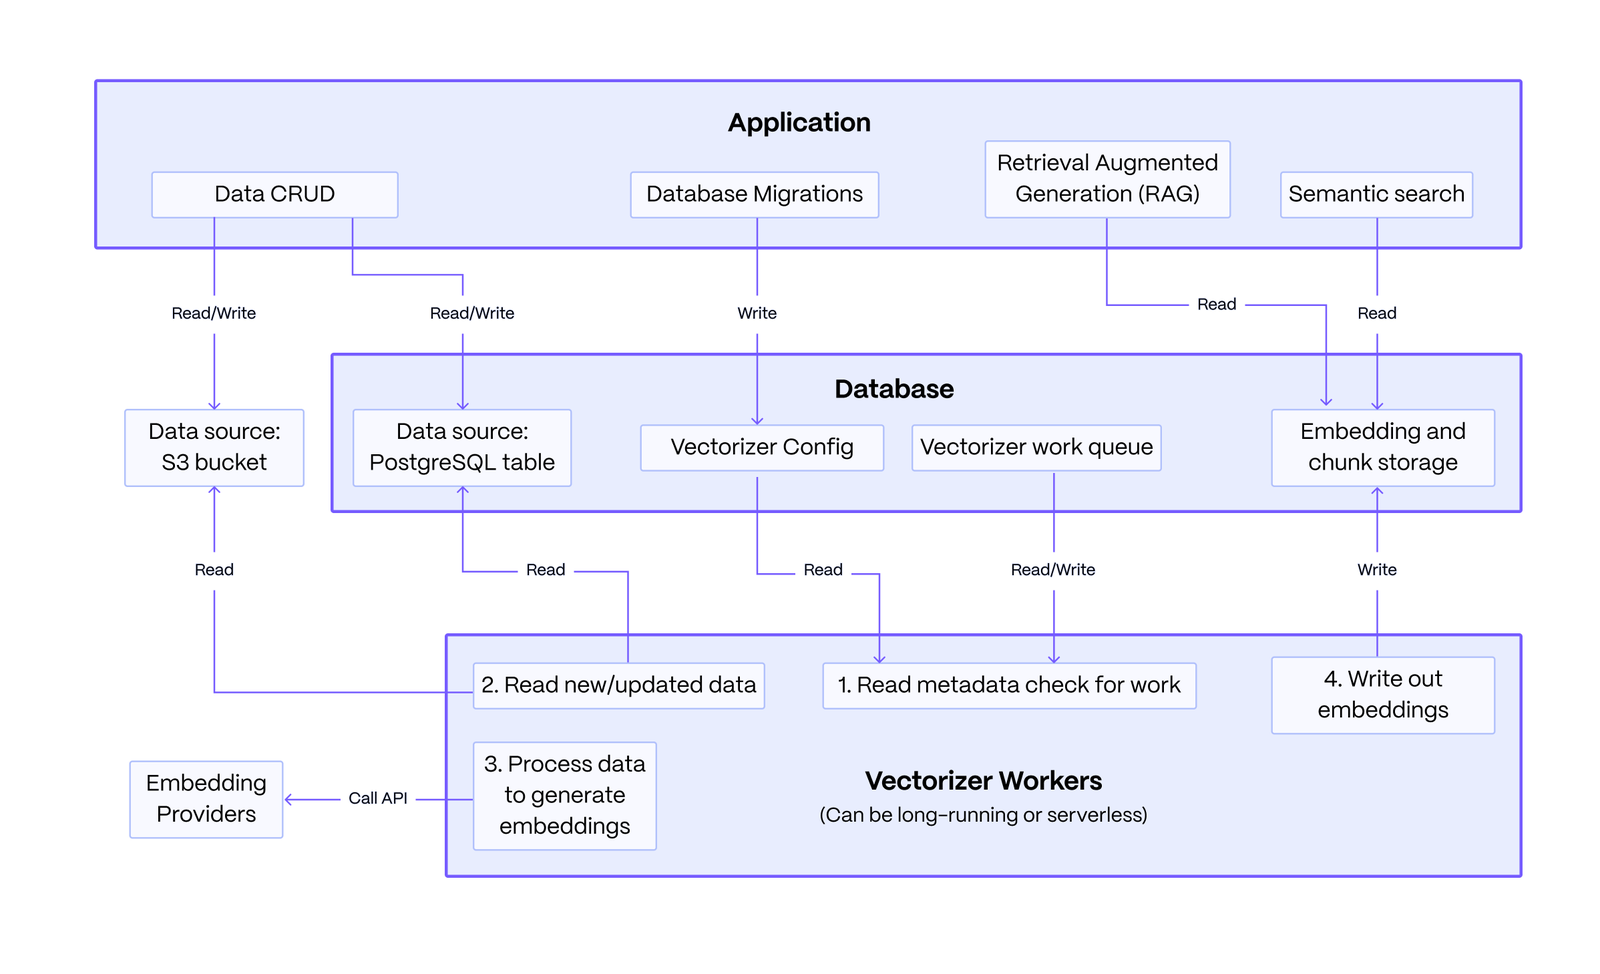
기본 아키텍처: 시스템은 사용자가 작성하는 애플리케이션, PostgreSQL 데이터베이스, 그리고 무상태(stateless) 벡터라이저 워커로 구성됩니다. 애플리케이션은 PostgreSQL 또는 S3와 같은 소스의 데이터를 임베딩하기 위한 벡터라이저 구성을 정의합니다. 워커는 이 구성을 읽고, 데이터 큐를 임베딩 및 청크 분할된 텍스트로 처리한 후 결과를 다시 기록합니다. 그런 다음 애플리케이션은 이 데이터를 쿼리하여 RAG 및 의미론적 검색을 구동합니다.
이 아키텍처의 핵심 강점은 복원력에 있습니다: 애플리케이션이 수행하는 데이터 수정은 임베딩 프로세스와 분리되어 있어, 임베딩 서비스의 실패가 핵심 데이터 작업에 영향을 미치지 않도록 보장합니다.
먼저 pgai 패키지를 설치합니다.``` pip install pgai
그런 다음, pgai 데이터베이스 구성 요소를 설치합니다. 이는 터미널에서 CLI를 사용하거나 Python 애플리케이션 코드에서 pgai Python 패키지를 사용하여 수행할 수 있습니다.```
# from the cli
pgai install -d <database-url>

# or from the python package, often done as part of your application setup
import pgai
pgai.install(DB_URL)
이 빠른 시작은 pgai Vectorizer가 데이터 변경 시 임베딩을 자동으로 생성하고 동기화하여 PostgreSQL 데이터에 대한 의미론적 검색과 RAG를 어떻게 가능하게 하는지 보여줍니다.
pgai Vectorizer의 핵심 "비결"은 임베딩 생성에 대한 선언적 접근 방식입니다. 파이프라인을 정의하기만 하면 Vectorizer가 임베딩을 동기화 상태로 유지하는 운영상의 복잡성을 처리하며, 임베딩 엔드포인트가 불안정한 경우에도 마찬가지입니다. 파이프라인의 간단한 버전은 다음과 같이 정의할 수 있습니다.```sql CREATE TABLE IF NOT EXISTS wiki ( id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY, url TEXT NOT NULL, title TEXT NOT NULL, text TEXT NOT NULL )
SELECT ai.create_vectorizer( 'wiki'::regclass, loading => ai.loading_column(column_name=>'text'), destination => ai.destination_table(target_table=>'wiki_embedding_storage'), embedding => ai.embedding_openai(model=>'text-embedding-ada-002', dimensions=>'1536') )
The vectorizer will automatically create embeddings for all the rows in the
`wiki` table, and, more importantly, will keep the embeddings synced with the
underlying data as it changes.  **Think of it almost like declaring an index** on
the `wiki` table, but instead of the database managing the index datastructure
for you, the Vectorizer is managing the embeddings.

## Running the quick start

**Prerequisites:**
- A PostgreSQL database ([docker instructions](https://docs.timescale.com/self-hosted/latest/install/installation-docker/)).
- An OpenAI API key (we use openai for embedding in the quick start, but you can use [multiple providers](#supported-embedding-models)).

Create a `.env` file with the following:```
OPENAI_API_KEY=<your-openai-api-key>
DB_URL=<your-database-url>
빠른 시작 예제에서 전체 python 코드와 requirements.txt를 다운로드하여 .env 파일과 같은 디렉터리에서 실행할 수 있습니다.
