 paultendo/confusable-vision
세계 최초의 폰트별 혼동 문자 데이터셋: 사람들이 실제로 읽는 크기에서 322개 폰트의 윤곽선을 측정하여 어떤 유니코드 문자가 서로 비슷하게 보이는지 분석한 자료. CC BY 라이선스이며, Mozilla의 부가 기능 이름 검사에 사용됨.

세계 최초의 폰트별 혼동 문자 데이터셋. 어떤 유니코드 문자가 어떤 문자와 닮았는지를 픽셀이 아닌 폰트의 외곽선에서 측정한다. 현재 릴리스인 2026.09.26은 322개 폰트 각각이 그리는 모든 글자와 숫자를, 각 글리프가 본문 텍스트에서 가지는 크기와 기준선 위치에서 비교한다. 그다음 ASCII 글자와 숫자의 닮은꼴을 실제 위치에서 검사한다. 즉, 사람들이 읽는 크기로 일반적인 폰트에서 다른 글자들 사이에 배치하고, 0과 O처럼 누구나 닮았다고 받아들이는 쌍과 비교한다.
addons.mozilla.org는 confusable-vision의 문자를 사용해 부가 기능 이름에서 닮은꼴을 검사하며, Mozilla 소스에 크레딧이 표기되어 있다. 사용처를 참고하라.
src/olympia/amo/confusables.py, 풀 리퀘스트 #24468, #24541, #24612, #24665 (2026년 2월~3월).data/confusables_supplement.tsv, data/confusables_vision.tsv.docs/hkb.md).이 프로젝트들은 2026년 2월과 3월의 confusable-vision 출력에서 데이터를 가져왔다.
Hacker News에서 논의됨: I rendered 1,418 confusables over 230 fonts 및 Confusables.txt and NFKC disagree on 31 characters.
릴리스 2026.09.26의 수치:
데이터는 data/release/2026.09.26/에 버전이 지정된 릴리스로 게시된다 (CC-BY-4.0). namespace-guard와 d0ma1n이 이를 기반으로 구축되었다.
릴리스 2 (2026.09.24, TLD 데이터는 2026.09.25)는 이전 실행이 비교했던 쌍과 폰트만 비교했다. 동일 글리프 감사에서 폰트가 두 문자를 같은 글리프로 그리는 2,654개 사례 중 637개만 잡아낸 것으로 드러났다. 릴리스 3은 이를 수정하고 세 가지를 추가한다:
2026년 3월 수치 (245개 폰트에 걸쳐 249,976개 단일 문자 쌍과 2,524,275개 바이그램 쌍)는 크기와 기준선을 무시한 측정에서 나왔다. 이들은 대체되었으며, 해당 실행의 파일은 참고용으로 data/output/에 남아 있다.
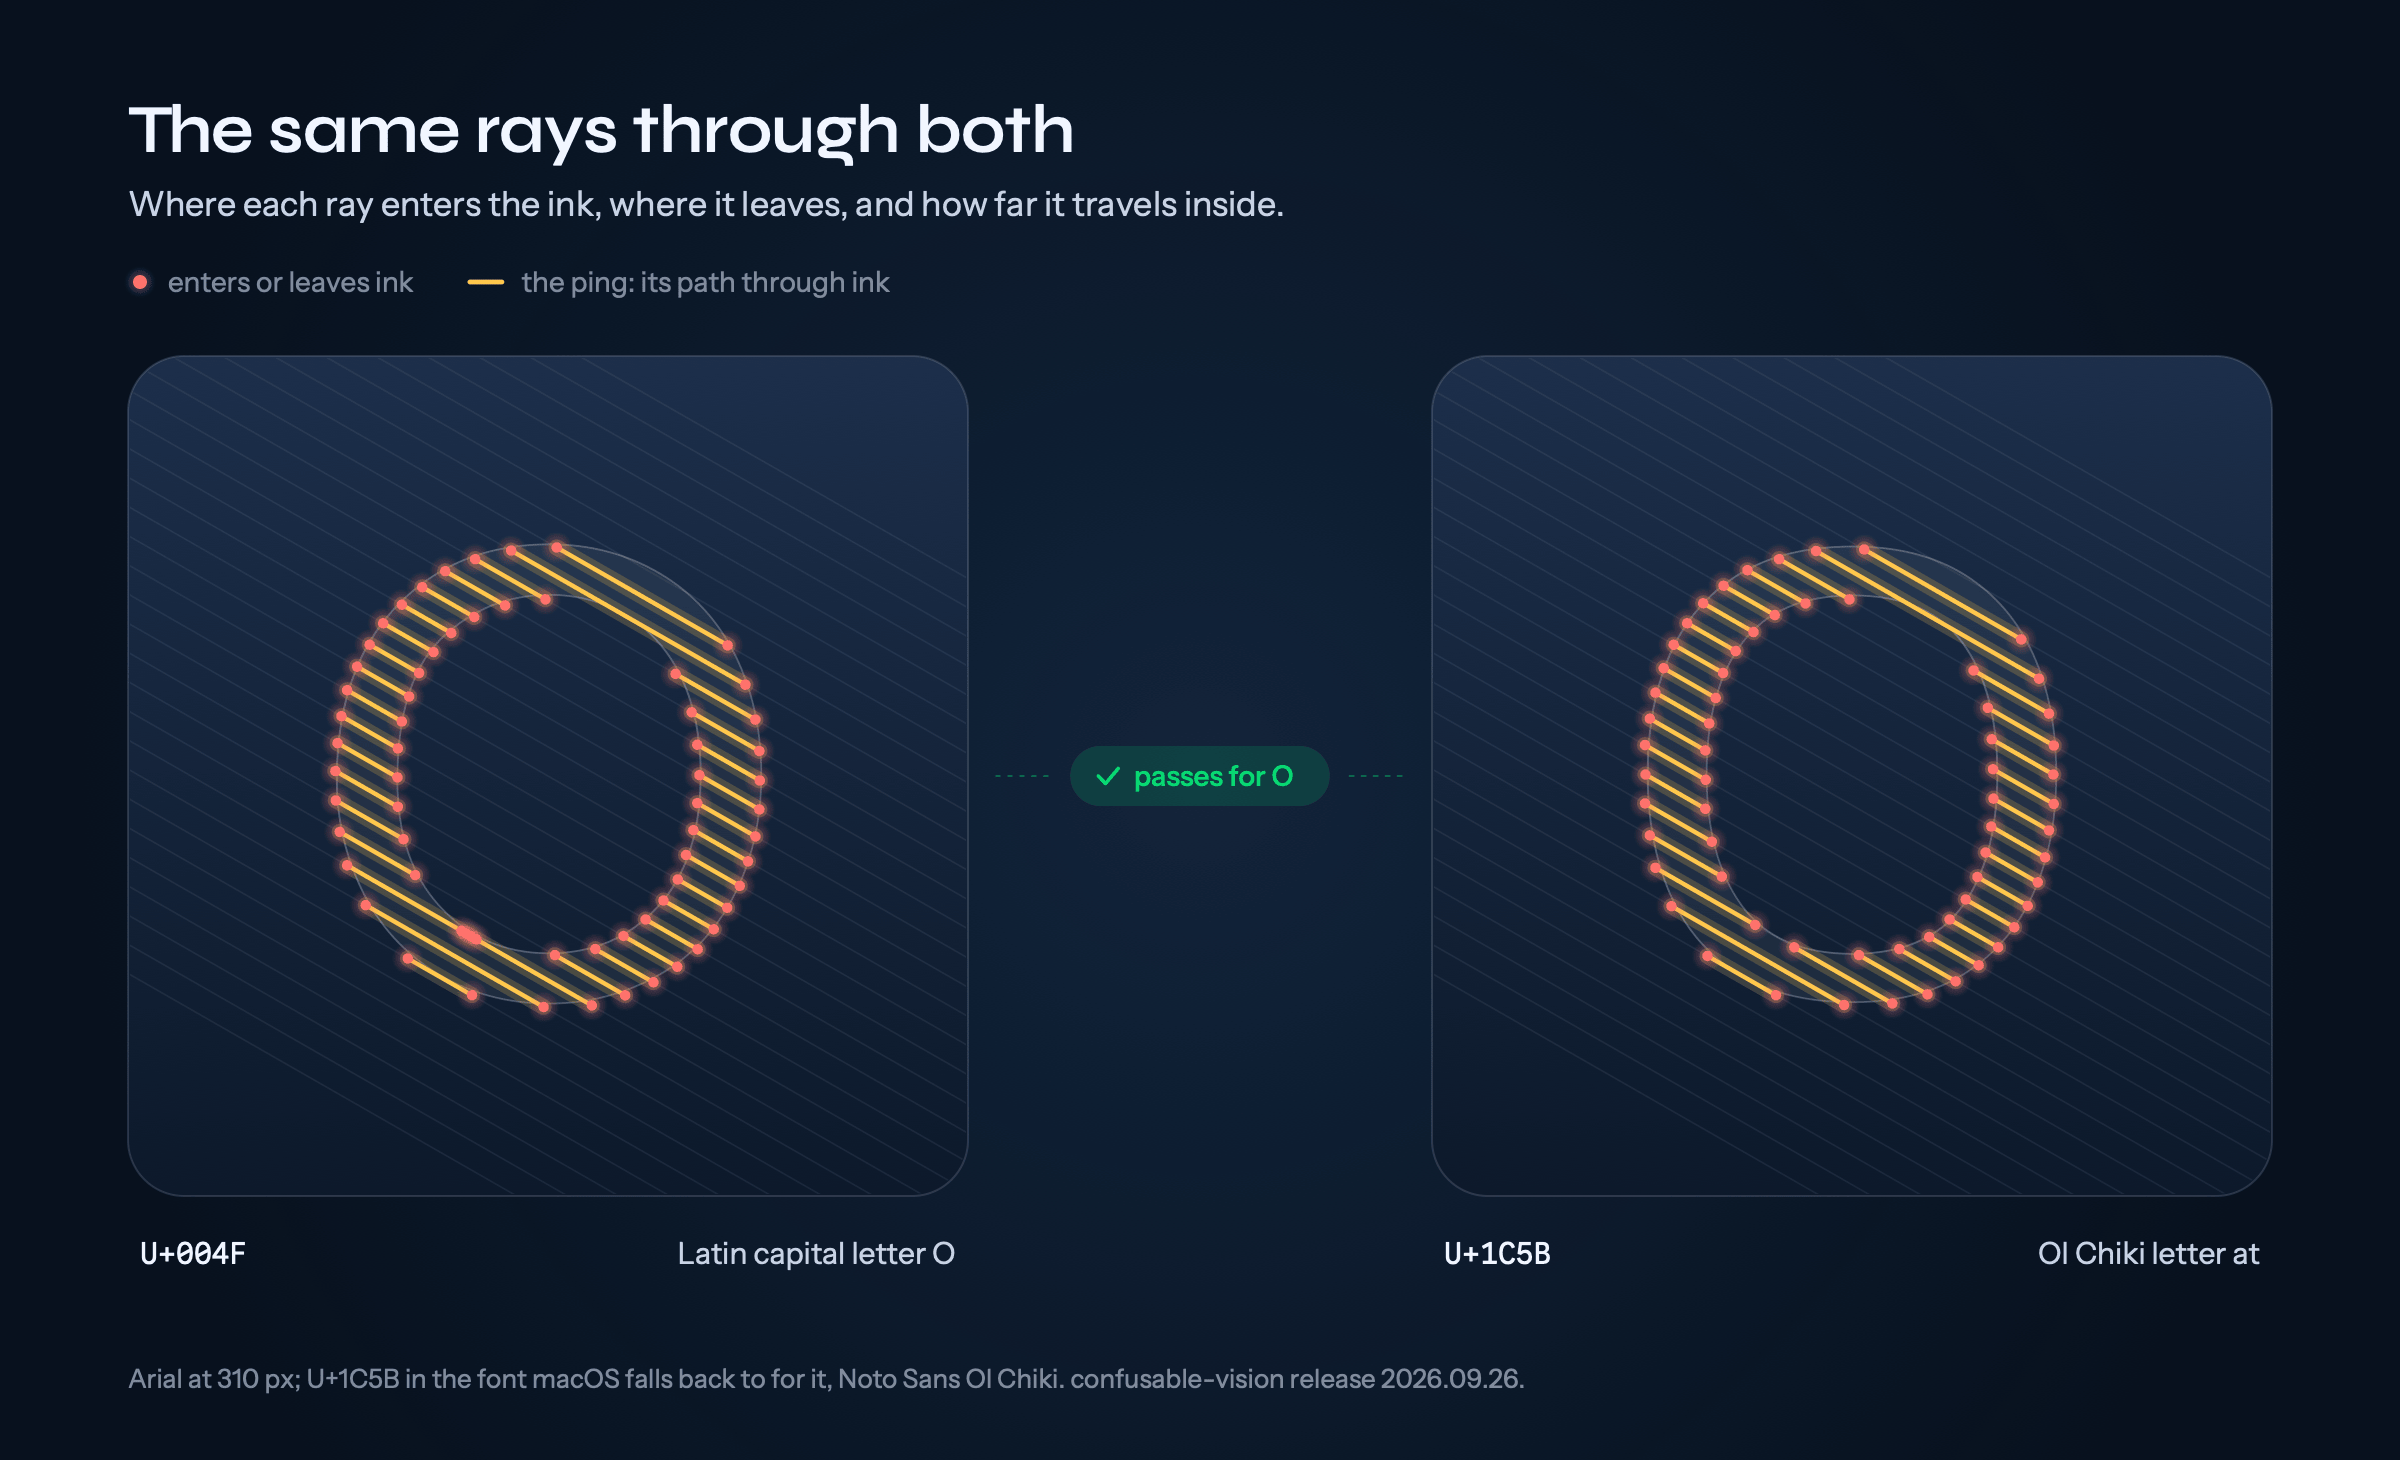
RaySpace는 각 글리프의 윤곽선을 통해 36개 각도에서 평행 광선을 50개씩 쏘고, 광선마다 다섯 가지를 기록한다: 윤곽선을 몇 번 교차하는지, 어디서, 어떤 각도로, 잉크를 통과할 때마다 얼마나 멀리 이동하는지 (핑, 광선을 따른 획의 너비), 그리고 획 사이의 가장 넓은 간격. 각 글리프는 두 번 측정된다: 모양을 위해 자체 박스에서, 그리고 크기와 위치가 반영되도록 기준선 위의 고정 프레임에서. 두 문자는 모양 거리가 0.5 미만이고 기준선 고정 거리가 0.2 미만일 때 한 폰트에서 닮은 것으로 간주된다. 비교는 Rust (native/cv-pairs)에서 모든 코어로 실행된다.
고립 상태에서 측정된 닮은꼴도 텍스트 한 줄에서는 두드러질 수 있다. 그래서 ASCII 글자, 숫자 또는 시퀀스의 모든 후보 닮은꼴을 다섯 가지 맥락에서 이웃 사이에 배치한다 (pa_nel, 20_5). 즉, 13 px의 시스템 폰트와 16 px의 Helvetica, Arial, Times New Roman, Georgia에서, 각각 기기 픽셀 비율 1과 2로, 플랫폼의 폰트 폴백과 함께. 아무것도 재조정되지 않는다: 닮은꼴은 줄에서 놓이는 위치에서 비교된다.
각 맥락의 기준은 누구나 닮았다고 받아들이는 쌍, 즉 0과 O, 1과 l, I와 l에서 나오며, 그 맥락이 같은 크기와 위치로 그리는 경우에만 계산된다. 닮은꼴은 다음과 같다:
검사는 두 글리프를 기기 해상도의 네 배로 래스터화한 후 수행한다: 기기 픽셀보다 좁은 간격이 닫힌 후 조각과 구멍의 수가 같은지; 카운터가 정사각형 또는 둥근 모양으로 같은지, 같은 위치에 비슷한 크기인지; 이웃과의 간격; 잉크의 상단, 하단, 너비; 우횡서 문자가 주변 숫자의 순서를 바꾸는지; 획 굵기; 각 변의 모양 (좌우 반전); 잉크가 각 모서리로 얼마나 뻗는지; 기울기; 가운데 세로줄 (Y 대 V); 그리고 세로줄을 가로지르는 막대 (Ŧ 대 T). 두 글자 시퀀스는 글자별로 검사된다.
계층은 렌더링된 샘플의 시각적 판단에 맞춰 조정되었고, 받아들여진 쌍에 고정되었다. 독자를 대상으로 한 연구는 아직 없다.
유니코드의 confusables.txt에 없는 엄격 닮은꼴 중 여섯 개로, 각각 다섯 맥락 모두에서 닮았다. macOS는 각각을 Noto 폴백 폰트로 그린다:
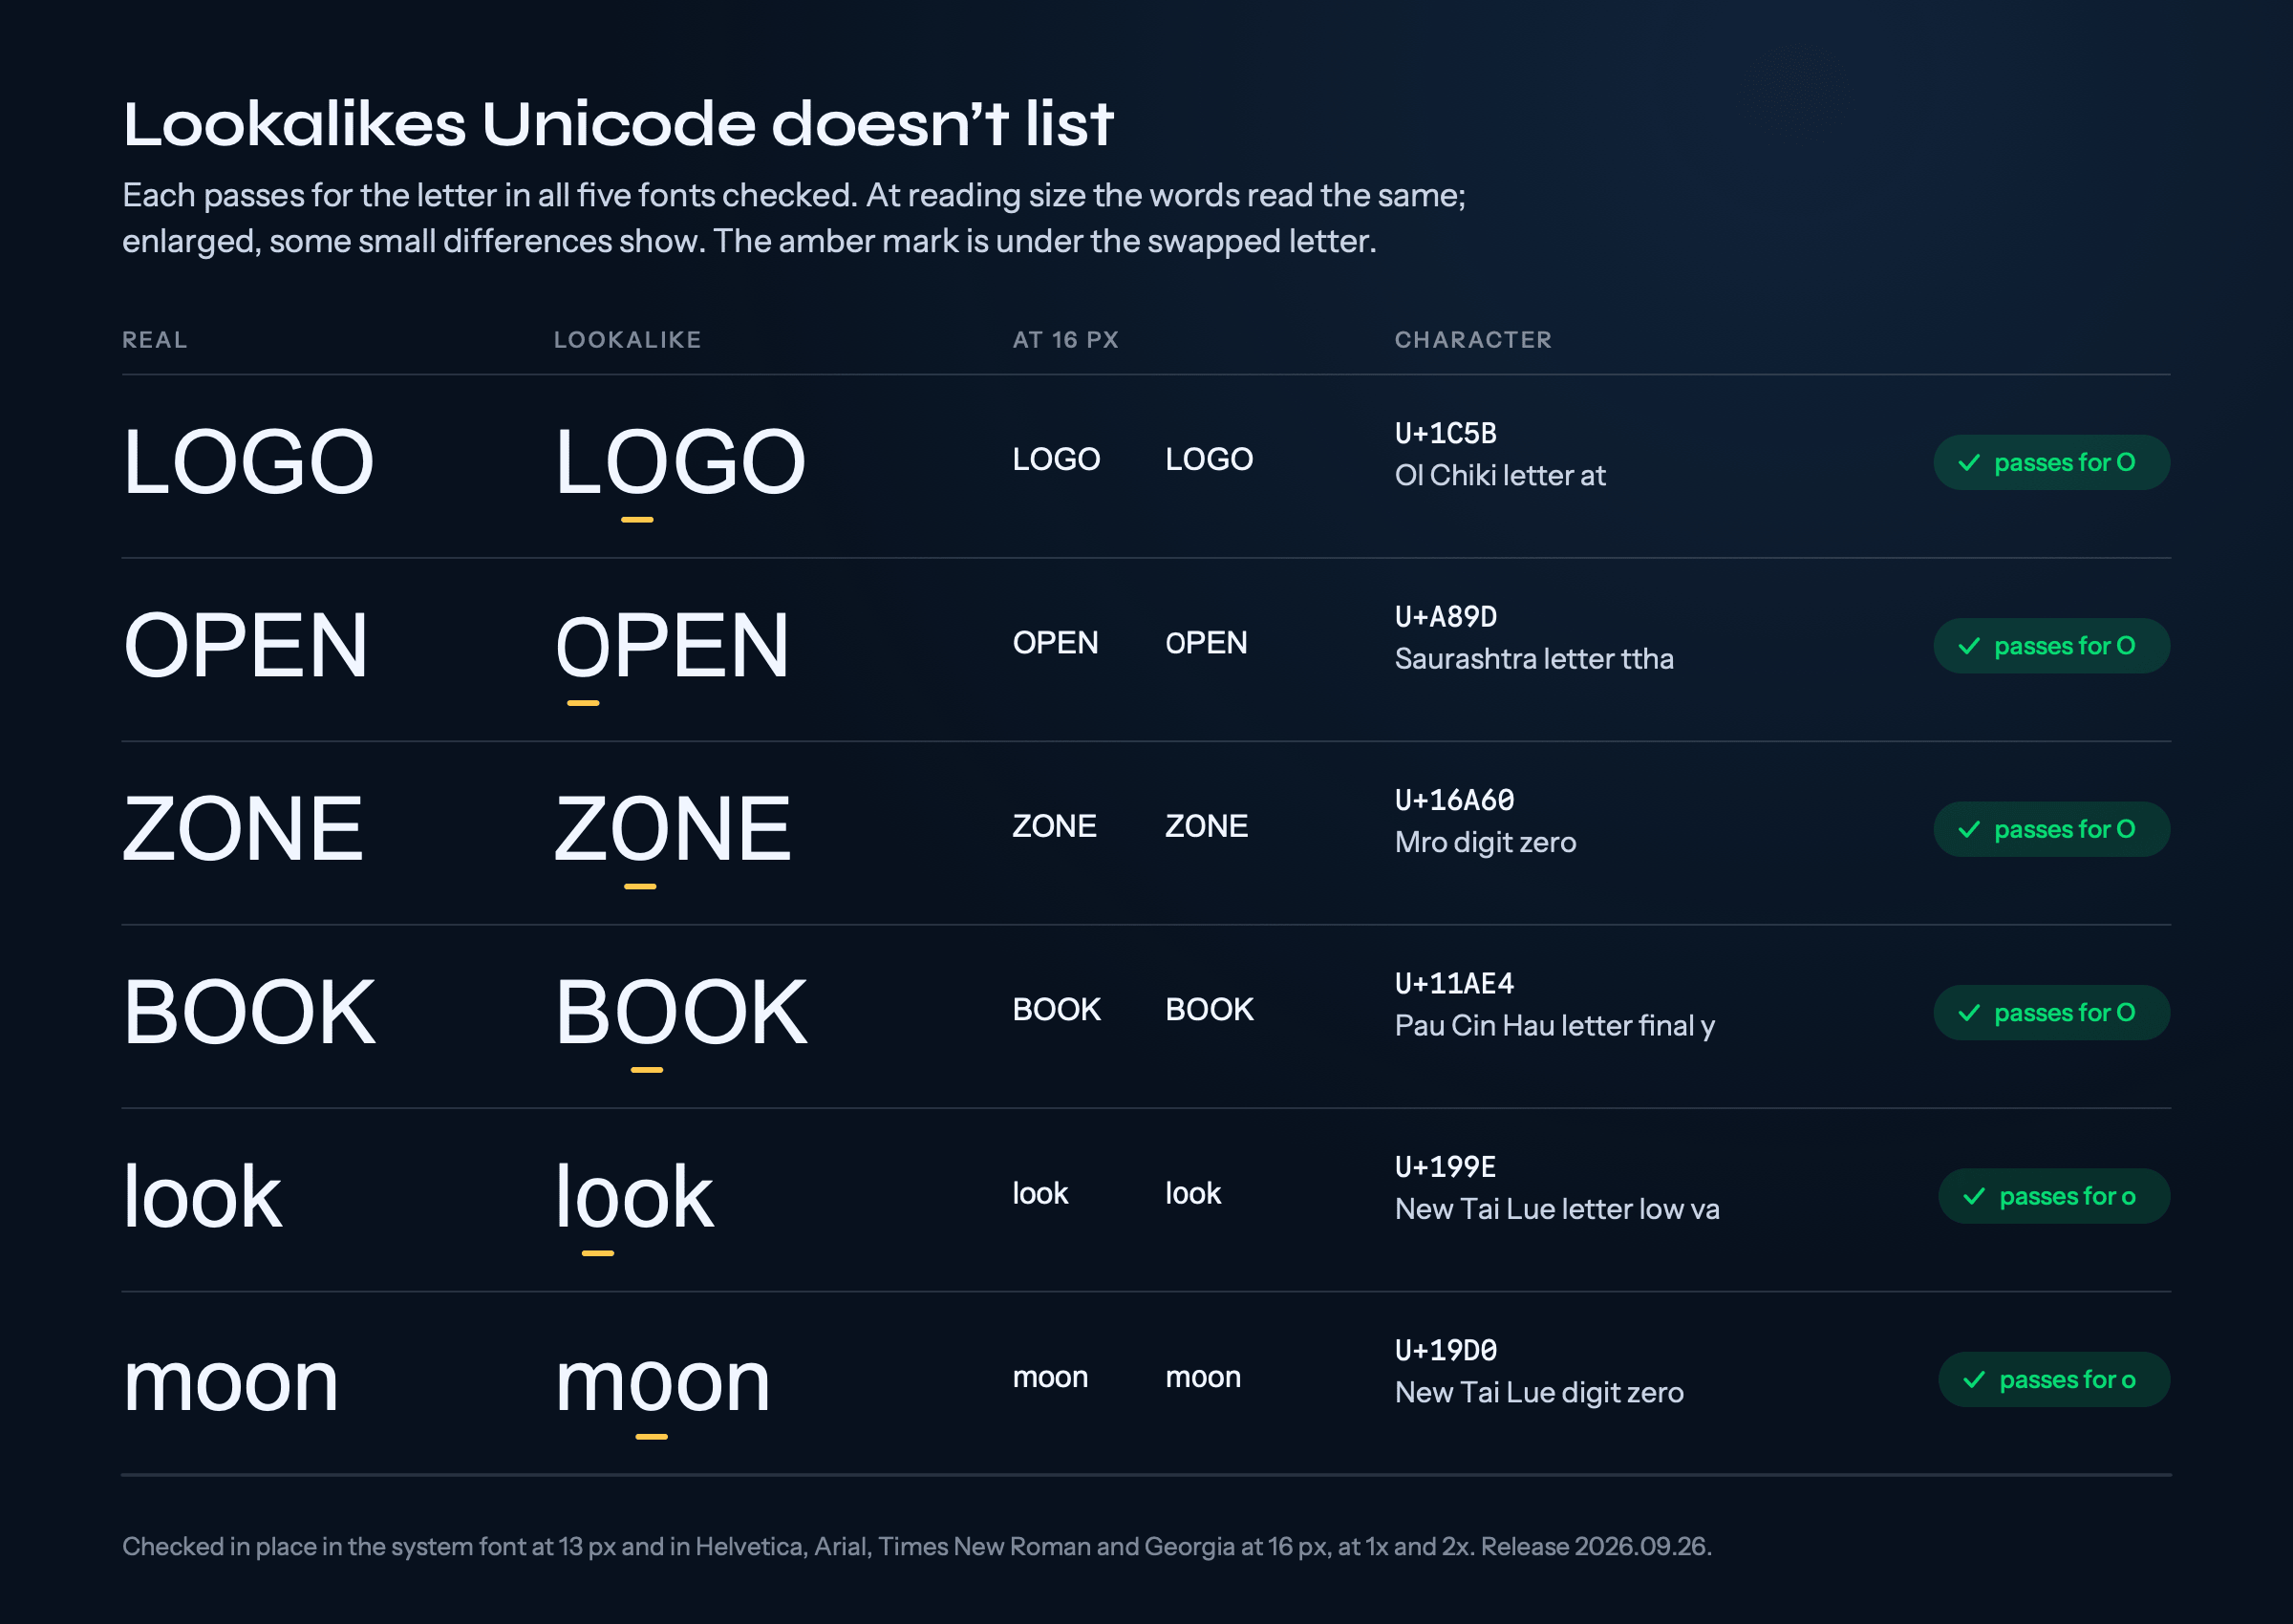
| 문자 | 이름 | 통과 대상 |
|---|---|---|
| ᱛ U+1C5B | OL CHIKI LETTER AT | O |
| ꢝ U+A89D | SAURASHTRA LETTER TTHA | O |
| 𖩠 U+16A60 | MRO DIGIT ZERO | O |
| 𑫤 U+11AE4 | PAU CIN HAU LETTER FINAL Y | O |
| ᦞ U+199E | NEW TAI LUE LETTER LOW VA | o |
| ᧐ U+19D0 | NEW TAI LUE DIGIT ZERO | o |
대부분의 닮은꼴 도메인 뒤에 있는 ASCII 치환은 일부 폰트에서만 성립한다. l에 대한 I는 시스템 폰트, Helvetica, Arial에서 거의 동일하다. l에 대한 1은 Times New Roman에서만, o에 대한 0은 숫자가 소문자 높이인 Georgia에서만, m에 대한 rn은 표준 밀도 화면의 Arial 16 px에서만 성립한다. cl에 대한 d와 vv에 대한 w는 16 px에서 성립하지 않는다.
그 과정에서: macOS와 iOS에 기본 포함된 Georgia는 ⅳ (U+2173, SMALL ROMAN NUMERAL FOUR)를 ⅸ, 즉 9와 정확히 똑같이 그린다. Windows 11의 Georgia는 올바르다. 이는 2026년 3월 Microsoft Q&A에서 처음 보고되었고 Apple에도 보고되었다.
| 파일 | 행 하나당 |
|---|---|
characters.jsonl.gz | 측정된 코드 포인트, 문자 체계, 카테고리, TR39 식별자 유형, IDNA2008 상태, 그리고 이를 허용하는 레지스트리의 TLD 포함 |
lookalikes.jsonl.gz | 하나 이상의 폰트 또는 조합에서 닮은 쌍, 그 뒤의 개수와 각 폰트의 거리 포함 |
sequences.jsonl.gz | 두 글자 ASCII 시퀀스와 닮은 문자 |
in-place.jsonl.gz | 실제 위치에서 검사한 후보 닮은꼴, 각 맥락의 판정과 실패한 검사 포함 |
DATASET.md는 모든 필드, 무엇을 비교했는지, 쌍이 없을 때의 의미, 제안된 임계값을 제공한다. 릴리스는 버전으로 고정하라. 커밋된 다른 출력:
| 파일 | 설명 |
|---|---|
data/output/idn-relevant-pairs.json | 릴리스의 IDN 뷰: 임계값을 통과하고 두 문자가 공통 TLD에 모두 등록될 수 있는 2,923개 쌍. npx tsx scripts/export-idn-pairs.ts |
data/output/confusable-weights-v4.json, font-specific-weights-v4.json | namespace-guard용 가중치: ASCII 글자 또는 두 문자 체계가 관련된 쌍을, 닮은 폰트의 비율로 점수화 (전체 및 폰트별). scripts/generate-weights-release.ts, scripts/generate-font-weights-release.ts |
data/output/unicode-submission/ | 유니코드의 혼동 문자 데이터에 제안하는 추가 항목, 각 줄 뒤의 측정값 포함. scripts/build-unicode-submission.ts |
data/input/tld-rules.json | 각 위임된 TLD의 레지스트리가 2단계에서 허용하는 문자, IANA의 IDN 테이블, ICANN 레지스트리 계약, 조사된 국가 코드 정책에서 가져옴. scripts/build-tld-rules.py; d0ma1n이 이를 가져온다 |
