 p-e-w/heretic
언어 모델을 위한 완전 자동 검열 제거



Heretic은 값비싼 사후 학습 없이 트랜스포머 기반 언어 모델에서 검열(일명 "안전 정렬")을 제거하는 도구입니다. 이 도구는 "ablation"이라고도 알려진 방향성 제거(directional ablation)의 고급 구현(Arditi et al. 2024, Lai 2025 (1, 2))과 Optuna 기반의 TPE 파라미터 최적화기를 결합합니다.
이 접근 방식 덕분에 Heretic은 완전 자동으로 작동할 수 있습니다. Heretic은 거부 응답의 수와 원본 모델로부터의 KL 발산을 동시에 최소화하여 고품질의 ablation 파라미터를 찾아냅니다. 그 결과 원본 모델의 지능을 최대한 유지하면서 검열이 제거된 모델을 얻을 수 있습니다. Heretic을 사용하는 데 트랜스포머 내부 구조에 대한 이해는 필요하지 않습니다. 실제로 명령줄 프로그램을 실행할 줄 아는 사람이라면 누구나 Heretic을 사용해 언어 모델의 검열을 제거할 수 있습니다.
Heretic은 대부분의 dense 모델을 지원하며, 다수의 멀티모달 모델, 여러 가지 MoE 아키텍처, 그리고 Qwen3.5와 같은 일부 하이브리드 모델까지 지원합니다. 순수 상태 공간 모델(pure state-space model)과 일부 다른 연구용 아키텍처는 아직 기본적으로 지원되지 않습니다.
기본 설정으로 비지도 방식으로 실행할 때, Heretic은 인간 전문가가 수동으로 만든 ablation에 필적하는 품질의 검열 제거 모델을 생성할 수 있습니다:
| 모델 | "유해한" 프롬프트에 대한 거부 응답 | "무해한" 프롬프트에 대한 원본 모델로부터의 KL 발산 |
|---|---|---|
| google/gemma-3-12b-it (원본) | 97/100 | 0 (정의상) |
| mlabonne/gemma-3-12b-it-abliterated-v2 | 3/100 | 1.04 |
| huihui-ai/gemma-3-12b-it-abliterated | 3/100 | 0.45 |
| p-e-w/gemma-3-12b-it-heretic (ours) | 3/100 | 0.16 |
인간의 개입 없이 생성된 Heretic 버전은 다른 ablation들과 동일한 수준의 거부 억제를 달성하면서도 훨씬 낮은 KL 발산을 보여, 원본 모델의 능력에 대한 손상이 더 적음을 나타냅니다.
(Heretic의 내장 평가 기능을 사용하여 이 수치를 재현할 수 있습니다. 예: heretic --model google/gemma-3-12b-it --evaluate-model p-e-w/gemma-3-12b-it-heretic.
정확한 값은 플랫폼과 하드웨어에 따라 달라질 수 있습니다.
위 표는 RTX 5090에서 PyTorch 2.8을 사용하여 작성되었습니다.)
물론 수학적 지표와 자동화된 벤치마크가 전부를 말해주지는 않으며, 인간의 평가를 대체할 수 없습니다. Heretic으로 생성된 모델은 사용자들에게 좋은 평가를 받았습니다 (링크와 강조 추가):
"전에는 회의적이었는데, 방금 GPT-OSS 20B Heretic 모델을 다운로드했는데 정말 대단합니다. 민감한 주제에 대해 적절한 형식의 긴 응답을 제공하고, 검열되지 않은 모델에서 기대할 수 있는 정확한 무검열 단어를 사용하며, 세부 정보 등이 담긴 마크다운 형식의 표를 생성합니다. 지금까지 나온 이 모델의 최고 ablation 버전인 것 같습니다..." (댓글 링크)
"Heretic GPT 20b는 제가 지금까지 시도한 것 중 최고의 무검열 모델인 것 같습니다. 모델의 지능을 파괴하지 않으면서 기본 모델에서는 거부될 프롬프트에 정상적으로 응답합니다." (댓글 링크)
"[Qwen3-4B-Instruct-2507-heretic] 16GB VRAM에서 실행할 수 있었던 최고의 비양자화 ablation 모델이었습니다." (댓글 링크)
Heretic 모델은 MMLU, GSM8K와 같은 표준 지표를 사용하여 독립적으로 벤치마킹되었으며, 경쟁 ablation 도구로 생성된 모델들과 비교하여 우수한 성능을 보이는 것으로 나타났습니다: 1, 2.
커뮤니티는 Heretic으로 5,000개가 훨씬 넘는 모델을 만들어 공개했습니다.
하드웨어에 맞게 PyTorch 2.2+가 설치된 Python 3.10+ 환경을 준비하세요. 그런 다음 실행하세요:
pip install -U heretic-llm
heretic Qwen/Qwen3-4B-Instruct-2507
Qwen/Qwen3-4B-Instruct-2507을 검열을 제거하려는 모델로 바꾸세요.
[!IMPORTANT]
Heretic이 작동하기 위한 최소 PyTorch 버전은 2.2이지만, 일부 모델과 구성은 이후 버전에서만 제공되는 기능을 필요로 할 수 있습니다. 예를 들어 gpt-oss와 같은 MXFP4 양자화 모델을 로드하려면 PyTorch 2.6에서 추가된
torch.accelerator를 사용합니다.
[!TIP]
Heretic은 의존성 관리를 위해 uv를 사용하며, 저장소에는 모든 패키지 버전을 고정하는
uv.lock파일이 포함되어 있습니다. 이미 uv를 사용하고 있다면 (그리고 아마 사용해야 할 것입니다!), 저장소를 복제하고uv run heretic으로 Heretic을 실행하기만 하면 됩니다. 이렇게 하면 의존성이 개발자들이 사용하는 것과 일치하여 안정성과 보안이 향상됩니다.
이 과정은 완전 자동이며 구성이 필요하지 않습니다. 그러나 더 세밀한 제어를 위해
변경할 수 있는 다양한 구성 파라미터가 있습니다. 사용 가능한 명령줄 옵션을 보려면
heretic --help를 실행하거나, 구성 파일을 선호한다면
config.default.toml을 참고하세요.
프로그램 실행 시작 시, Heretic은 사용 가능한 하드웨어를 최대한 활용하기 위해
최적의 배치 크기를 결정하기 위해 시스템을 벤치마킹합니다.
RTX 3090에서 기본 설정으로
Qwen3-4B-Instruct-2507의
검열을 제거하는 데 약 20-30분이 걸립니다. Heretic은 bitsandbytes를 사용한 모델 양자화를
지원하며, 이는 모델을 처리하는 데 필요한 VRAM 양을 크게 줄일 수 있습니다.
양자화를 활성화하려면 quantization 옵션을 bnb_4bit로 설정하세요.
Heretic이 모델의 검열 제거를 완료한 후에는 모델 저장, Hugging Face에 업로드, 작동 테스트를 위한 채팅, 표준 벤치마크 실행, 또는 이들의 조합 중에서 선택할 수 있습니다.
Heretic은 방향성 제거의 매개변수화된 변형을 구현합니다. 지원되는 각 트랜스포머 구성 요소(현재는 attention out-projection과 MLP down-projection)에 대해, 각 트랜스포머 레이어에서 관련 행렬을 식별하고, 해당 "잔차 방향(residual direction)"에 대해 직교화하여, 해당 행렬과의 곱셈 결과에서 그 방향의 발현을 억제합니다.
잔차 방향은 각 레이어에 대해 "유해한" 예시 프롬프트와 "무해한" 예시 프롬프트의 첫 번째 토큰 잔차 간의 평균 차이(difference-of-means)로 계산됩니다.
제거 과정은 여러 최적화 가능한 파라미터로 제어됩니다:
direction_index: 잔차 방향의 인덱스이거나, 각 레이어가 해당 레이어와 연관된
잔차 방향을 사용하여 제거되어야 함을 나타내는 특수 값 per layer입니다.max_weight, max_weight_position, min_weight, min_weight_distance:
각 구성 요소에 대해 이 파라미터들은 레이어에 걸친 제거 가중치 커널의
모양과 위치를 설명합니다. 다음 다이어그램이 이를 보여줍니다: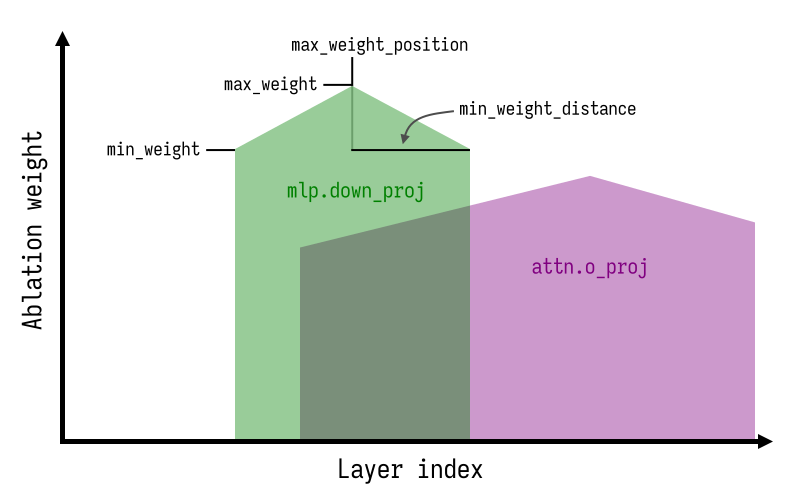
기존 ablation 시스템에 비한 Heretic의 주요 혁신은 다음과 같습니다:
제가 알고 있는 공개적으로 사용 가능한 ablation 기법 구현은 다음과 같습니다:
Heretic은 처음부터 작성되었으며, 위 프로젝트 중 어느 것의 코드도 재사용하지 않았습니다.
Heretic의 개발은 다음의 영향을 받았습니다:
