 noahware/binprotect
x64 PE bin2bin 난독화 도구로, 바이너리에 섹션을 추가하지 않습니다

빌드 지침은 4. 빌드를 참조하세요.
이 난독화 도구는 bin2bin 방식으로, 이미 컴파일된 실행 가능한 바이너리를 가져와 난독화 패스를 적용하여 재생성합니다. 이는 원본 소스 코드에 접근할 필요 없이 애플리케이션을 보호하는 데 사용될 수 있습니다. 현재는 x64 PE(이식 가능한 실행 파일) 파일만 지원되지만, 향후 다른 바이너리 형식(예: ELF)에 대한 지원을 추가할 계획이 있습니다.
현재 잘 알려진 모든 bin2bin 난독화 도구는 바이너리 끝에 섹션을 추가하여 난독화된 코드나 데이터를 그 안에 배치합니다. 이는 기존 섹션의 내용을 변경하지 않고 바이너리의 원래 레이아웃을 유지하기 위함입니다. 이 방법은 대부분의 RVA(상대 주소)가 유효하게 유지되므로 관리하기가 훨씬 쉽습니다.
이 프로젝트는 bin2bin에 독특한 접근 방식을 취하는데, 난독화된 코드나 데이터는 바이너리의 원래 섹션 내에 삽입됩니다. 이를 위해서는 애플리케이션의 모든 RVA를 추적해야 합니다. 이 접근 방식의 장점은 다음과 같습니다.
이 문서는 실행 가능한 바이너리의 재작성과 구현된 난독화 기술을 모두 설명합니다. 다음 난독화 기술이 구현되었습니다.
또한 이 프로젝트는 예외 지원(C++ 예외 및 SEH)을 제공하며 예외 처리가 있는 함수를 난독화할 수 있습니다.
바이너리 내 코드를 역어셈블하고 발견하는 데 도움을 주기 위해 심볼 파일(PDB 및 MAP 모두)을 선택적으로 허용합니다. 심볼 파일을 제공하는 것은 필수가 아니지만 복잡한 바이너리에서 역어셈블리에 도움이 됩니다. 예외 지원 및 제어 흐름 평탄화와 같은 일부 기능은 심볼 파일이 제공되어야 합니다.
바이너리 재작성기는 실행 가능한 바이너리를 가져와 내부의 코드나 데이터를 변경하여 변경 사항이 적용된 출력 바이너리를 생성합니다.
난독화된 코드가 바이너리의 원래 섹션에 직접 삽입되므로 프로그램의 상대 주소를 추적하여 이에 대한 모든 참조를 조정할 수 있도록 해야 합니다. 이는 코드와 데이터가 삽입된 후에도 참조가 동일한 위치를 가리키도록 하기 위함입니다. 그렇지 않으면 데이터나 코드가 잘못된 위치에서 액세스되어 출력 바이너리의 동작이 변경되고 심각한 불안정이 발생할 수 있습니다.
상대 주소에 대한 참조가 발견될 때마다(예: rip 상대 피연산자를 포함하는 명령어 또는 PE 데이터 디렉터리) 추적 목록에 추가되어 재작성 마지막에 업데이트됩니다. 참조가 발생하는 RVA(참조를 업데이트할 위치를 알기 위해)와 참조되는 RVA(참조를 어떤 RVA로 업데이트할지 알기 위해)가 추적됩니다.
역어셈블러가 rip 상대 명령어를 찾을 때마다 난독화 마지막에 업데이트할 참조 목록에 추가합니다. 이렇게 하면 해당 명령어들이 모두 원래 가리키던 위치를 계속 가리키게 됩니다. 점프 테이블과 같은 다른 상대 명령어 사례도 업데이트할 참조로 추가됩니다.
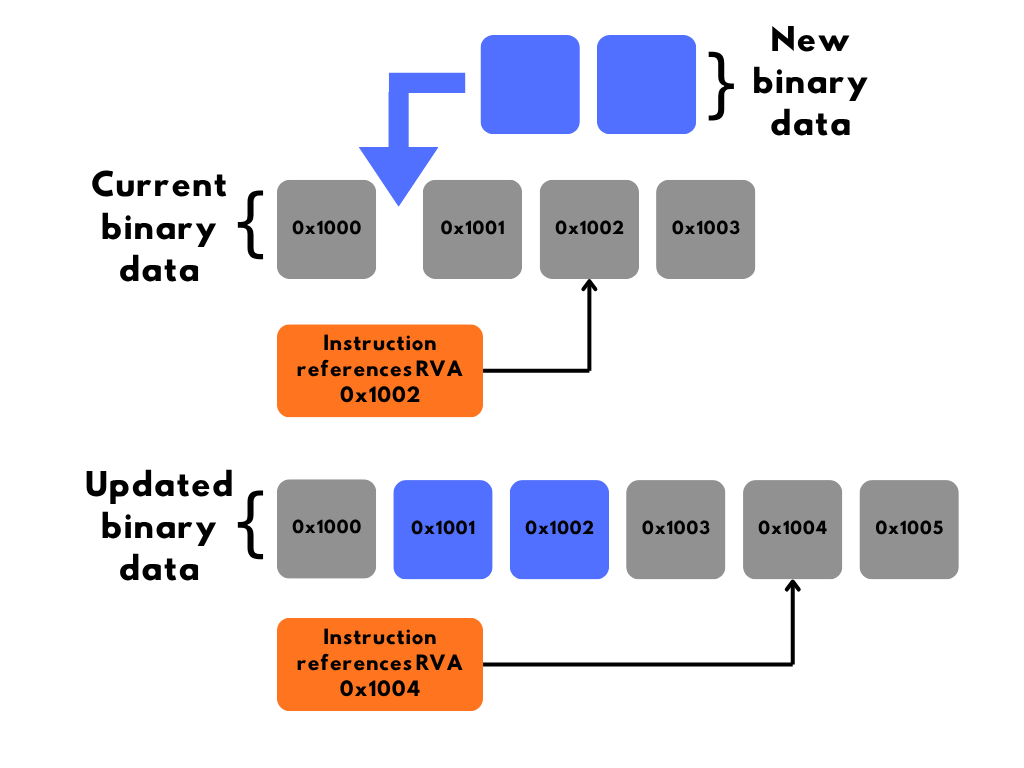
바이너리에 바이트가 삽입되거나 제거될 때마다 추적된 모든 RVA를 조정해야 합니다. 예를 들어, 다음은 바이트 삽입 핸들러입니다:```cpp
void binwrite::binary_t::insert(const rva_t rva, const std::span data, const bool inclusive)
{
buffer_.insert_range(buffer_.begin() + rva.value(), data);
update_rvas(rva, static_cast<rva_t::size_type>(data.size()), inclusive);
}
`update_rvas`는 바이너리에서 발생한 변경 사항을 반영하기 위해 추적된 모든 RVA가 업데이트되는 곳입니다. 다음은 이 과정의 다이어그램입니다:
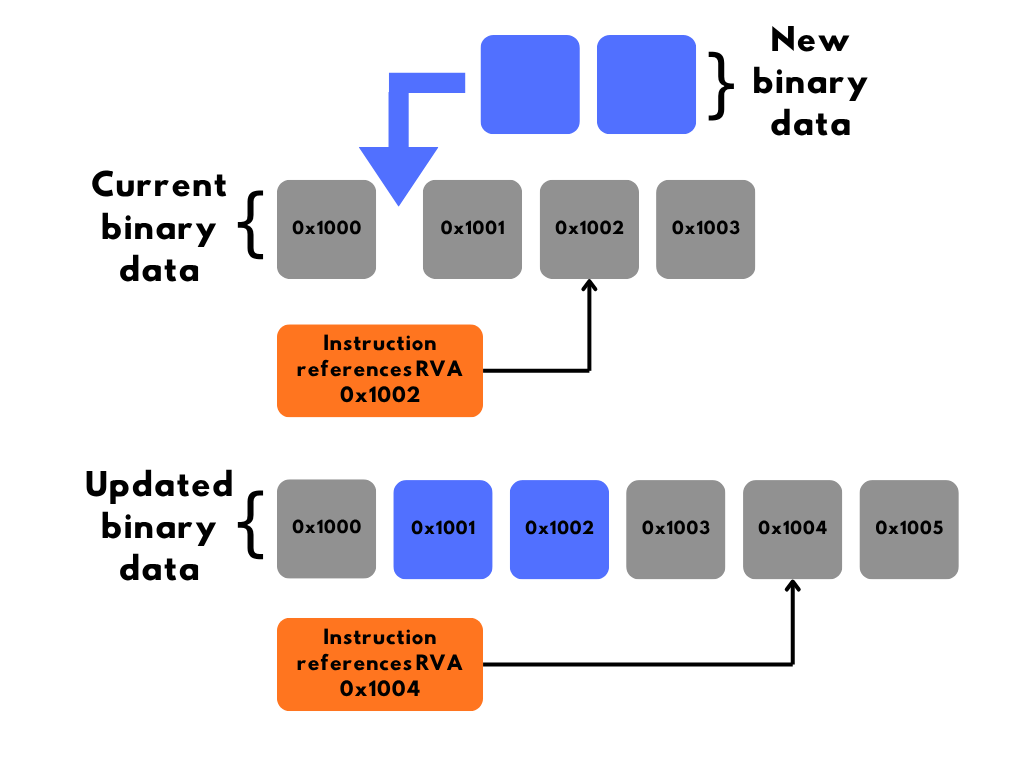
그림 1. 상대 주소 추적.
삽입된 데이터(파란색)는 현재 데이터(회색)를 이동시킵니다. 명령어가 참조하는 RVA(주황색)는 삽입된 데이터(파란색)를 고려하여 동일한 메모리를 가리키도록 업데이트됩니다.
## 2.2. 디스어셈블리
잠재적인 코드 항목(내보내기, 진입점, 코드 섹션을 가리키는 재배치 등)은 모두 디스어셈블리 큐에 추가됩니다. 기호 파일이 있는 경우, 기호 파일이 설명하는 모든 함수도 디스어셈블리 큐에 추가됩니다. 큐의 각 항목은 개별 기본 블록으로 처리됩니다.
기본 블록은 분기가 없는 명령어 그룹입니다. 즉, 제어 흐름 명령어(예: 점프, 리턴, 인터럽트)에서 종료됩니다. 기본 블록은 호출에서 종료되지 않습니다. 대부분의 경우 호출된 함수가 반환될 것으로 예상되기 때문입니다. 일부 함수는 반환되지 않으며(예: _CxxThrowException), 앞으로 'noreturn' 호출이라고 부릅니다.
디스어셈블리 큐의 기본 블록이 처리될 때, 각 명령어는 위에서부터 다음 중 하나가 발생할 때까지 디스어셈블됩니다:
- 이미 분석된 다른 기본 블록에 도달하여 중복이 발생합니다. "기본 블록 분할" 참조.
- 종결 명령어가 발견됨(점프, 리턴, 인터럽트).
- 명령어 디스어셈블 실패.
- 코드 패딩이 발견됨.
다음은 디스어셈블리 및 디스어셈블리 큐 진입의 다이어그램입니다(다이어그램에서 코드 패딩 검사는 생략됨). 이 과정은 디스어셈블리 큐가 비워질 때까지 반복됩니다.
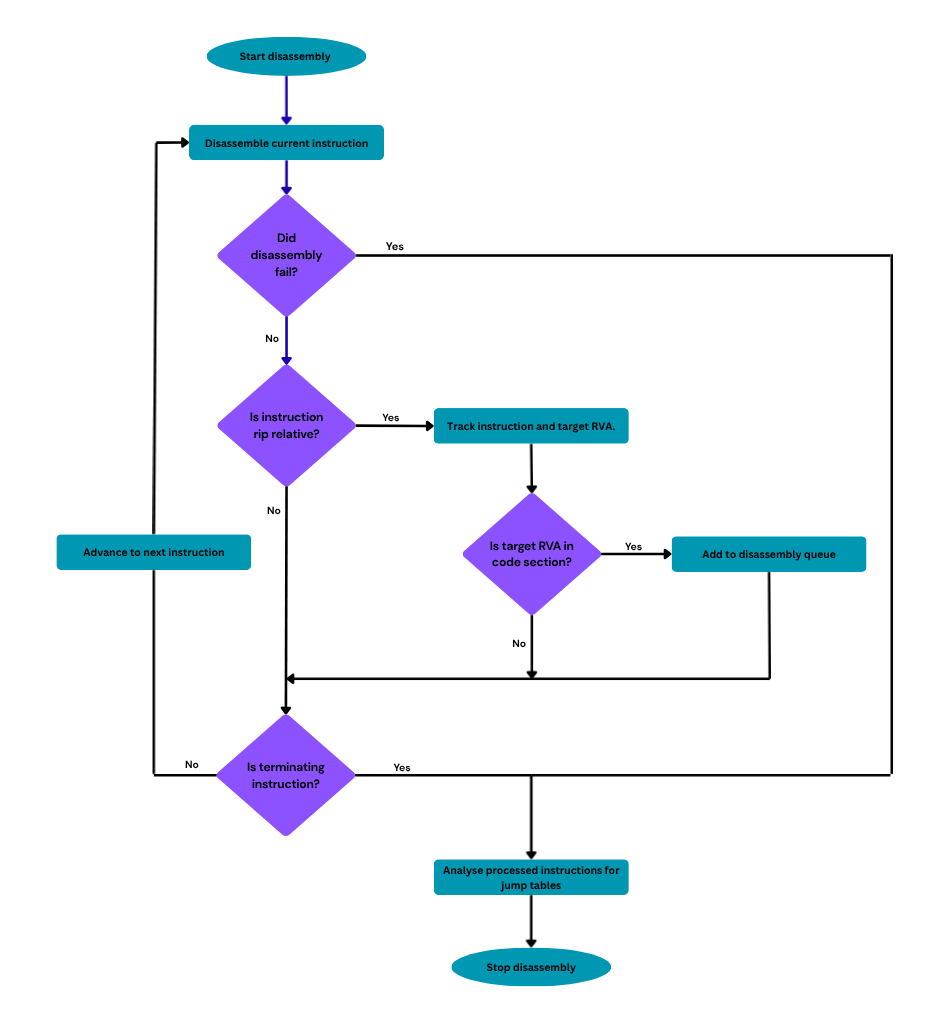
그림 2. 디스어셈블리 처리.
### 2.2.1 기본 블록 분할
두 기본 블록이 중복되면 그중 하나를 분할해야 합니다. 이렇게 하면 두 블록이 동일한 명령어를 기술하는 것을 방지합니다. 예:```asm
wcslen proc
or rax, 0FFFFFFFFFFFFFFFFh
loc_140001078:
inc rax
cmp word ptr [rcx+rax*2], 0
jnz short loc_140001078
retn
wcslen endp
이것은 와이드 문자열의 길이를 구하는 wcslen의 구현입니다. 첫 번째 명령어 'or rax, FFFFFFFFFFFFFFFF'가 기본 블록의 시작으로 디스어셈블되면, 'retn'까지 디스어셈블을 계속합니다.
'jnz loc_140001078'는 루프를 형성하기 위해 위로 점프합니다. 이는 참조로 추가되며, jnz의 대상과 fallthrough 분기(다음 명령어)가 디스어셈블 큐에 추가됩니다. 명령어가 이미 분석된 블록의 중간으로 점프하므로, 새 블록을 형성하고 다시 'retn'까지 디스어셈블하는 것은 중복된 표현을 초래하기 때문에 불가능합니다.
'jnz'(조건부 점프)는 또한 fallthrough 분기를 따라 새로운 기본 블록을 생성합니다. 이제 다음과 같은 4개의 기본 블록이 있습니다:
Block A:```asm
or rax, 0FFFFFFFFFFFFFFFFh
loc_140001078:
inc rax
cmp word ptr [rcx+rax*2], 0
jnz short loc_140001078
블록 B:```asm
loc_140001078:
    inc     rax
    cmp     word ptr [rcx+rax*2], 0
    jnz     short loc_140001078
블록 C:
from src.modules.blockchain import Block
from src.modules.transaction import Transaction

# Example usage: Create a new block with some transactions
transactions = [
    Transaction("address1", "address2", 10.0),
    Transaction("address2", "address3", 5.0)
]
genesis_block = Block(0, "0" * 64, transactions)
print(genesis_block.hash)
``````asm
    retn
Block D:```asm
retn
이는 기본 블록의 잘못된 표현입니다. 동일한 명령어가 4개의 블록에 걸쳐 중복되기 때문입니다. 이는 현재 디스어셈블리와 겹치는 모든 기본 블록을 분할함으로써 수정할 수 있습니다. 더 이상 중복된 명령어가 없을 것입니다. 각 중복 지점에서 명령어의 중복 표현을 생성하는 대신, 기존 명령어가 새로운 기본 블록으로 전송되기 때문입니다. 분할을 사용한 올바른 표현은 다음과 같습니다:

Block A:```asm
    or      rax, 0FFFFFFFFFFFFFFFFh
블록 B:```asm
inc rax
cmp word ptr [rcx+rax*2], 0
jnz short loc_140001078
블록 C:```asm
    retn
점프 테이블은 switch 문의 핸들러 주소를 저장하는 데 사용됩니다. switch 문의 각 case에 대해 많은 if 문/조건부 점프를 사용하는 대신, case 문 핸들러의 주소 테이블을 보관합니다. 다음은 예시입니다 (LLVM/CLANG 바이너리):```cpp
std::int32_t sub_140004080(const std::int32_t a1)
{
std::int32_t result;
switch ( a1 )
{
case 0:
result = 9;
break;
case 1:
result = 4;
break;
case 2:
result = 3;
break;
case 3:
result = 1;
break;
default:
result = 0;
break;
}
return result;
}
이 switch 문은 다음과 같은 어셈블리로 컴파일됩니다:```asm
; ecx = a1
cmp     ecx, 3 ; check if above bounds, must be default case
ja      short def_140004097 ; goto default if a1 above 3
mov     ecx, ecx
mov     eax, ecx
lea     rcx, jpt_140004097
movsxd  rax, ds:(jpt_140004097 - 140004100h)[rcx+rax*4] ; select correct index of jump table for a1
add     rax, rcx
jmp     rax ; goto index specified - the case handler

jpt_140004097:
dd offset loc_140004099 - 140004100h ; address of handler for first case
dd offset loc_1400040D5 - 140004100h ; address of handler for second case
dd offset loc_1400040BD - 140004100h ; address of handler for third case
dd offset loc_1400040C9 - 140004100h ; address of handler for fourth case
'a1' 값은 case 문의 최대값과 비교되며, 그보다 크면 바로 기본 핸들러로 이동합니다. a1이 case 범위 내에 있으면 점프 테이블의 해당 항목에 접근하여 계산된 핸들러 주소로 점프합니다.
점프 테이블 항목과 점프 테이블에 대한 참조는 추적되어 그대로 유지됩니다.
점프 테이블이 switch 문이 사용할 수 있는 모든 값 범위를 설명하지 않는 경우, 제한된 테이블을 사용하여 한계를 확인합니다. 이는 범위를 벗어나면 switch를 기본 문으로 리디렉션하기 위한 것입니다. case 문의 개수를 파싱하기 위해 비교 명령어를 확인하여 항목 수를 찾습니다. 예를 들어, 'cmp ecx, 3' 명령어는 점프 테이블의 항목 수가 3임을 나타냅니다.
점프 테이블이 case 문이 될 수 있는 모든 가능한 값을 채우는 경우(예: UINT8 유형의 경우 UINT8 최소값부터 UINT8 최대값까지), 한계 확인이 없는 무제한 테이블을 사용합니다. 이는 컴파일러가 점프 테이블이 모든 가능한 값을 포함한다는 것을 알기 때문입니다. 점프 테이블 항목 수를 암시하는 비교 명령어가 없으므로 항목을 브루트 포스해야 합니다. 테이블의 기준점에서 코드 섹션 내의 유효한 RVA를 점진적으로 확인하고 각 유효한 항목을 추적합니다. 이는 다른 데이터/명령어를 점프 테이블 항목으로 파싱할 수 있기 때문에 안전하지 않으므로, 가능한 경우 제한된 점프 테이블 확인이 사용됩니다.
