 nil0x42/duplicut
방대한 단어 목록에서 중복을 제거하되, 정렬하지 않습니다 (사전 기반 암호 크래킹용)




현재, 비밀번호 단어 목록 생성은 일반적으로 여러 데이터 소스를 연결하는 것을 의미합니다. 이상적으로는 가장 가능성 높은 비밀번호가 단어 목록의 시작 부분에 있어야 하므로 가장 흔한 비밀번호가 즉시 크랙됩니다.
기존의 중복 제거 도구를 사용하면 순서를 유지하거나 대규모 단어 목록을 처리하는 것 중 하나를 선택해야 합니다.
불행히도, 단어 목록 생성에는 두 가지가 모두 필요합니다
그래서 저는 이 특정 요구를 해결하기 위해 고도로 최적화된 C로 duplicut을 작성했습니다 🤓 💻
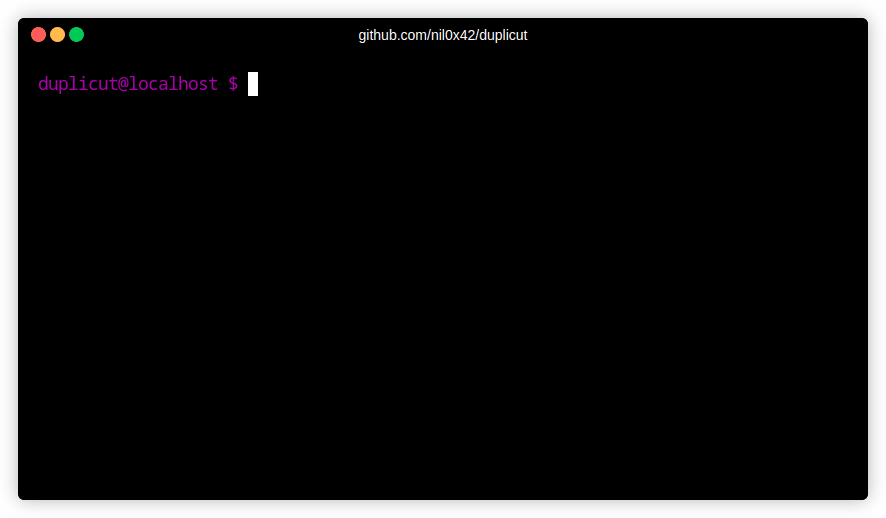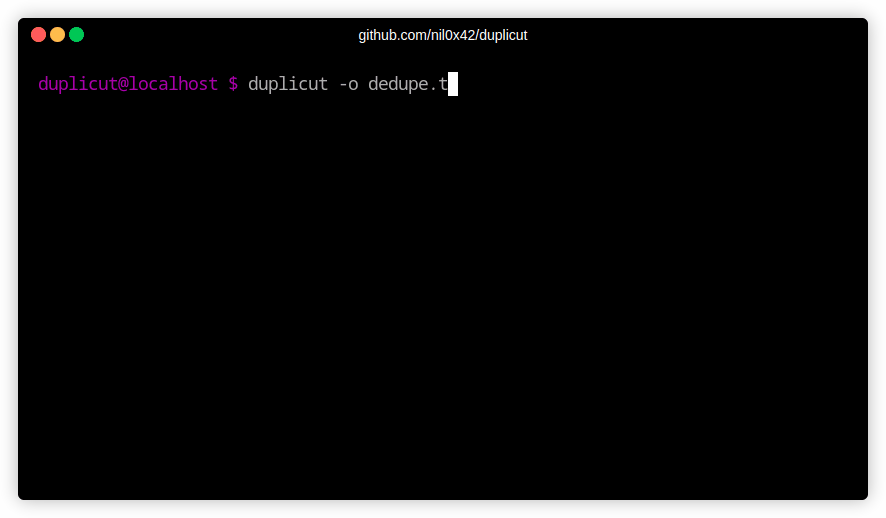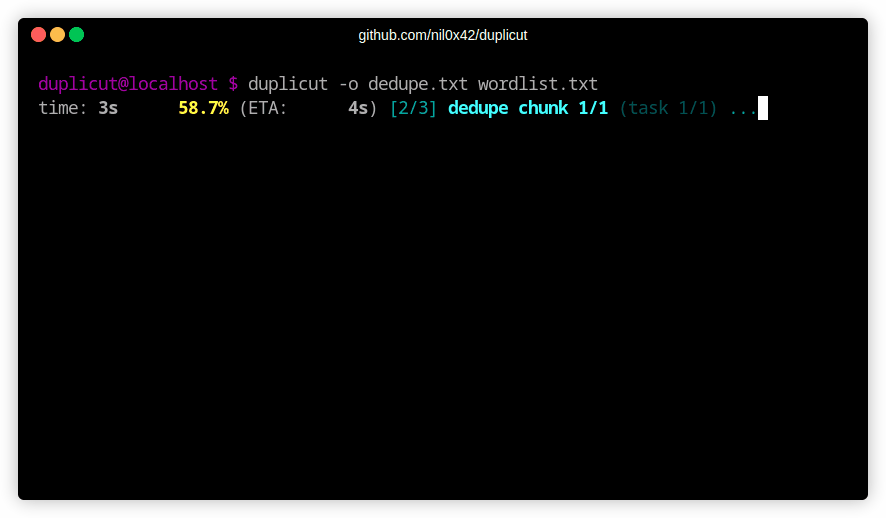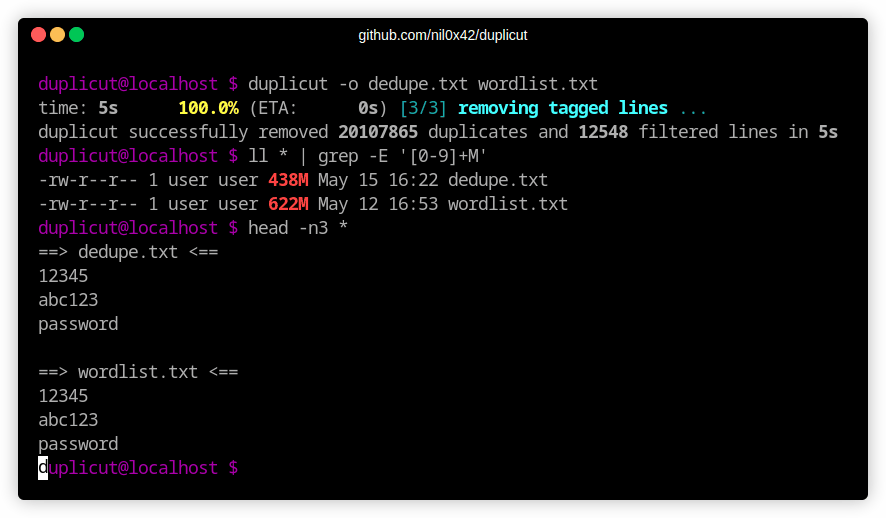
git clone https://github.com/nil0x42/duplicut  # download ...
cd duplicut/ && make                           # compile ...
./duplicut wordlist.txt -o clean-wordlist.txt  # dedupe !!!
-o, --outfile <FILE>       Write result to <FILE>
-t, --threads <NUM>        Max threads to use (default max)
-m, --memlimit <VALUE>     Limit max used memory (default max)
-l, --line-max-size <NUM>  Max line size (default 1024, max 4095)
-p, --printable            Filter ascii printable lines
-c, --lowercase            Convert wordlist to lowercase
-C, --uppercase            Convert wordlist to uppercase
-D, --dupfile <FILE>       Write dupes to <FILE> (slows down duplicut)
-h, --help                 Display this help and exit
-v, --version              Output version information and exit
기능:
--line-max-size 옵션)--printable 옵션)--dupfile 옵션)--lowercase 또는 --uppercase 옵션으로 대소문자 무시구현:
제한 사항:
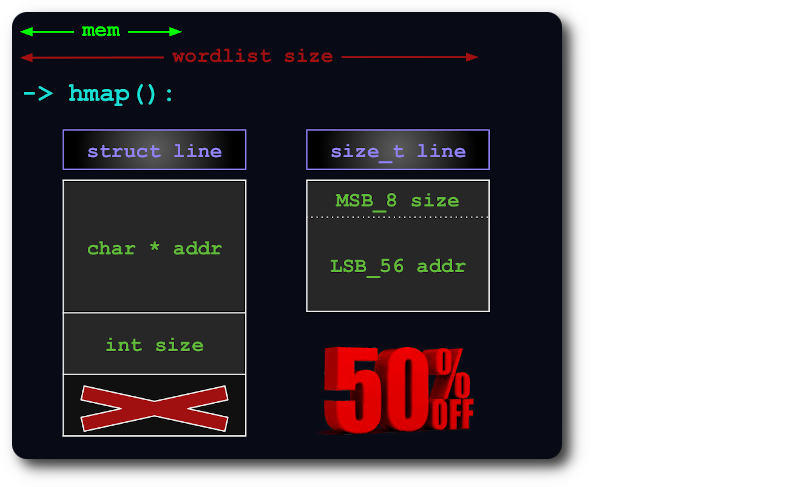
--line-max-size는 4095를 초과할 수 없음uint64 하나면 포인터의 추가 비트 내에 size 정보를 압축하여 해시맵에서 줄을 인덱싱할 수 있습니다:

전체 파일이 메모리에 맞지 않는 경우, 각 청크가 가능한 한 많은 RAM을 사용하도록  개의 가상 청크로 분할됩니다.
그런 다음 각 청크를 해시맵에 로드하고 중복을 제거하며 후속 청크에 대해 테스트합니다.
이렇게 하면 실행 시간이 최대 번째 삼각수로 줄어듭니다:

버그를 발견했거나 예상대로 작동하지 않는 경우, duplicut을 디버그 모드로 컴파일하고 출력을 첨부하여 이슈를 게시해 주세요:
# debug level can be from 1 to 4
make debug level=1
./duplicut [OPTIONS] 2>&1 | tee /tmp/duplicut-debug.log
