 jonathansalwan/vmprotect-devirtualization
VMProtect 소프트웨어 보호를 다루기. 기호 실행 및 LLVM을 사용한 순수 함수의 자동 난독화 해제.

VMProtect 3.x로 보호된 순수 함수를 가상화 해제하기 위한 실험적 동적 접근 방식
VMProtect로 보호된 순수 함수를 가상화 해제하는 동적 접근 방식에 대한 몇 가지 노트를 공유합니다. 이 접근 방식은 가상화된 함수에 오직 하나의 기본 블록만 포함된 경우(크기와 무관) 매우 좋은 결과를 보여주었습니다. 이는 바이너리가 산술 연산을 보호할 때 흔히 발생하는 시나리오입니다. 하지만 대상 함수에 둘 이상의 기본 블록이 포함되면 이 접근 방식은 약간 더 실험적입니다. 그럼에도 불구하고 우리는 2개의 기본 블록을 포함한 샘플에서 바이너리 코드를 성공적으로 가상화 해제하고 재구성했으며, 이는 동적으로 작은 함수를 완전히 가상화 해제하는 것이 가능함을 시사합니다.
VMProtect은 비표준 아키텍처의 가상 머신을 통해 코드를 실행하여 보호하는 소프트웨어 보호 솔루션입니다. 이 보호 솔루션은 어셈블리 애호가에게 훌륭한 놀이터입니다 [0, 1, 2, 3, 4, 5, 6, 11]. 또한, 이미 이 보호를 공격하는 수많은 도구들이 존재합니다 [7, 8, 9, 12, 13]. 2016년에 우리는 Tigress 소프트웨어 보호 솔루션을 살펴보고 기호 실행과 LLVM을 사용하여 가상화를 무력화하는 데 성공했습니다. 이 접근 방식은 DIMVA 2018 [10]에서 발표되었으며, 이를 VMProtect에서 테스트해보고자 했습니다. 모든 바이너리에서 작동하는 마법 같은 솔루션은 없으며, 대상과 목표에 따라 항상 트레이드오프가 존재합니다. 이 작은 기여는 VMProtect에 의해 가상화된 순수 함수에 대한 동적 공격의 예를 제공하는 것을 목표로 합니다. 동적 공격의 주요 장점은 설계 상 자기 수정 코드, 키 및 피연산자 암호화 등 VMProtect의 일부 정적 보호를 무력화한다는 점입니다.
우리는 순수 함수를 유한한 경로를 가지며 부작용이 없는 함수로 간주합니다. 여러 개의 입력이 있을 수 있지만 출력은 하나뿐입니다. 아래는 순수 함수의 예입니다:```cpp int secret(int x, int y) { int r = x ^ y; return r; }
# 접근 방식

우리는 난독화된 트레이스 T'(난독화된 코드 P'로부터)가 원래 코드 P의 명령어(원래 코드에서 T'에 해당하는 트레이스 T)와 가상 머신 VM의 명령어를 결합하여 T' = T + VM(T)와 같다는 핵심 통찰에 의존합니다. 이 두 명령어 하위 시퀀스 T와 VM(T)를 구별할 수 있다면, 트레이스 T'로부터 원래 프로그램 P의 한 경로를 재구성할 수 있습니다. 이 작업을 반복하여 가상화된 프로그램의 모든 경로를 포괄하면 원래 프로그램 P를 재구성할 수 있습니다. 실제 예제에서 원래 코드는 실행 가능한 경로의 유한한 개수를 가지며, 이는 지적 재산권 보호와 관련된 많은 상황에서 해당됩니다. 이를 위해 다음 단계를 수행합니다:

1. 가상화된 함수와 그 인자를 식별합니다.
2. 대상의 VMProtect 트레이스를 생성합니다.
3. VMP 트레이스를 재생하고 심볼릭 표현식을 구성하여 입력과 출력 간의 관계를 얻습니다.
4. 심볼릭 표현식에 최적화를 적용하여 VM의 명령어를 최대한 피합니다.
5. 심볼릭 표현을 LLVM-IR로 리프팅하여 대상의 새로운 보호되지 않은 버전을 구축합니다.

## 예제 1: 간단한 비트 연산

첫 번째 예제로 다음 함수를 살펴보겠습니다: 두 개의 입력을 받아 `x ^ y`를 반환하며, 이는 VMProtect로 보호됩니다.```cpp
int secret(int x, int y) {
  VMProtectBegin("secret");
  int r = x ^ y;
  VMProtectEnd();
  return r;
}
우리는 함수가 VMProtect를 사용하는 위치와 인수의 개수를 식별하는 것부터 시작합니다. 예를 들어 아래와 같은 상황이 있을 수 있습니다:
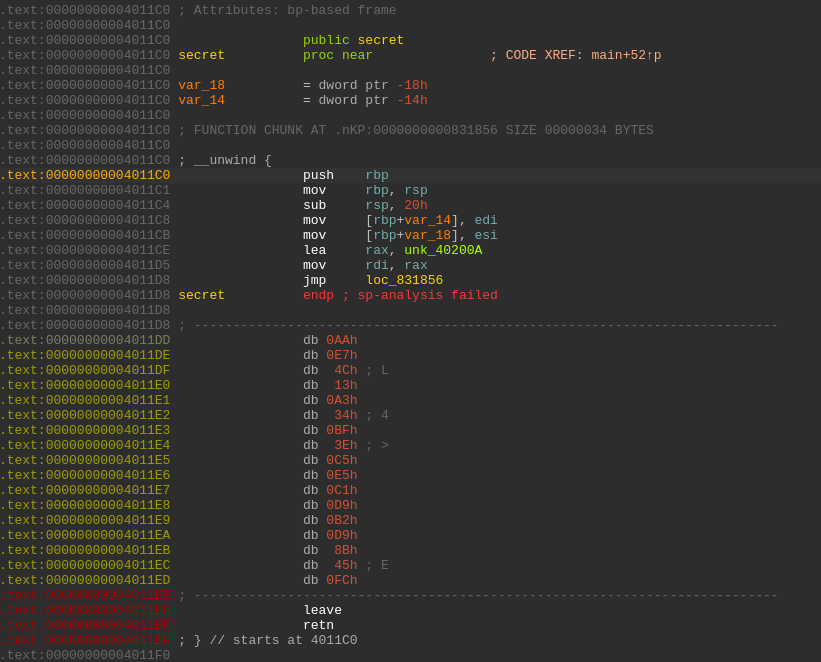
코드를 읽는 것만으로도 함수가 주소 0x4011c0에서 시작하고, 두 개의 32비트 인수(edi 및 esi)를 가지며, 0x4011ef에서 반환된다는 것을 알 수 있습니다. 이것이 우리에게 필요한 모든 리버스 엔지니어링입니다. 다음 부분은 자동으로 처리됩니다. 이제 이 가상화된 함수의 트레이스 실행을 생성해야 합니다. 이를 위해 Pintool을 사용합니다. 이 도구는 계측 범위를 나타내는 시작 및 종료 주소(예제의 경우 0x4011c0 및 0x4011ef)만 필요합니다. 모든 종류의 DBI나 에뮬레이터가 이 작업을 수행할 수 있습니다.```
$ ./pin/pin -t ./pin/source/tools/VMP_Trace/obj-intel64/VMP_Trace.so -start 4198848 -end 4198895 -- ./vmp_binaries/binaries/sample2.vmp.bin 1 2 &> ./vmp_traces/sample2.vmp.trace
결과는 [여기](https://github.com/jonathansalwan/vmprotect-devirtualization/blob/main/vmp_traces/sample2.vmp.trace)에서 확인할 수 있습니다. 트레이스 형식은 세 가지 종류의 연산을 사용합니다: `mr`, `r`, `i`.
`mr`는 명령어 `i`에 의해 수행된 메모리 읽기 접근이고, `r`은 CPU 레지스터입니다. 예를 들어:```
mr:0x7ffda459d718:8:0x227db4f8
r:0x40200a:0x0:0x7ffda459f571:0x2:0x40200a:0x0:0x0:0x7ffda459d688:0x0:0x0:0x7feee9b80ac0:0x7feee9b8000f:0xad1c3e:0x0:0x0:0x0
i:0x89173e:8:488BB42490000000
우리는 주소 0x7ffda459d718에서 8 바이트 상수 0x227db4f8를 로드하는 메모리 읽기가 있습니다.
명령어는 주소 0x89173e에서 실행되며, 8바이트 길이의 opcode는 488BB42490000000이고 이것은
mov rsi, qword ptr [rsp + 0x90]입니다.
실행 전 레지스터 상태는 다음과 같습니다:```python (1) RAX = 0x40200a (9) R8 = 0 (2) RBX = 0 (10) R9 = 0 (3) RCX = 0x7ffda459f571 (11) R10 = 0x7feee9b80ac0 (4) RDX = 0x2 (12) R11 = 0x7feee9b8000f (5) RDI = 0x40200a (13) R12 = 0xad1c3e (6) RSI = 0 (14) R13 = 0 (7) RBP = 0 (15) R14 = 0 (8) RSP = 0x7ffda459d688 (16) R15 = 0
VMP 추적이 생성되면 [attack_vmp.py](https://github.com/jonathansalwan/vmprotect-devirtualization/blob/main/attack_vmp.py) 스크립트를 사용하여 이를 재생합니다. 이 스크립트는 [Triton](https://github.com/jonathansalwan/Triton)을 사용하여 추적의 경로 술어를 구축합니다. 기호 변수(함수의 입력)를 포함하는 모든 표현식은 기호로 유지되며, 입력과 관련 없는 표현식은 구체화됩니다. 즉, 기호 표현식에는 가상 머신(기계 자체는 사용자에 의존하지 않음)과 관련된 연산이 포함되지 않고 원래 프로그램과 관련된 연산만 포함됩니다.

예를 들어, 아래는 구체화의 예입니다. 왼쪽에는 기호 변수를 포함하지 않는 하위 표현식(`1 + 2` 및 `6 ^ 3`)이 포함된 AST가 있습니다. 따라서 이러한 분기는 구체화되어 상수 `3` 및 `5`로 대체되어 오른쪽의 AST가 됩니다. **이것이 코드를 역가상화하는 방법입니다.**

<p align="center">
  <img src="https://assets.kitploit.com/production/public/readmes/8096/857ed50cfe9cb2347f816ece1d8dc4c13174c971dcb65ebc5621be14269a5ca8.png">
</p>

**수식 수준 역방향 슬라이싱에 대한 참고 사항**: 기호 실행에서 일반적인 것처럼 기호 표현은 먼저 경로를 따라 순방향으로 계산된 다음, 최종 결과나 따라간 경로에 영향을 미치지 않는 모든 논리 연산 및 정의가 기호 표현식에서 제거됩니다(수식 슬라이싱, 일명 수식 가지치기). 이는 프로그램 출력에서 역방향 슬라이싱 코드 분석과 동등한 작업을 수식에 수행합니다. 따라서 `secret` 함수의 반환 시점에 VMProtect의 명령어 없이 입력과 출력 간의 관계에 대한 표현식을 얻을 수 있습니다.

`./attack_vmp.py` 스크립트는 추적 파일과 기호 변수의 크기를 매개변수로 사용합니다. `edi`와 `esi`였으므로 각각 4바이트 길이입니다. 스크립트의 결과는 다음과 같습니다.```
$ ./attack_vmp.py --trace1 ./vmp_traces/sample2.vmp.trace --symsize 4
[+] Replaying the VMP trace
[+] Symbolize inputs
[+] Instruction executed: 12462
[+] Emulation done
[+] Return value: 0x3
[+] Devirt expr: (bvor (bvnot (bvor (bvnot (bvnot x)) (bvnot y))) (bvnot (bvor (bvnot x) (bvnot (bvand (bvnot y) (bvnot y))))))
[+] Synth expr: (bvxor x y)

[+] LLVM IR ==============================

; ModuleID = 'tritonModule'
source_filename = "tritonModule"

define i32 @__triton(i32 %SymVar_0, i32 %SymVar_1) {
entry:
  %0 = xor i32 %SymVar_0, %SymVar_1
  ret i32 %0
}

[+] EOF LLVM IR ==============================
보시다시피, secret 함수가 반환하는 탈가상화된 표현식은 매우 간결하며 가상 머신의 명령어를 포함하지 않습니다.```smt
(bvor
(bvnot (bvor
(bvnot (bvnot x))
(bvnot y)
)
)
(bvnot (bvor
(bvnot x)
(bvnot (bvand
(bvnot y)
(bvnot y)
)
)
)
)
)
하지만 우리는 간단한 `XOR` 연산이었던 원래 표현식을 복구하지 못했습니다. `XOR`이 비트 연산으로 변환된 것 같습니다. 다행히도, 우리는 최근 Triton 프로젝트에 [합성기(synthesizer)](https://github.com/JonathanSalwan/Triton/issues/1074)와 [LLVM-IR](https://github.com/JonathanSalwan/Triton/issues/1078)로의 리프터(lifter)라는 새로운 기능을 출시했습니다. 따라서 우리는 표현식을 합성하여 `(bvxor x y)` 표현식을 얻을 수 있습니다. 이것은 좋은 성과이며, 이제 이 표현식을 LLVM-IR으로 리프팅한 후 새로운 탈가상화(devirtualized) 바이너리 코드를 컴파일하는 더 나아갈 수 있습니다.


## 예시 2: 보호된 MBA 연산
