
 jev-sec/jev-ids
TypeSafe의 Jev 기반의 초고속 토큰 효율적 침입 탐지 시스템(IDS).


단 한 번의 요청으로 침입 탐지. TypeSafe의 Jev에게 네트워크 플로우 하나와 레이블이 지정된 예시 다섯 개를 보여주세요. 해당 플로우가 공격인지, 어떤 종류인지를 0.5초 만에 파싱할 텍스트 없이 답합니다.
Jev IDS는 사이버보안 커뮤니티의 참조 벤치마크인 NSL-KDD에서 최신 LLM(Gemini 3.6 Flash on Vertex AI), 고전적 머신러닝 모델(Random Forest), 비지도 모델(Isolation Forest)과 비교 테스트되었습니다: 2,000개 플로우, 3개 시드, 카테고리당 0~8개의 예시(k). 동일한 다섯 개의 예시(k = 1)가 주어졌을 때, Jev IDS는:
LLM은 F1에서 더 나은 탐지기입니다: k = 1에서 0.880 대 Jev의 0.856이며, 모든 k에서 앞서 있습니다(McNemar p < 0.001). 이는 예시에 표시된 종류의 공격을 더 많이 잡아내기 때문입니다. Jev는 두 번째로 우수하며, 예시에 없는 종류인 제로데이 공격에서는 k = 1부터 k = 8까지 LLM보다 더 많이 잡아냅니다(k = 1에서 0.747 대 0.713). 수치, 그림 및 그 한계는 증거와 한계와 docs/results.md에 있습니다.
Jev는 System One Model입니다. 텍스트를 작성하는 대신 state를 읽고 그에 대한 타입이 지정된 질문에 확률로 답합니다. Jev IDS는 하나의 플로우를 지시사항, 컬럼 이름, 다섯 개의 카테고리 설명, 레이블이 지정된 예시와 함께 state에 넣고 두 가지 질문을 합니다. is_attack은 확률로 반환됩니다. category는 신뢰도와 함께 다섯 가지 옵션 중 하나로 반환됩니다. 확률이 0.5에 도달하면 공격으로 판정합니다.
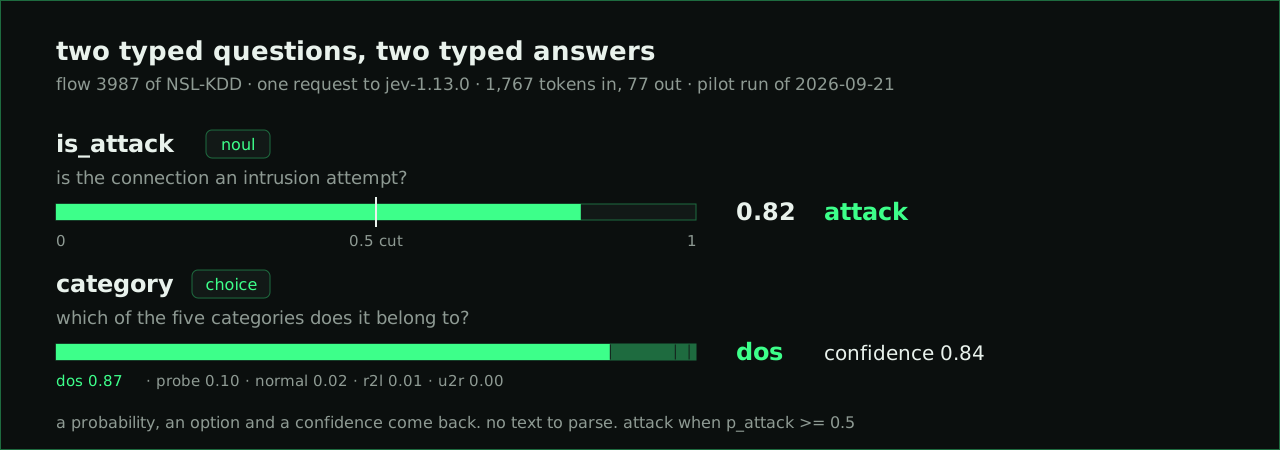
모든 요청은 동일한 경로를 따릅니다:
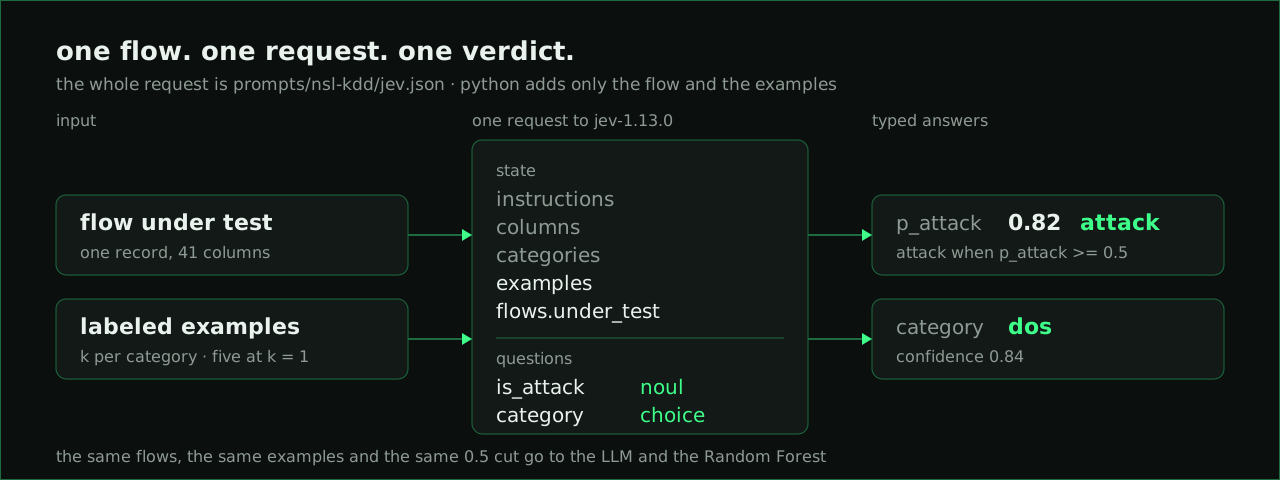
전체 요청은 하나의 파일, prompts/nsl-kdd/jev.json입니다. Python은 플로우와 예시만 추가하며, 파일의 sha256은 모든 예측 행에 prompt_hash로 전달되므로 서로 다른 것을 요청한 실행이 동등하게 비교되는 일은 없습니다. 예시는 카테고리로만 레이블이 지정됩니다: neptune과 같은 공격 이름은 결코 모델에 도달하지 않습니다.
동일한 플로우, 예시 및 0.5 컷이 두 개의 베이스라인에 전달됩니다: JSON 출력 스키마를 가진 Agno 에이전트를 통한 LLM(논문에서는 Vertex AI를 통한 Gemini 3.6 Flash; 대안으로 ChatGPT Codex 백엔드를 통한 GPT-5.6 또는 DeepSeek)과 동일한 예시로 훈련된 scikit-learn Random Forest입니다. 세 번째 베이스라인인 Isolation Forest는 풀의 정상 플로우에만 적합되며 결코 예시를 보지 않습니다: 이는 비지도 참조로, k = all에서만 해당됩니다.
git clone https://github.com/jev-sec/jev-ids.git
cd jev-ids
uv sync
# .env: TYPESAFE_API_KEY for Jev. Gemini needs `gcloud auth application-default login` and GOOGLE_GENAI_USE_VERTEXAI=true,
# GOOGLE_CLOUD_PROJECT and GOOGLE_CLOUD_LOCATION=global in the environment; DEEPSEEK_API_KEY and CHATGPT_CLIENT_ID only for the other LLMs.
NSL-KDD를 data/raw/nsl-kdd/에 다운로드하고 한 번 준비하세요:
uv run python -m scripts.prepare_nsl_kdd
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split smoke --k 0,1
smoke 분할은 다섯 개의 플로우입니다. 실행은 results/<timestamp>-nsl-kdd-jev-smoke/에 config.json, predictions.jsonl의 플로우당 하나의 JSON 행(판정, 정답, p_attack, 카테고리, 신뢰도, 지연 시간 및 게이트웨이의 토큰 보고서)과 responses.jsonl의 원시 답변을 기록합니다.
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split pilot --k 0,1,2,4,8 --seeds 0,1,2
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector llm:gemini --model gemini-3.6-flash --split pilot --k 0,1,2,4,8
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector random_forest --split pilot --k 1,2,4,8,all
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector isolation_forest --split pilot --k all
uv run jev-ids metrics results/<run_id> [results/<run_id> ...] > results/summary.csv
uv run jev-ids compare --a results/<jev_run> --b results/<rf_run> --subset novel --k-a 0 --k-b all  # novel = zero-day attacks
k는 카테고리당 레이블이 지정된 예시의 수입니다. 다섯 개 카테고리에서 k = 1은 다섯 개의 예시를 의미하며, all은 전체 풀을 의미합니다. metrics는 탐지기와 k당 하나의 CSV 행을 출력하며 F1, 제로데이 공격에 대한 재현율(코드에서 novel) 및 카테고리별 재현율, p_attack의 PR-AUC와 ROC-AUC, 토큰, 지연 시간 및 비용을 포함합니다. compare는 두 실행을 플로우별로 짝지어 불일치 쌍에 대해 McNemar 검정을 실행합니다. 두 탐지기가 불일치하는 플로우만이 이들을 구별하기 때문입니다. 비용은 모든 탐지기에 대해 동일하게 prices.json의 정가에 토큰을 곱하여 오프라인으로 계산됩니다.
docs/protocol.md는 입력(2,000개 플로우의 paper 분할, 프롬프트, 모델 ID, 가격)을 고정하며, make paper는 해당 분할에 대해 네 개의 탐지기를 실행하여 results/paper/에 저장하고 results/paper/summary.csv를 작성합니다. 각 탐지기는 자체 타겟(make paper-jev, make paper-llm, make paper-random-forest, make paper-isolation-forest)을 가지므로 별도의 터미널에서 실행할 수 있습니다; LLM이 느린 쪽입니다. make paper-llm은 Vertex AI에서 Gemini 3.6 Flash를 k당 하나씩 다섯 개의 병렬 프로세스로 실행합니다(make -j5 paper-llm); 할당량 오류나 타임아웃은 오류 행이 되며, uv run jev-ids redo-errors results/paper/<run>이 해당 플로우를 제자리에서 다시 판정합니다. 전체 표와 그림은 docs/results.md에 있습니다.
error가 있는 행이 되며, 경보 없음으로 계산됩니다. 결코 충돌하지 않습니다.
