 jaidedai/easyocr
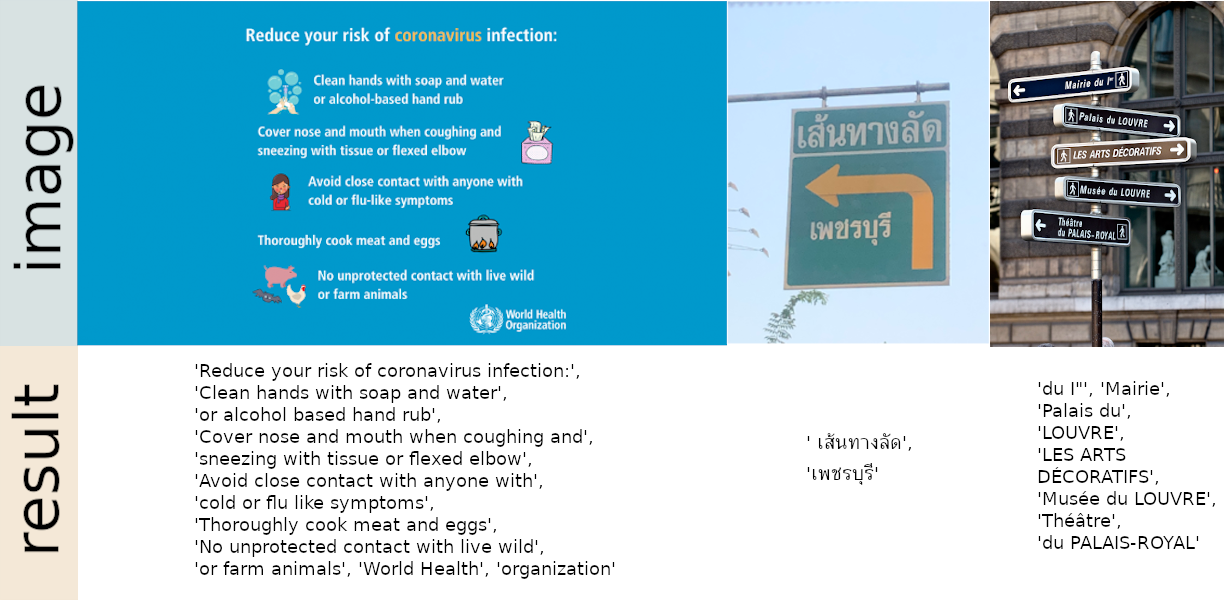
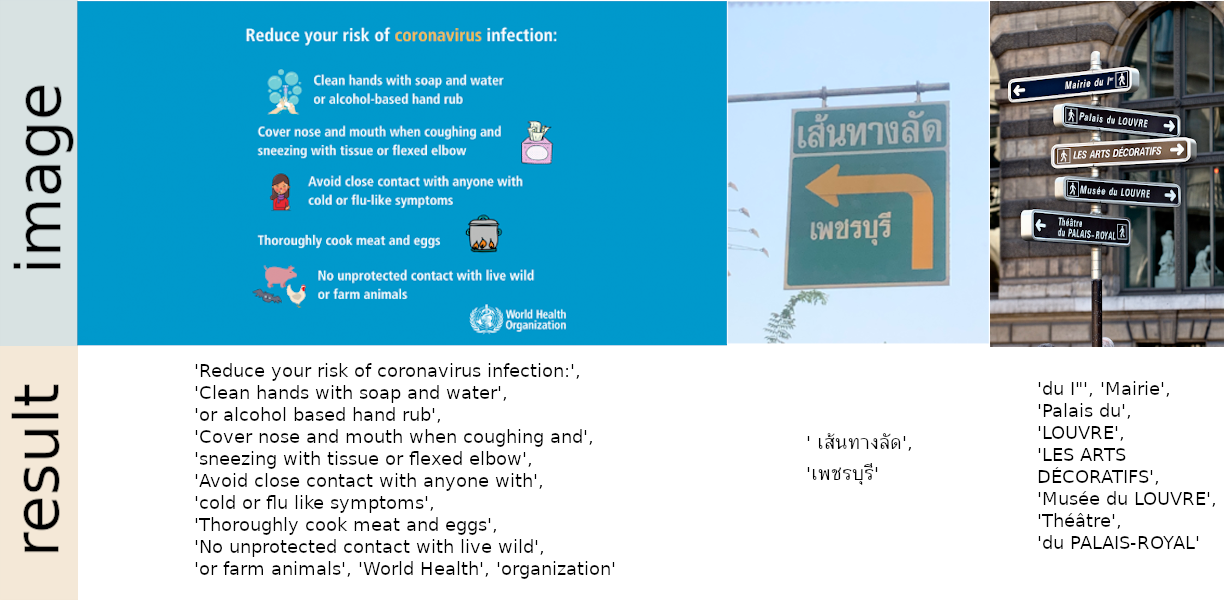
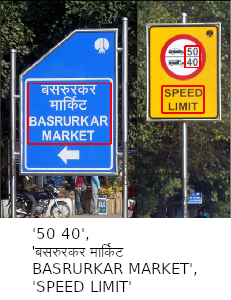
즉시 사용 가능한 OCR로, 80개 이상의 언어와 라틴 문자, 중국어, 아랍어, 데바나가리, 키릴 문자 등 모든 주요 문자 체계를 지원합니다.


80개 이상의 지원 언어와 라틴어, 중국어, 아랍어, 데바나가리, 키릴 문자 등 모든 주요 문자 체계를 지원하는 바로 사용 가능한 OCR입니다.
Gradio를 사용하여 Huggingface Spaces 🤗에 통합되었습니다. 웹 데모를 사용해 보세요:
2024년 9월 24일 - 버전 1.7.2
pip를 사용하여 설치
최신 안정 버전의 경우:
pip install easyocr
최신 개발 릴리스의 경우:
pip install git+https://github.com/JaidedAI/EasyOCR.git
참고 1: Windows의 경우, 여기 https://pytorch.org 의 공식 안내에 따라 먼저 torch와 torchvision을 설치하십시오. pytorch 웹사이트에서 사용 중인 CUDA 버전을 올바르게 선택해야 합니다. CPU 모드로만 실행하려는 경우 CUDA = None을 선택하십시오.
참고 2: 여기에 Dockerfile도 제공합니다.
참고 3: 선택적 DBNet 검출기(detect_network='dbnet18')는 처음 사용할 때 C++/CUDA 연산을 컴파일하며, 이를 위해서는 Ninja 빌드 도구가 필요합니다. EasyOCR과 함께 설치하려면 pip install "easyocr[dbnet]"을 사용하십시오.
import easyocr
reader = easyocr.Reader(['ch_sim','en']) # this needs to run only once to load the model into memory
result = reader.readtext('chinese.jpg')
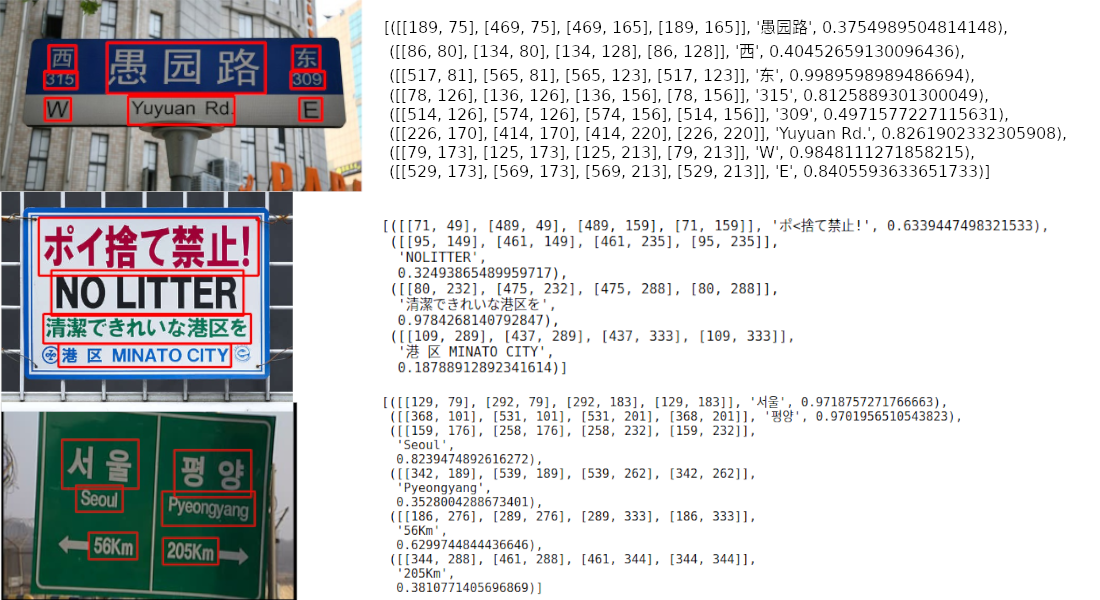
출력은 목록 형식이며, 각 항목은 각각 경계 상자, 감지된 텍스트, 신뢰도를 나타냅니다.
[([[189, 75], [469, 75], [469, 165], [189, 165]], '愚园路', 0.3754989504814148),
 ([[86, 80], [134, 80], [134, 128], [86, 128]], '西', 0.40452659130096436),
 ([[517, 81], [565, 81], [565, 123], [517, 123]], '东', 0.9989598989486694),
 ([[78, 126], [136, 126], [136, 156], [78, 156]], '315', 0.8125889301300049),
 ([[514, 126], [574, 126], [574, 156], [514, 156]], '309', 0.4971577227115631),
 ([[226, 170], [414, 170], [414, 220], [226, 220]], 'Yuyuan Rd.', 0.8261902332305908),
 ([[79, 173], [125, 173], [125, 213], [79, 213]], 'W', 0.9848111271858215),
 ([[529, 173], [569, 173], [569, 213], [529, 213]], 'E', 0.8405593633651733)]
참고 1: ['ch_sim','en']는 읽고자 하는 언어의 목록입니다. 여러 언어를 한 번에 전달할 수 있지만, 모든 언어를 함께 사용할 수는 없습니다. 영어는 모든 언어와 호환되며, 공통 문자를 공유하는 언어들은 보통 서로 호환됩니다.
참고 2: 파일 경로 chinese.jpg 대신 OpenCV 이미지 객체(numpy 배열)나 바이트 형태의 이미지 파일을 전달할 수도 있습니다. 원본 이미지의 URL도 허용됩니다.
참고 3: reader = easyocr.Reader(['ch_sim','en']) 줄은 모델을 메모리에 로드하기 위한 것입니다. 시간이 다소 걸리지만 한 번만 실행하면 됩니다.
더 간단한 출력을 위해 detail=0으로 설정할 수도 있습니다.
reader.readtext('chinese.jpg', detail = 0)
결과:
['愚园路', '西', '东', '315', '309', 'Yuyuan Rd.', 'W', 'E']
선택한 언어의 모델 가중치는 자동으로 다운로드되며, 또는 모델 허브에서 수동으로 다운로드하여 '~/.EasyOCR/model' 폴더에 넣을 수 있습니다.
GPU가 없거나 GPU 메모리가 부족한 경우 gpu=False를 추가하여 CPU 전용 모드로 모델을 실행할 수 있습니다.
reader = easyocr.Reader(['ch_sim','en'], gpu=False)
$ easyocr -l ch_sim en -f chinese.jpg --detail=1 --gpu=True
인식 모델의 경우, 여기에서 확인하세요.
검출 모델(CRAFT)의 경우, 여기에서 확인하세요.
reader = easyocr.Reader(['en'], detection='DB', recognition = 'Transformer')
핵심 아이디어는 어떤 최신 모델이든 EasyOCR에 연결할 수 있도록 하는 것입니다. 더 나은 검출/인식 모델을 만들기 위해 노력하는 수많은 천재들이 있지만, 우리는 여기서 천재가 되려는 것이 아닙니다. 우리는 단지 그들의 작업을 대중이 빠르게 접근할 수 있도록 하고 싶을 뿐입니다 ... 무료로요. (음, 우리는 대부분의 천재들이 자신의 작업이 가능한 한 빠르고 크게 긍정적인 영향을 미치기를 원한다고 믿습니다) 파이프라인은 아래 다이어그램과 같은 형태여야 합니다. 회색 슬롯은 교체 가능한 연한 파란색 모듈을 위한 자리 표시자입니다.
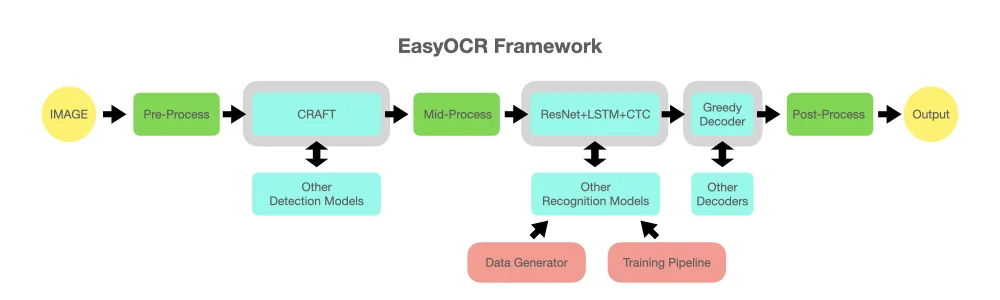
이 프로젝트는 여러 논문과 오픈소스 저장소의 연구 및 코드를 기반으로 합니다.
모든 딥러닝 실행은 Pytorch를 기반으로 합니다. ❤️
검출 실행은 이 공식 저장소와 그들의 논문에서 가져온 CRAFT 알고리즘을 사용합니다 (@clovaai의 @YoungminBaek에게 감사드립니다). 우리는 또한 그들의 사전 학습된 모델을 사용합니다. 학습 스크립트는 @gmuffiness가 제공했습니다.
인식 모델은 CRNN입니다 (논문). 이는 3가지 주요 구성 요소로 이루어져 있습니다: 특징 추출(현재 Resnet과 VGG를 사용 중입니다), 시퀀스 레이블링(LSTM), 그리고 디코딩(CTC)입니다. 인식 실행을 위한 학습 파이프라인은 deep-text-recognition-benchmark 프레임워크를 수정한 버전입니다. (@clovaai의 @ku21fan에게 감사드립니다) 이 저장소는 더 많은 인정을 받을 자격이 있는 보석입니다.
빔 서치 코드는 이 저장소와 그의 블로그를 기반으로 합니다. (@githubharald에게 감사드립니다)
데이터 합성은 TextRecognitionDataGenerator를 기반으로 합니다. (@Belval에게 감사드립니다)
그리고 distill.pub의 CTC에 관한 좋은 읽을거리는 여기에 있습니다.
AI를 모든 사람이 이용할 수 있게 함으로써 함께 인류를 발전시켜 나갑시다!
기여하는 3가지 방법:
코더: 작은 버그/개선 사항은 PR을 보내주세요. 더 큰 사항은 먼저 이슈를 열어 우리와 논의해 주세요. 'PR WELCOME' 태그가 붙은 가능한 버그/개선 이슈 목록이 있습니다.
사용자: EasyOCR이 귀하/귀하의 조직에 어떻게 도움이 되는지 알려주시면 추가 개발에 힘이 됩니다. 또한 이슈 섹션에 실패 사례를 게시하여 향후 모델 개선에 도움을 주세요.
기술 리더/구루: 이 라이브러리가 유용하다고 생각하셨다면 널리 알려주세요! (EasyOCR에 관한 Yann Lecun의 게시물을 참고하세요)
새로운 언어를 요청하려면 다음 2개의 파일과 함께 PR을 보내주셔야 합니다:
귀하의 언어에 고유한 요소(예: 1. 아랍어: 문자들이 서로 연결될 때 형태가 바뀌고 오른쪽에서 왼쪽으로 씀 2. 태국어: 일부 문자는 줄 위에, 일부는 아래에 있어야 함)가 있다면, 저희에게 최대한 알려주시고/알려주시거나 유용한 링크를 제공해 주세요. 정말로 작동하는 시스템을 만들기 위해서는 세부 사항을 신경 쓰는 것이 중요합니다.

