 iamavu/zairo
코드 diff를 컨텍스트와 함께 스캔하여 영향 그래프를 구축하고 LLM을 사용해 취약점을 찾아내며, 다중 저장소 스캔과 SARIF 출력을 통한 CI 게이팅을 지원합니다.

Diff 보안 스캐너는 변경 사항의 영향을 놓칩니다. Zairo는 그 영향을 찾아내고 취약점을 탐색합니다. Zairo는 컨텍스트를 포함해 코드에서 변경된 부분을 스캔하고, 확인할 수 있는 하위 그래프(subgraph)를 생성한 후 선택한 LLM을 사용해 취약점을 찾습니다.
pipx install zairo
# 아직 커밋하지 않은 모든 것을 스캔
zairo .

# PR/브랜치 diff 스캔
zairo . --base main --target HEAD

# 높은 심각도의 항목이 발견되면 빌드 실패 처리
zairo . --base main --target HEAD --fail-on high
추가 인수로 여러 저장소를 지정하거나 --repos-file에 한 줄에 하나씩 지정하면(또는 둘 다 지정해 하나의 목록으로 병합하면) 자동으로 멀티-리포 모드로 전환됩니다. 각 저장소는 자체 보고서를 받고, 추가로 하나의 통합 요약도 생성됩니다.
zairo backend frontend infra --base main --fail-on high -o zairo_multi_out
--base/--target(및 기타 모든 옵션)은 목록의 모든 저장소에 동일하게 적용되므로, 멀티-리포 모드는 모든 저장소가 동일한 기준(예: 모두의 main)과 diff할 때 가장 적합합니다. 규칙이 다른 저장소는 별도로 실행해야 합니다.
스캔 대상
--base, -b (없음): diff 기준이 되는 ref(예: main 또는 HEAD~3). 생략하면 zairo는 커밋되지 않은 변경 사항을 스캔합니다.--target, -t (없음): diff 대상 ref. --base가 필요합니다. (--base가 설정된 상태에서) 생략하면 작업 트리(working tree)와 diff합니다.--depth, -d (1): 각 변경 사항 주변의 영향 그래프에 포함할 호출자/피호출자 홉(hop) 수.--language, -l (auto): Trailmark가 자동 감지하도록 두지 않고 언어를 강제 지정.LLM 스캔
--graph-only (꺼짐): 취약점 스캔을 건너뛰고 영향 그래프만 구축합니다. 발견 항목이나 report.sarif가 생성되지 않습니다.--model (gemini/gemini-2.5-pro): 모든 LiteLLM 모델 문자열.--concurrency, -c (5): 단일 저장소 스캔 내에서의 병렬 LLM 요청 수.--batch-size (1): 이 수만큼의 노드를 단일 LLM 요청으로 그룹화합니다(노드당 한 번의 호출 대신). 요청 수가 줄어들어(공급자 속도 제한에 도움) 공유 장애 격리 비용이 발생합니다. 잘못되었거나 형식이 잘못된 응답은 해당 배치의 모든 노드를 실패시키며, 하나만 실패시키지 않습니다. 캐싱은 어느 쪽이든 노드별로 유지됩니다.--max-tokens (4096): 요청당 출력 예산. 추론 모델은 내부 사고에도 이를 소모하므로 빈 응답이 보이면 값을 높이세요.--cache / --no-cache (캐시 켜짐): 마지막 실행 이후 변경되지 않은 코드 재스캔 건너뛰기(<output>/.llm_cache.json에 콘텐츠 해시로 캐시됨).--tokens : 스캔에서 실제로 사용된 토큰 수 출력(캐시 적중은 호출을 하지 않았으므로 집계되지 않음).출력 및 게이팅
--output, -o (zairo_out): 보고서가 저장되는 위치. 멀티-리포 모드: 각 저장소는 자체 <output>/<repo-slug>/을 받고, 여기에 통합 rollup.*도 생성됩니다.--fail-on (없음): 이 심각도 이상의 발견 항목이 나타나면 0이 아닌 종료 코드 반환(low/medium/high/critical). --graph-only와 함께 사용하면 오류 발생(게이팅할 항목이 없음). 멀티-리포 모드: 모든 저장소를 합산해 확인. CI / PR 게이팅 참조.--verbose, -v (꺼짐): 단계별 진행 상황 출력(git 명령, 작업 트리 설정, 노드별 스캔 진행률).--debug, : 가 출력하는 모든 것에 더해, 모든 노드에 대해 LLM에 전송된 정확한 프롬프트와 원시 응답까지 출력합니다. 콘솔에 출력하기엔 너무 많으므로 에 기록됩니다(멀티-리포 모드에서는 저장소별로).멀티-리포 모드 전용
--repos-file (없음): 한 줄에 하나의 저장소 경로(# 주석 허용), 직접 지정한 저장소와 병합됩니다.--repo-concurrency (1): 동시에 스캔할 저장소 수. 진행 중인 총 LLM 요청 수는 --concurrency × --repo-concurrency에 도달할 수 있으므로 공급자의 속도 제한에 유의하세요. 1보다 크면 실시간 단계별 세부 정보 대신 완료 시 저장소당 요약 한 줄씩 진행률이 출력됩니다.--continue-on-error / --stop-on-error (계속): 한 저장소가 실패할 때 나머지 목록을 계속 스캔할지, 중지할지 선택. 어느 쪽이든 실패한 저장소는 전체 종료 코드를 실패로 만듭니다.CLI에서도 언제든지 zairo --help를 실행하면 동일한 목록을 볼 수 있습니다.
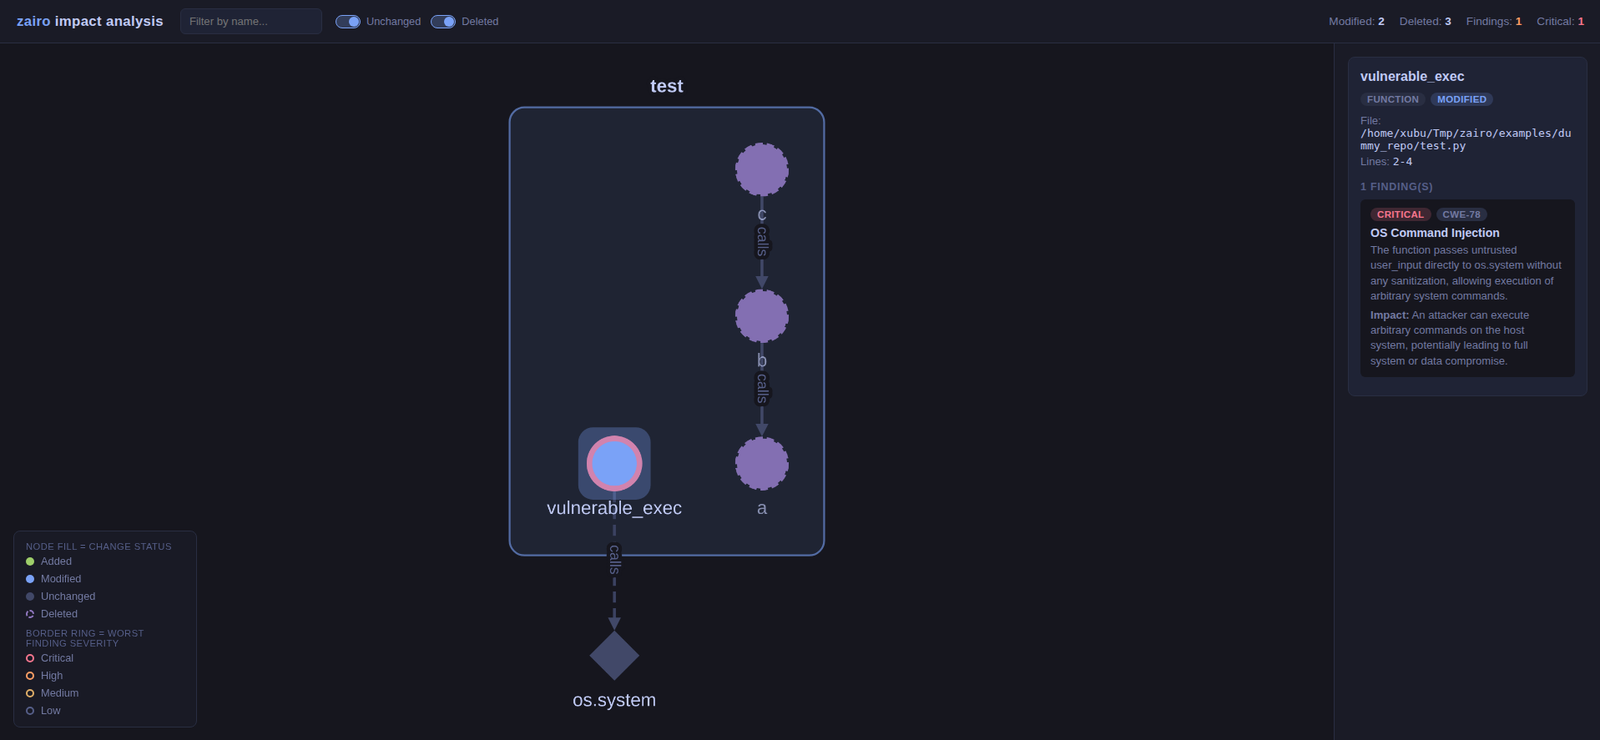
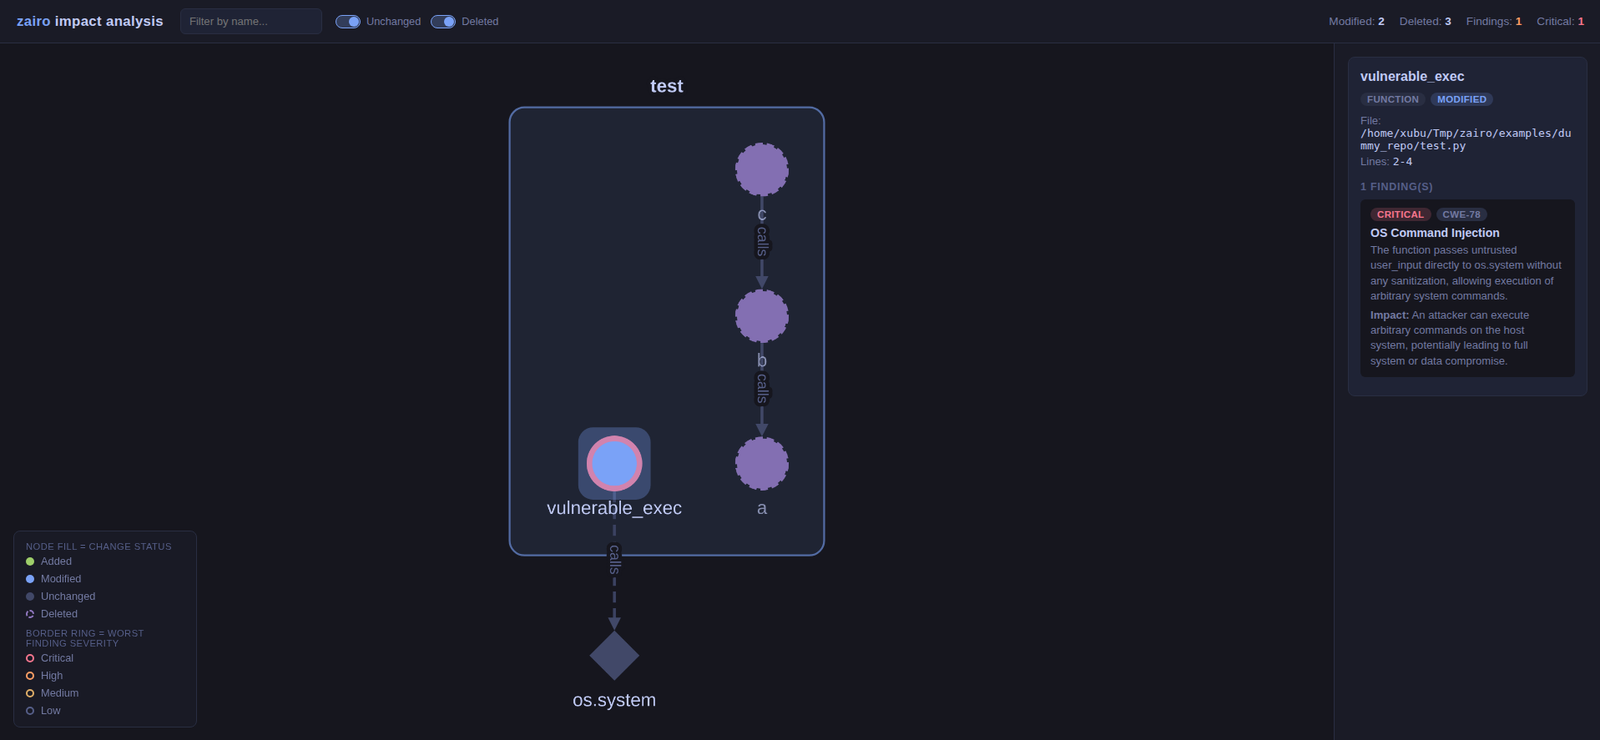
report.json (항상): 원시 영향 그래프(노드, 엣지, 첨부된 발견 항목)를 데이터로 포함.report.html (항상): 자체 포함된 대화형 의존성 그래프 뷰어(Cytoscape.js). 노드를 클릭하면 해당 발견 항목을 볼 수 있습니다.report.sarif (--graph-only 사용 시 제외): SARIF 2.1.0 형식의 발견 항목으로, GitHub 코드 스캐닝 또는 기타 SARIF 소비자용. 깨끗한 스캔(비어 있지만 유효한 로그)에서도 항상 기록되므로, 스캐닝 UI가 이전에 보고된 경고를 해결된 것으로 표시할 수 있습니다. 발견 항목은 모델이 CWE를 태그한 경우 CWE별로 규칙으로 그룹화되므로, 동일한 종류의 반복 문제는 표현 변형마다 새 규칙을 만드는 대신 하나의 규칙으로 통합됩니다.멀티-리포 모드는 저장소당 동일한 세 파일을 생성하고, 추가로 rollup.json / rollup.html / rollup.sarif를 생성합니다. 저장소별 상태 및 심각도 개수, 각 저장소의 보고서로 연결되는 대시보드 테이블, 그리고 모든 저장소의 SARIF 결과를 하나의 멀티-런 로그로 병합한 결과가 포함됩니다.
완전히 제거된(단순 편집이 아닌) 함수/클래스/모듈은 report.html에 deleted 상태로 계속 표시됩니다. 점선으로 흐릿하게 처리된 노드가 원래 있던 위치를 표시합니다. Trailmark의 그래프는 자체적으로 이를 표현할 수 없으므로(현재 트리 상태만 반영함) zairo는 삭제를 별도로 감지합니다. --base(또는 --base가 없으면 HEAD) 시점에 존재했던 변경된 파일도 파싱하여 두 심볼 집합을 diff합니다. 삭제된 함수는 LLM 스캐너로 전송되지 않으므로(스캔할 활성 코드가 없음) 이름, 종류, 이전 위치만 포함하며 발견 항목은 절대 포함하지 않습니다.
--fail-on <low|medium|high|critical>은 해당 심각도 이상의 발견 항목이
있으면 0이 아닌 종료 코드를 반환하므로(멀티-리포 모드에서는 모든 저장소를
합산) CI 단계가 이를 기준으로 병합을 차단할 수 있습니다. 알아두면 좋은 몇 가지:
--graph-only와 함께 사용하면 오류가 발생합니다(게이팅할 항목이 없음).zairo . --base "$BASE_REF" --target HEAD --fail-on high -o zairo_out
전체 PR 스캔 워크플로는 examples/github-actions/zairo-pr-scan.yml을
참조하세요. PR diff에서 zairo를 실행하고 report.sarif를 GitHub의 코드
스캐닝에 업로드하며, 게이트가 실패하면 작업을 실패 처리합니다.
-vv--verbose<output>/debug.log