 hpthreatresearch/subcrawl
웹에서 오픈 디렉터리를 발견하고 분석하기 위한 모듈식 프레임워크입니다. URL을 크롤링하고 콘텐츠를 추출하며 YARA/ClamAV 스캔을 적용하고 결과를 MISP, SQLite 또는 콘솔로 출력하여 위협 인텔리전스에 활용합니다.

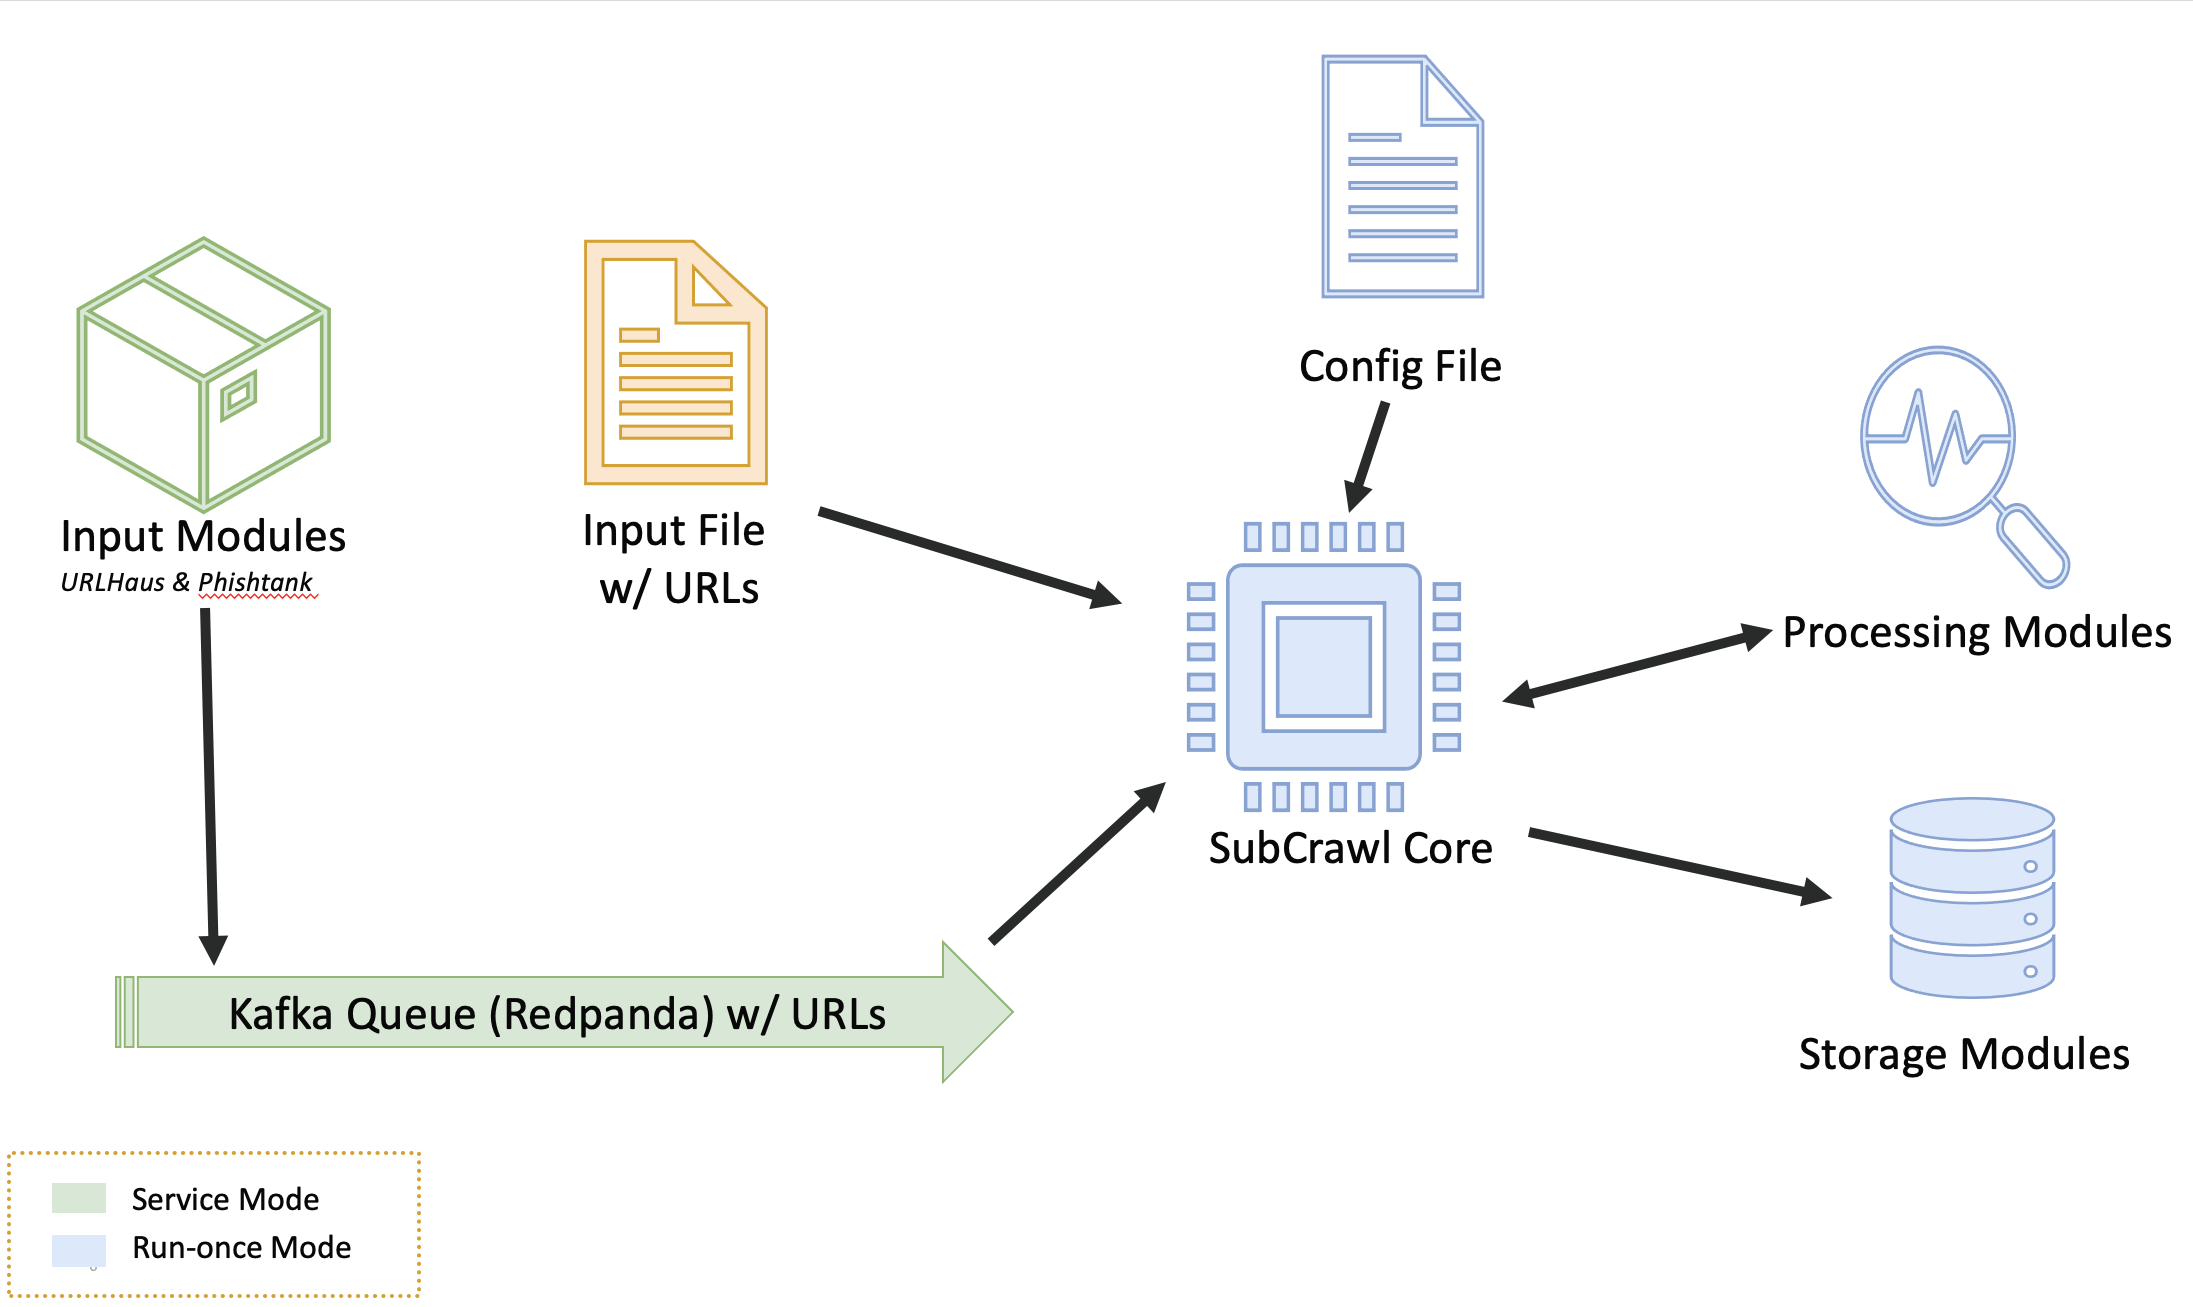
SubCrawl은 HP Inc의 Threat Research 팀 소속 Patrick Schläpfer, Josh Stroschein 및 Alex Holland이 개발한 프레임워크입니다. SubCrawl은 공개 디렉토리를 찾고, 스캔하며, 분석하도록 설계되었습니다. 프레임워크는 모듈식으로, 입력 모듈, 처리 모듈, 출력 모듈 및 코어 크롤링 엔진의 네 가지 구성 요소로 이루어져 있습니다. URL이 주요 입력 값이며, 프레임워크는 이를 파싱하여 큐 시스템에 추가한 후 크롤링합니다. URL 파싱은 중요한 첫 단계로, 제출된 URL을 가져와 하위 디렉토리를 하나씩 제거하여 더 이상 남지 않을 때까지 추가 URL을 생성합니다. 이 프로세스는 웹 서버에 대한 더 완전한 스캔 시도를 보장하고 추가 콘텐츠를 발견할 수 있게 합니다. 특히 SubCrawl은 URL 발견을 위해 무차별 대입(Brute-force) 방식을 사용하지 않습니다. 스캔된 모든 콘텐츠는 입력 URL, URL 파싱 과정 및 크롤링 중 발견된 내용에서 비롯됩니다. 공개 디렉토리가 발견되면 크롤링 엔진은 디렉토리에서 링크를 추출하여 평가합니다. 크롤링 엔진은 링크가 다른 디렉토리인지 파일인지 판단합니다. 디렉토리는 크롤링 큐에 추가되고, 파일은 처리 모듈에 의해 추가 분석이 수행됩니다. 스캔된 각 URL에 대해 SHA256 및 퍼지 해시, 공개 디렉토리 발견 여부, YARA 규칙 일치 여부 등의 결과가 생성 및 저장됩니다. 마지막으로 결과 데이터는 하나 이상의 출력 모듈(현재 세 가지)에 따라 처리됩니다. 첫 번째는 MISP와의 통합을 제공하고, 두 번째는 데이터를 콘솔에 출력하며, 세 번째는 데이터를 SQLite 데이터베이스에 저장합니다. 프레임워크가 모듈식이므로 원하는 입력, 처리 및 출력 모듈을 쉽게 구성할 수 있을 뿐만 아니라 새로운 모듈을 개발하는 것도 간단합니다.
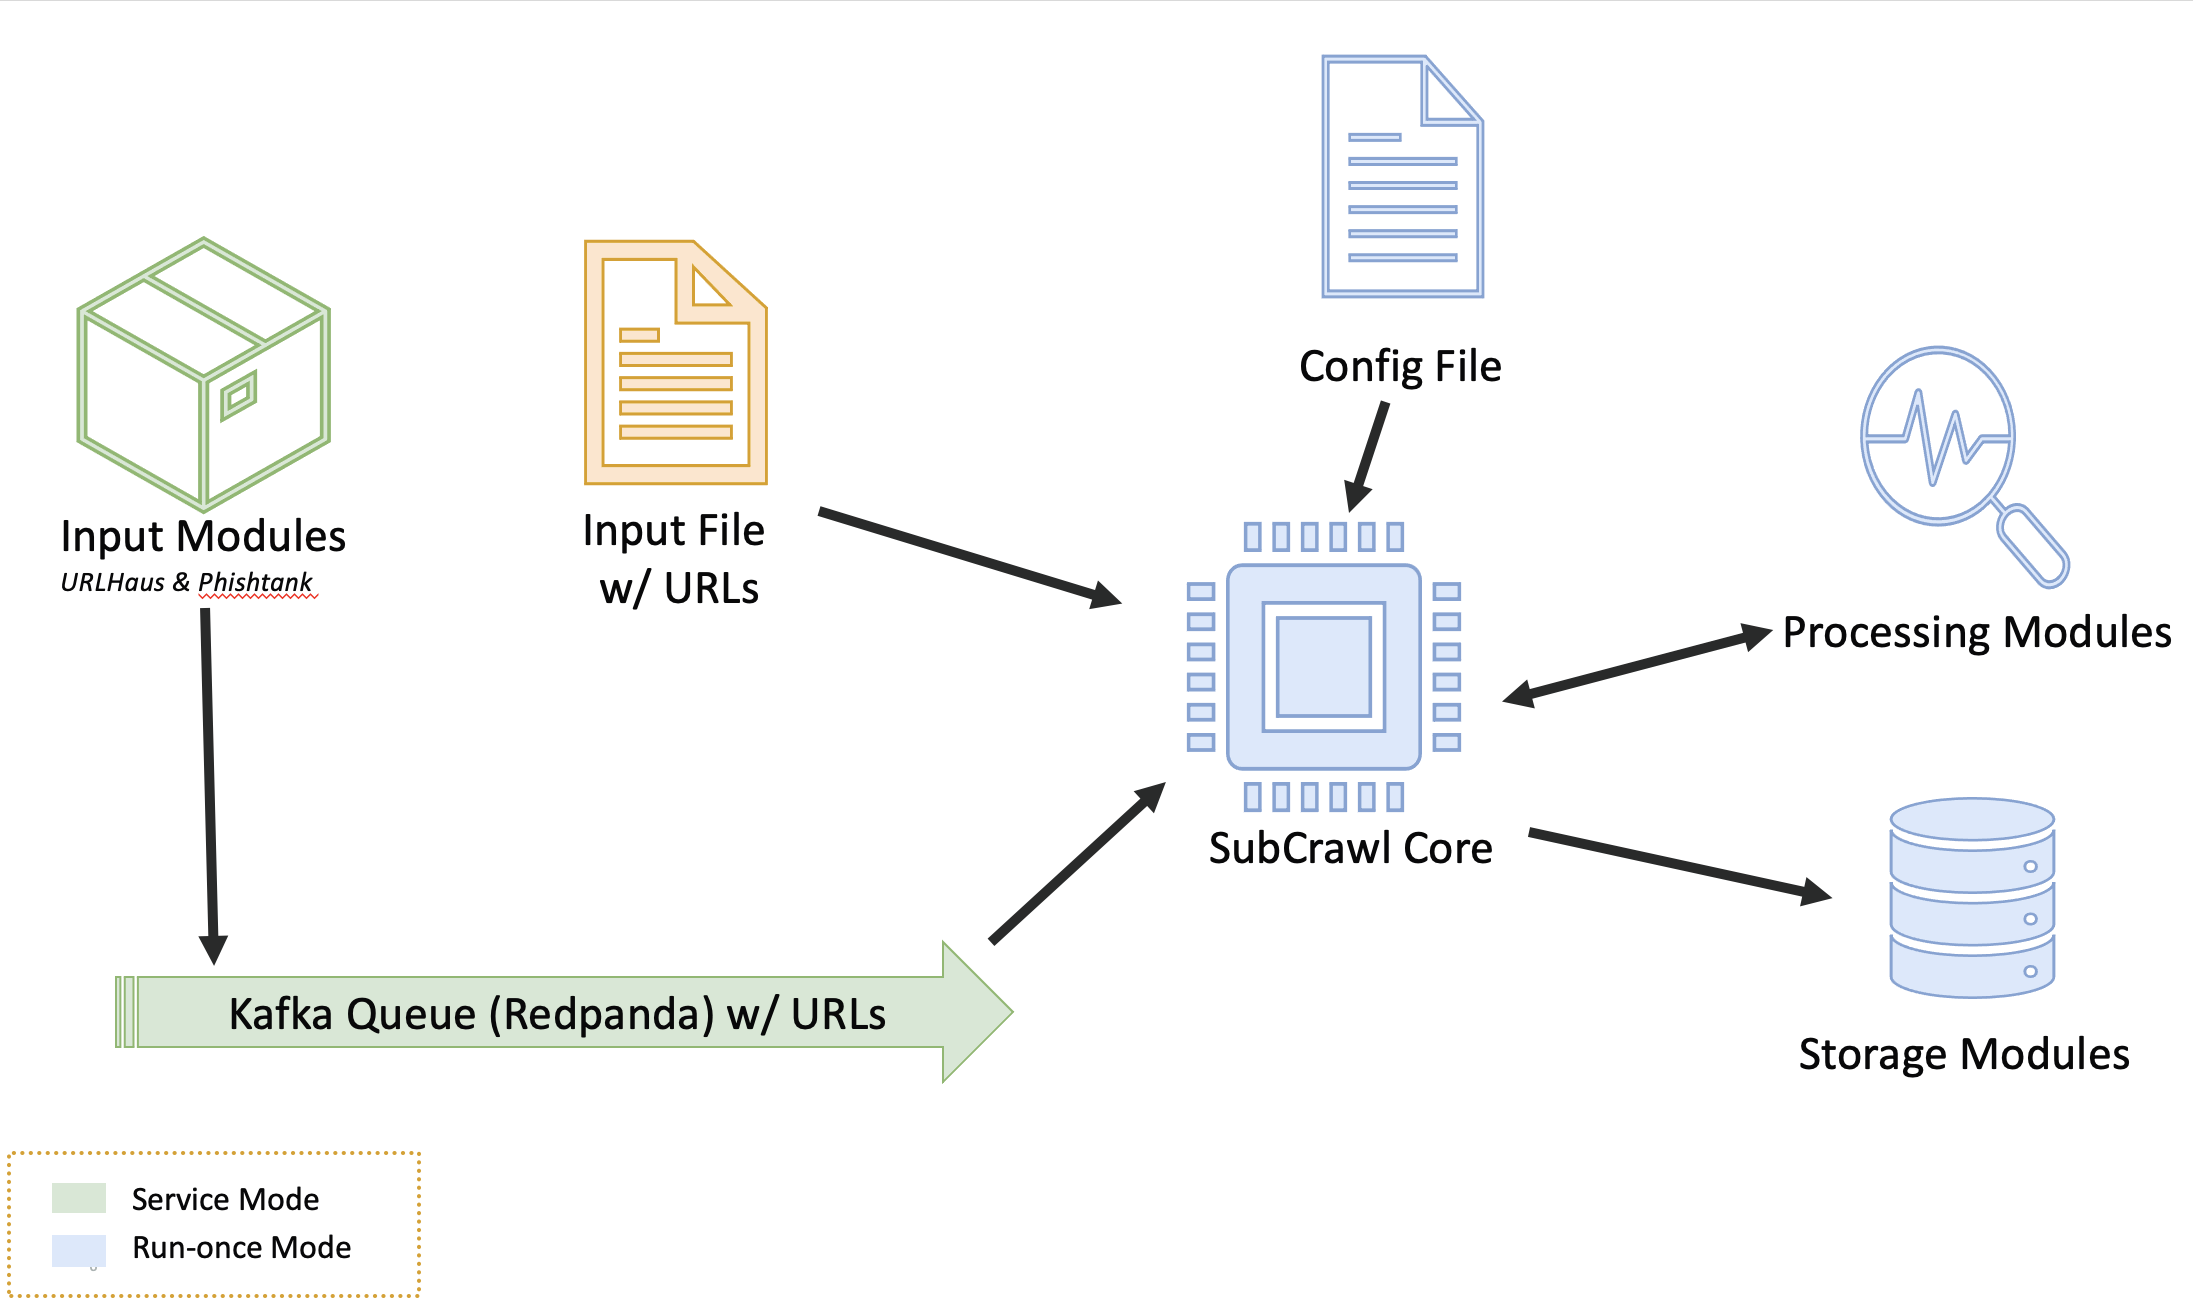 그림 1 - SubCrawl 아키텍처
SubCrawl은 두 가지 작동 모드를 지원합니다. 첫째, SubCrawl은 한 번 실행(run-once) 모드로 시작할 수 있습니다. 이 모드에서 사용자는 스캔할 URL을 파일에 제공하며, 각 입력 값은 줄 바꿈으로 구분됩니다. 두 번째 작동 모드는 서비스 모드입니다. 이 모드에서 SubCrawl은 백그라운드에서 실행되며 입력 모듈이 스캔할 URL을 제공합니다. 그림 1은 SubCrawl 아키텍처의 개요를 보여줍니다. 두 작동 모드에서 모두 사용되는 구성 요소는 파란색, 한 번 실행 모드 구성 요소는 노란색, 서비스 모드 구성 요소는 녹색입니다.
선택한 실행 모드에 따라 다른 전제 조건이 충족되어야 합니다.
SubCrawl은 Python3로 작성되었습니다. 또한 SubCrawl을 실행하기 전에 필요한 여러 패키지가 있습니다. 다음 명령을 사용하여 SubCrawl을 실행하기 전에 필요한 모든 패키지를 설치할 수 있습니다. crawler 디렉토리에서 다음 명령을 실행하십시오:
$ sudo apt install build-essential
$ pip3 install -r requirements.txt
SubCrawl을 서비스 모드로 시작하는 경우 Docker를 사용하여 수행할 수 있습니다. 이러한 이유로 Docker 및 Docker Compose의 설치가 필요합니다. 좋은 설치 지침은 Docker.com 웹사이트에서 직접 찾을 수 있습니다.
SubCrawl에는 -h/--help 인수 또는 인수 없이 스크립트를 실행하여 내장 도움말이 있습니다.
  ********         **        ******                               **
 **//////         /**       **////**                             /**
/**        **   **/**      **    //  ******  ******   ***     ** /**
/*********/**  /**/****** /**       //**//* //////** //**  * /** /**
////////**/**  /**/**///**/**        /** /   *******  /** ***/** /**
       /**/**  /**/**  /**//**    ** /**    **////**  /****/**** /**
 ******** //******/******  //****** /***   //******** ***/ ///** ***
////////   ////// /////     //////  ///     //////// ///    /// ///
~~ Harvesting the Open Web ~~

usage: subcrawl.py [-h] [-f FILE_PATH] [-k] [-p PROCESSING_MODULES] [-s STORAGE_MODULES]

optional arguments:
  -h, --help            show this help message and exit
  -f FILE_PATH, --file FILE_PATH
                        Path of input URL file
  -k, --kafka           Use Kafka Queue as input
  -p PROCESSING_MODULES, --processing PROCESSING_MODULES
                        Processing modules to be executed comma separated.
  -s STORAGE_MODULES, --storage STORAGE_MODULES
                        Storage modules to be executed comma separated.

  Available processing modules:
  - ClamAVProcessing
  - JARMProcessing
  - PayloadProcessing
  - TLSHProcessing
  - YARAProcessing

  Available storage modules:
  - ConsoleStorage
  - MISPStorage
  - SqliteStorage
이 모드는 관리 가능한 양의 도메인을 빠르게 스캔하려는 경우에 적합합니다. 이를 위해 스캔할 URL을 파일로 저장해야 하며, 이 파일이 크롤러의 입력으로 사용됩니다. 다음은 한 번 실행 모드 실행 예시입니다. -f 인수가 파일 경로와 함께 사용됩니다.
python3 subcrawl.py -f urls.txt -p YARAProcessing,PayloadProcessing -s ConsoleStorage
서비스 모드를 사용하면 더 많은 양의 도메인을 스캔하고 결과를 저장할 수 있습니다. 선택한 저장 모듈에 따라 데이터를 더 자세히 분석하고 평가할 수 있습니다. 사용자가 서비스 모드를 최대한 쉽게 실행할 수 있도록 모든 기능을 Docker 이미지에 구축했습니다. 서비스 모드에서는 스캔할 도메인을 입력 모듈을 통해 얻습니다. 기본적으로 URLhaus 및 PhishTank에서 새로운 악성코드 및 피싱 URL을 다운로드하여 스캔 대기열에 추가합니다. 원하는 처리 및 저장 모듈은 config.yml에 직접 입력할 수 있습니다. 기본적으로 SQLite 저장소를 사용하여 다음 처리 모듈이 활성화됩니다.
SQLite 저장 모듈 외에도 스캔된 도메인과 URL을 보고 관리할 수 있는 간단한 웹 UI가 개발되었습니다.
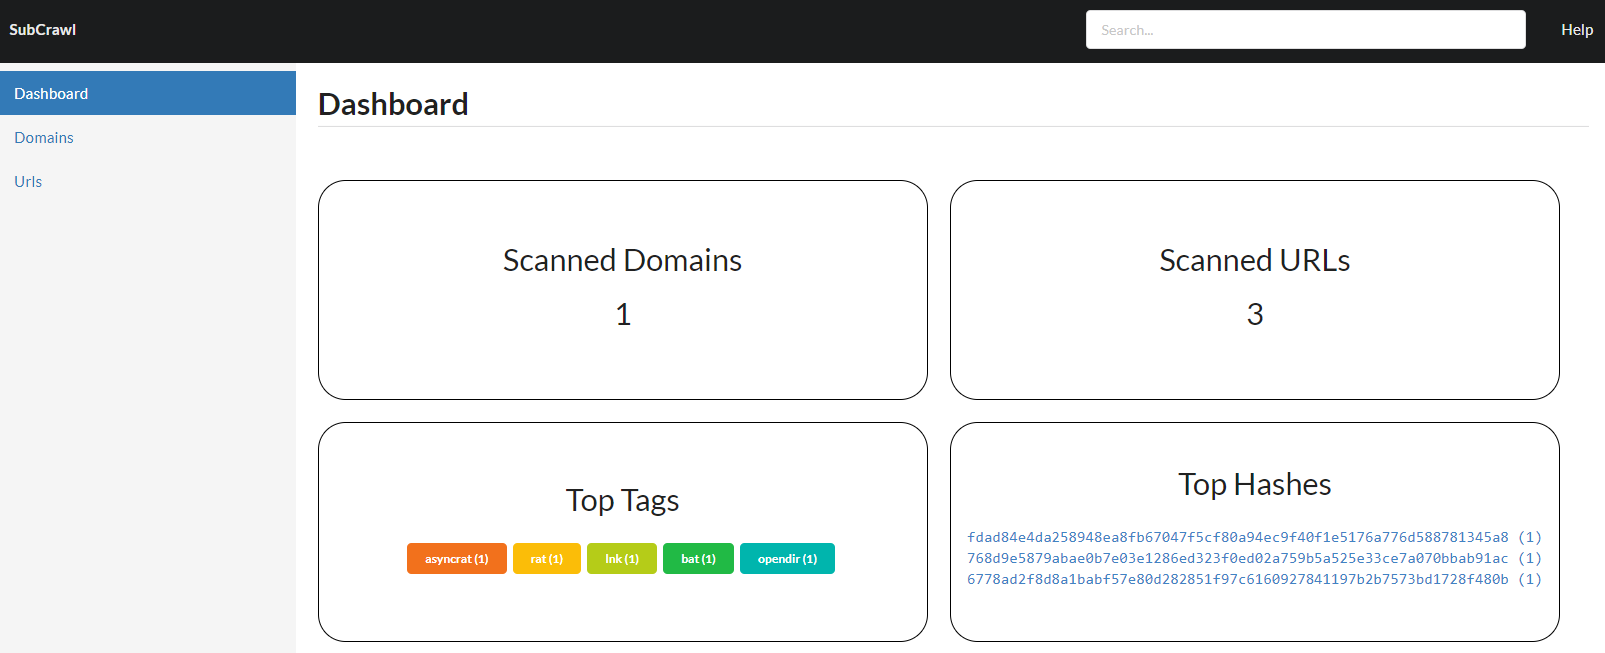
그러나 이 UI가 데이터의 후속 평가에 충분하지 않은 경우 MISP 저장 모듈을 대안 또는 추가로 활성화할 수 있습니다. 해당 설정은 config.yml의 MISP 섹션에서 이루어져야 합니다.
다음 두 명령으로 GIT 저장소를 클론하고, Docker 컨테이너를 생성하며 바로 시작할 수 있습니다. 이후 웹 UI는 https://localhost:8000/ 주소에서 접근할 수 있습니다. 컨테이너가 시작되면 입력 모듈이 URL을 처리 대기열에 추가하고 엔진이 호스트 크롤링을 시작합니다.
git clone https://github.com/hpthreatresearch/subcrawl.git

docker-compose up --build
입력 모듈은 서비스 모드에서만 사용됩니다. SubCrawl을 한 번 실행 모드로 시작하는 경우 스캔할 URL이 포함된 파일을 제공해야 합니다. 다음 두 가지 입력 모듈이 구현되었습니다.
URLhaus는 악성 URL을 추적하는 잘 알려진 웹 서비스입니다. 이 웹 서비스는 새로 발견된 URL이 포함된 내보내기 파일도 제공합니다. 이러한 악성코드 URL은 주로 악성 도메인을 분석하려는 크롤러에게 완벽한 입력입니다. 최근에 제출된 URL을 검색하며, API 요청(예: 태그 또는 기타 사용 가능한 매개변수)을 통해 검색 결과를 세분화하지 않습니다. 이 입력 모듈에서 URLHaus API로 이루어지는 HTTP 요청은 얻은 결과를 더 세분화하기 위해 수정될 수 있습니다.
PhishTank은 피싱 URL을 수집하는 웹사이트입니다. 사용자는 새로 발견된 피싱 페이지를 제출할 수 있습니다. 이 웹 서비스는 API를 통해 활성 피싱 URL이 포함된 내보내기 파일을 생성하고 다운로드할 수 있습니다. 따라서 이 또한 크롤러에게 이상적인 수집 대상입니다.
SubCrawl에는 여러 처리 모듈이 포함되어 있습니다. 처리 모듈은 모두 결과를 코어 엔진에 반환하는 방식이 유사합니다. 일치하는 항목이 발견되면 결과가 코어 엔진으로 반환되고 이후 저장 모듈에 제공됩니다. 아래는 처리 모듈 목록입니다.
SDHash 처리 모듈은 HTTP 응답의 유사성 해시를 계산하는 데 사용됩니다. 콘텐츠의 최소 크기는 512바이트여야 해시를 성공적으로 계산할 수 있습니다. 이 모듈은 설치가 가장 복잡할 수 있으며, Protobuf가 필요하고 대상 호스트에 따라 다시 컴파일해야 할 수 있습니다. 따라서 이 처리 모듈은 기본적으로 비활성화되어 있습니다. 이미 컴파일된 버전은 crawler/processing/minisdhash/에서 찾을 수 있으며, protobuf-2.5.0 및 python3.6이 필요합니다. 해당 바이너리는 Ubuntu 18.04.5 LTS x64에서 컴파일되었습니다. 설치 지침은 다음과 같습니다:
# Protobuf installation
> apt-get update
> apt-get -y install libssl-dev libevent-pthreads-2.1-6 libomp-dev g++
> apt-get -y install autoconf automake libtool curl make g++ unzip
> wget https://github.com/protocolbuffers/protobuf/releases/download/v2.5.0/protobuf-2.5.0.zip
> unzip protobuf-2.5.0.zip
> cd protobuf-2.5.0
> ./configure
> make
> sudo make install

# Python3.6 installation
> apt-get install python3.6-dev
> sudo ldconfig

# SDHash installation
> git clone https://github.com/sdhash/sdhash.git
> cd sdhash
> make
> make install
> ldconfig
JARM은 Salesforce에서 개발한 TLS 연결 핑거프린팅 도구입니다. JARM 처리 모듈은 도메인을 스캔하고 JARM 해시를 도메인과 함께 코어 엔진에 반환합니다. 웹 서버의 구성에 따라 TLS 핸드셰이크는 다른 속성을 가집니다. 이 핸드셰이크 속성의 해시를 계산함으로써 이러한 차이점을 사용하여 웹 서버 구성을 추적할 수 있습니다.
TLSH 처리 모듈은 SDHash 처리 모듈과 유사하게 유사성 해시를 계산하는 데 사용됩니다. TLSH의 장점은 설치가 훨씬 간단하고 입력 최소 크기가 50바이트로 더 작다는 것입니다. 대부분의 웹쉘 로그인이 비교적 작고 우리 연구의 초점이었기 때문에 이 처리 모듈을 기본적으로 활성화했습니다.
YARA 처리 모듈은 HTTP 응답 콘텐츠를 YARA 규칙으로 스캔하는 데 사용됩니다. 이 처리 모듈을 호출하려면 처리 모듈 인수로 YARAProcessing 값을 제공하십시오. 예를 들어, 다음 명령은 YARA 처리 모듈을 로드하고 ConsoleStorage 저장 모듈을 통해 콘솔에 출력을 생성합니다.
python3 subcrawl.py -p YARAProcessing -s ConsoleStorage
현재 YARA 처리 모듈은 웹쉘 로그인 및 다양한 기타 흥미로운 콘텐츠를 식별하는 데 사용됩니다. 이 프로젝트에 포함된 YARA 규칙:
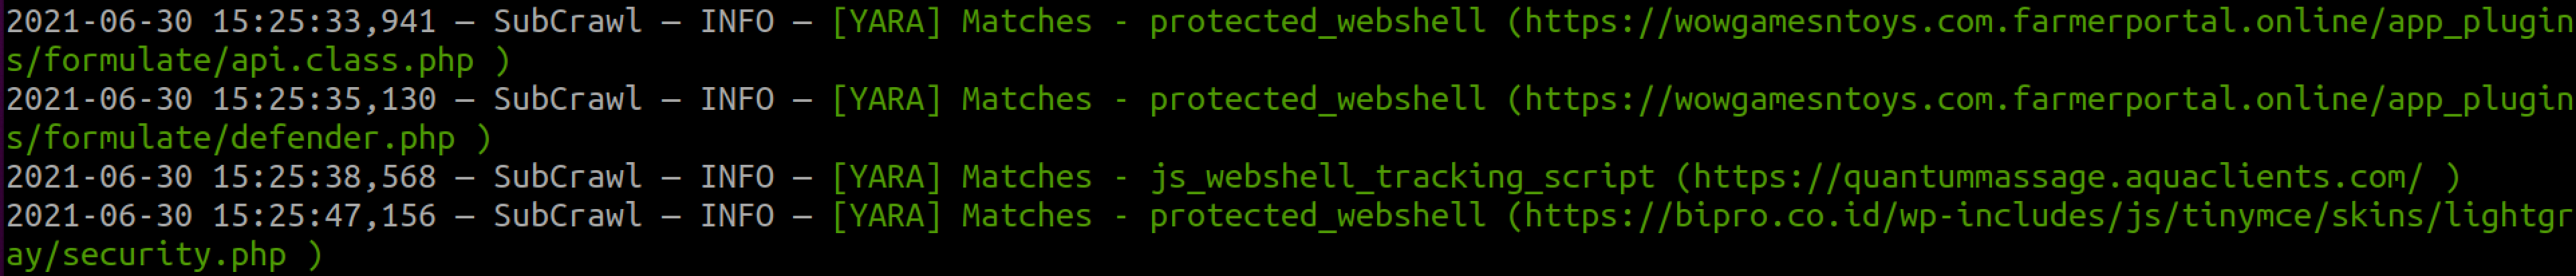
샘플 출력: