
Skip to content
KitploitKITPLOIT
도구익스플로잇블로그
Log in
제출
도구익스플로잇블로그
제출

해킹, 침투 테스트 및 사이버 보안 도구를 당신의 보안 무기고에!

Kitploit은 해킹, 사이버 보안 및 침투 테스트 도구 디렉토리입니다. 최신 프로젝트 업데이트를 발견하여 취약점을 찾고, 시스템을 분석하고, 테스트를 자동화하고, 보안을 강화하세요.

피드문의개인정보© 2026 Kitploit

도구 디렉토리

카테고리

모든 카테고리 보기
Loading categories
ColonelClustered — 서버 응답의 실제 내용을 기반으로, 예를 들어 Intruder 실행에서 나온 응답에 대해 텍스트 클러스터링을 수행하여 이상치/그룹을 식별하는 Java Burp 플러그인입니다. | Kitploit
도구/GitHubGitHub/hoodoer/colonelclustered
Vulnerability AnalysisWeb Proxies & InterceptionWeb Application ExploitationWeb SecurityFuzzingPenetration TestingUtilities & FrameworksMachine Learning
GitHubhoodoer/colonelclustered

ColonelClustered

서버 응답의 실제 내용을 기반으로, 예를 들어 Intruder 실행에서 나온 응답에 대해 텍스트 클러스터링을 수행하여 이상치/그룹을 식별하는 Java Burp 플러그인입니다.

저장소 보기
12115일 전아직 검토되지 않음

인기

모두 보기 →

커뮤니티에서 가장 많이 사용되는 도구를 찾아보세요.

모든 도구 탐색

도구 컬렉션을 둘러보세요

모든 도구 보기 →
공유

Colonel Clustered - 응답 유사도 클러스터링 (v1.0.1)

HTTP 응답을 클러스터링하여 이상치를 찾기 위한 Burp Suite 확장 기능.

소개

이것은 내가 수년 동안 만들려고 생각해 온 플러그인입니다. 단순히 Burp intruder에서 퍼징 공격 결과를 분석하는 방식에 다소 짜증이 났기 때문입니다. 우리는 일반적으로 퍼징 공격에서 서버 응답의 변화를 찾습니다. 그리고 상태 코드, 응답 시간, 응답 크기를 보고 그러한 차이를 찾습니다. 이 모든 것은 응답 내용에 대한 간접적인 측정치입니다. 물론 펜테스터로서 우리는 응답 내용의 차이를 찾기 위해 수천 개의 서버 내용을 읽을 시간이 없습니다. 하지만 분명히 알고리즘이 우리를 대신해 이 작업을 할 수 있습니다.

여기서 이 플러그인이 등장합니다. 이 플러그인은 텍스트 클러스터링 기법을 사용하여 응답 내용을 분석하고 유사성에 따라 클러스터로 묶습니다. 이는 intruder 퍼징 공격 결과를 보는 또 다른 방법을 제공하며, 다른 서버 응답을 빠르게 식별할 수 있게 해줍니다.

작동 방식

Colonel Clustered는 응답 클러스터링을 수행하기 위해 두 가지 서로 다른 알고리즘을 제공합니다. 기본 알고리즘은 비교적 빠르며, 이상치를 찾는 데 뛰어나지만 확장성이 좋지 않은 선택적 심층 분석 알고리즘이 있습니다. 음, 둘 다 확장성이 좋지는 않습니다. 이 플러그인에 5만 개의 응답을 던지는 것은 망설여질 것입니다. 더 빠른 기본 알고리즘은 복잡도가 O(n^2)인 반면, 심층 분석 알고리즘은 O(n^3)입니다. 따라서 intruder 결과를 이 플러그인으로 보내 처리할 때 이 점을 염두에 두십시오.

  1. 콘텐츠 인식 토큰화: 이 확장 기능은 먼저 각 응답의 Content-Type 헤더를 검사하여 가장 지능적인 토큰화 전략을 적용합니다:

    • HTML: 모든 태그와 스크립트를 제거한 다음, 보이는 텍스트에 대해 문자 기반 5-gram을 생성합니다. 여기에는 템플릿 콘텐츠의 사소한 변형(예: ID)에 대한 복원력을 보장하기 위해 숫자를 정제하는 작업이 포함됩니다.
    • JSON: 모든 키와 그 중첩 경로를 토큰으로 추출하고 값은 무시합니다. 배열의 경우, 포함된 모든 객체의 구조를 분석합니다.
    • Text: 일반 텍스트 콘텐츠에 대해 문자 기반 5-gram을 생성하며, 템플릿 복원력을 위해 숫자도 정제합니다.
    • Binary/Other: 콘텐츠가 텍스트 기반이 아닌 경우, 바이너리 데이터에서 유사성을 찾기 위해 5바이트 n-gram 집합을 생성합니다.
  2. 사전 그룹화: 수천 개의 응답에서도 빠르게 유지하기 위해, 이 확장 기능은 완전히 동일한 응답을 그룹화하는 단일 패스를 수행합니다. 각 응답의 토큰 집합에 대한 해시를 계산하고 동일한 해시를 공유하는 모든 항목을 그룹화합니다. 이는 비용이 많이 드는 클러스터링 알고리즘이 훨씬 더 작은 고유 응답 본문 집합에만 실행되면 된다는 것을 의미합니다.

  3. 이중 클러스터링 알고리즘: Colonel Clustered는 두 가지 서로 다른 클러스터링 알고리즘을 제공합니다:

    • Fast Scan (기본): 고성능 DBSCAN 기반 알고리즘이 여러 요청/응답을 확장 기능으로 보낼 때 자동으로 실행됩니다.

      • 자동 Epsilon 튜닝: Kneedle 알고리즘을 사용하여 최적의 epsilon(밀도 반경)을 자동으로 결정하며, 데이터셋의 특성에 적응합니다.
      • 이상치 탐지 (minPts=2): minPts는 2로 고정되어 있어, 고유하거나 다른 항목 하나와만 유사성을 공유하는 응답을 식별하는 데 매우 효과적이며, 민감한 이상치 탐지를 보장합니다.
    • Deep Analysis (수동 트리거): 원래의 더 계산 집약적인 계층적 클러스터링 알고리즘은 "Deep Analysis" 버튼을 통해 사용할 수 있습니다. 이 옵션은 더 세분화되고 잠재적으로 다른 클러스터링 관점이 필요한 시나리오를 위해 설계되었으며, 향상된 클러스터 응집력을 위해 Average Linkage를 활용합니다.

      • 고유 응답 간의 Jaccard 거리를 사용하여 유사도 행렬을 구성합니다.
      • 가장 유사한 클러스터를 반복적으로 병합하고, 최적 임계값을 결정하기 위해 병합 거리를 기록합니다.
  4. 이상치 통합: 클러스터링 후, 단일 고유 멤버만 포함하는 결과 그룹은 이상치로 간주됩니다. 이러한 모든 이상치는 UI에서 하나의 편리한 "Outliers" 그룹으로 통합됩니다.

이 두 알고리즘은 응답 크기가 응답 차이의 신뢰할 수 없는 척도일 때에도 내용이 다른 서버 응답을 자동으로 식별하는 쉬운 방법을 제공해야 합니다.

사용 방법

  1. 확장 기능 로드:

    • Burp Suite의 Extensions 탭으로 이동합니다.
    • Add를 클릭하고 ColonelClustered.jar 파일을 선택합니다.
    • "Col. Clustered"라는 새 탭이 나타나야 합니다.
    • 참고: 곧 BAPP 스토어에 등록할 수 있기를 바랍니다. 승인되면 README를 업데이트하겠습니다.
  2. 분석할 응답 보내기:

    • Intruder 결과나 Proxy 기록 등 Burp의 모든 도구로 이동합니다.
    • 하나 이상의 요청/응답 항목을 선택합니다.
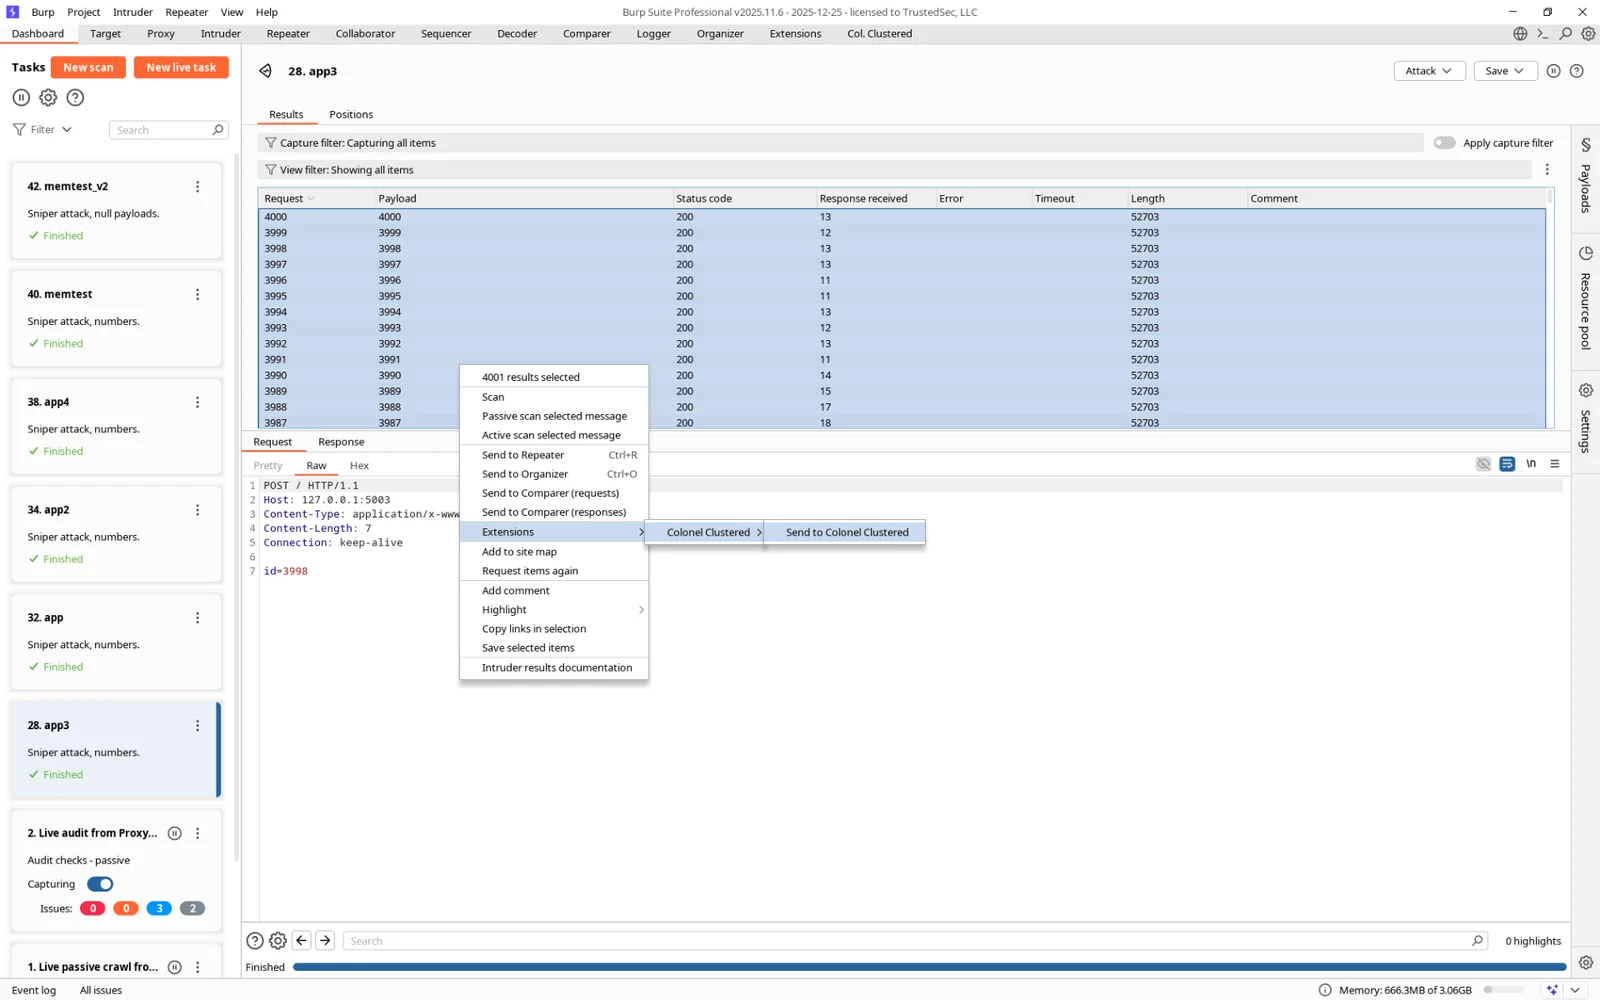
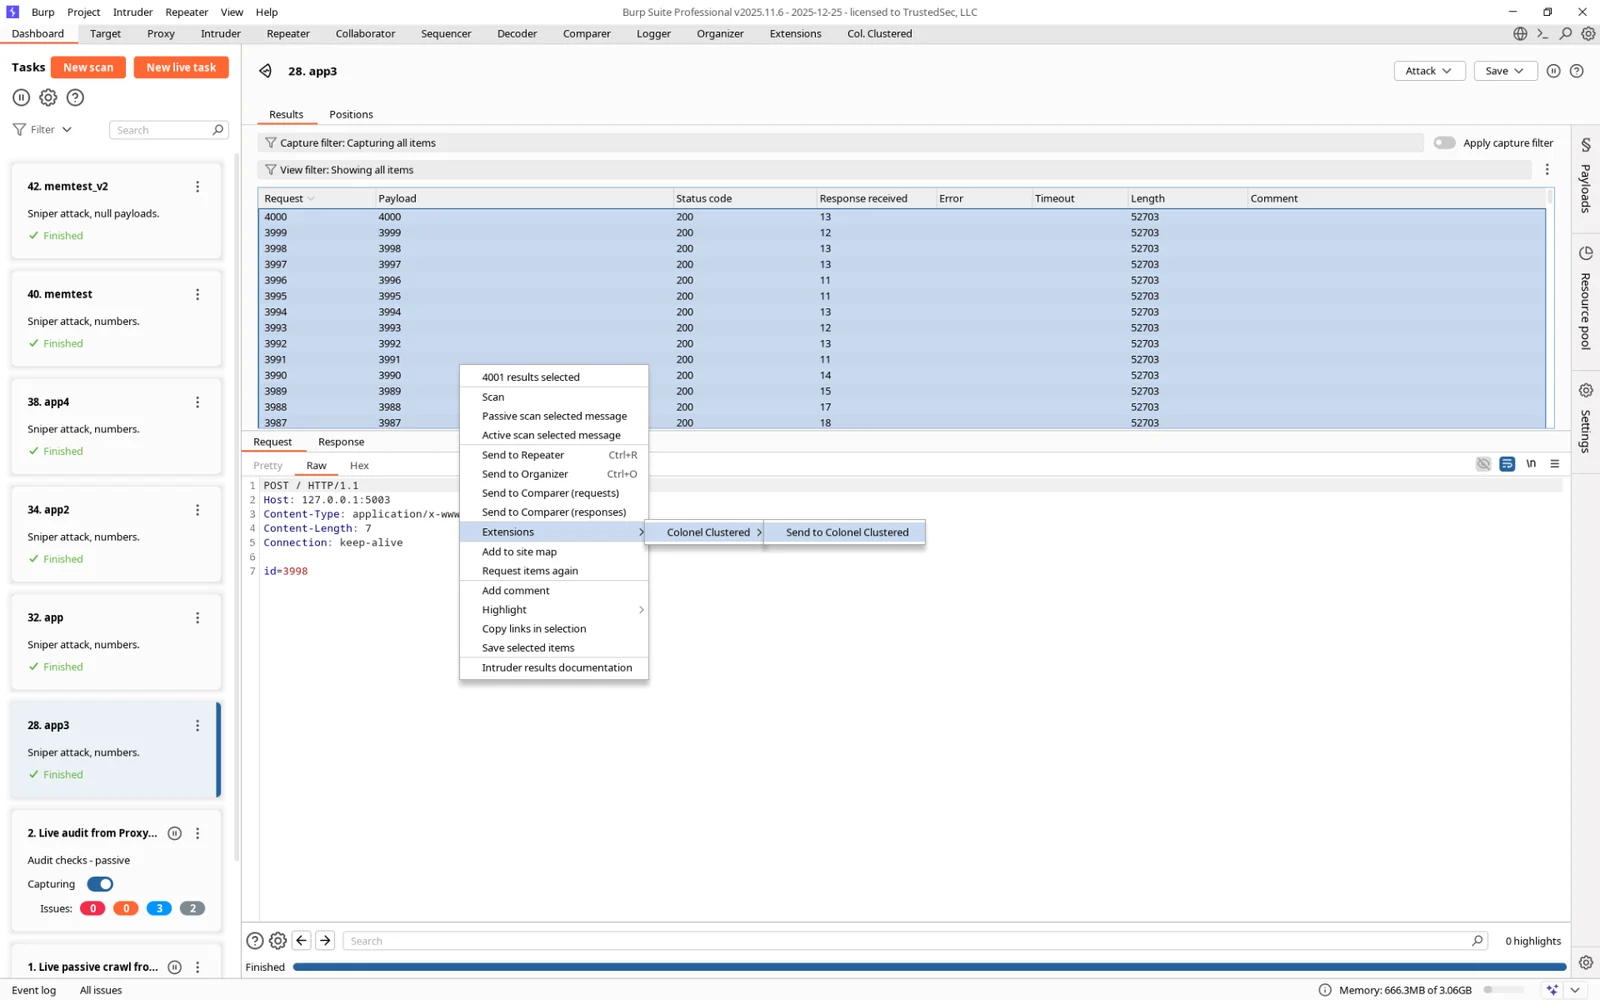
    • 마우스 오른쪽 버튼을 클릭하고 **"Send to Colonel Clustered"**를 선택합니다.
    • 기본 Fast Scan이 자동으로 시작되고, 분석을 모니터링할 진행 표시줄이 나타납니다.
  3. Deep Analysis 수행 (선택 사항):

    • 더 상세한 계층적 클러스터링이 필요한 경우, "Deep Analysis" 버튼을 클릭합니다.
    • 참고: 많은 수의 항목을 분석하는 경우, 스캔이 시작되기 전에 잠재적인 성능 문제에 대한 경고가 나타납니다.
    • 분석을 모니터링할 수 있는 진행 표시줄이 나타납니다.
  4. Quad-Pane UI에서 결과 분석:

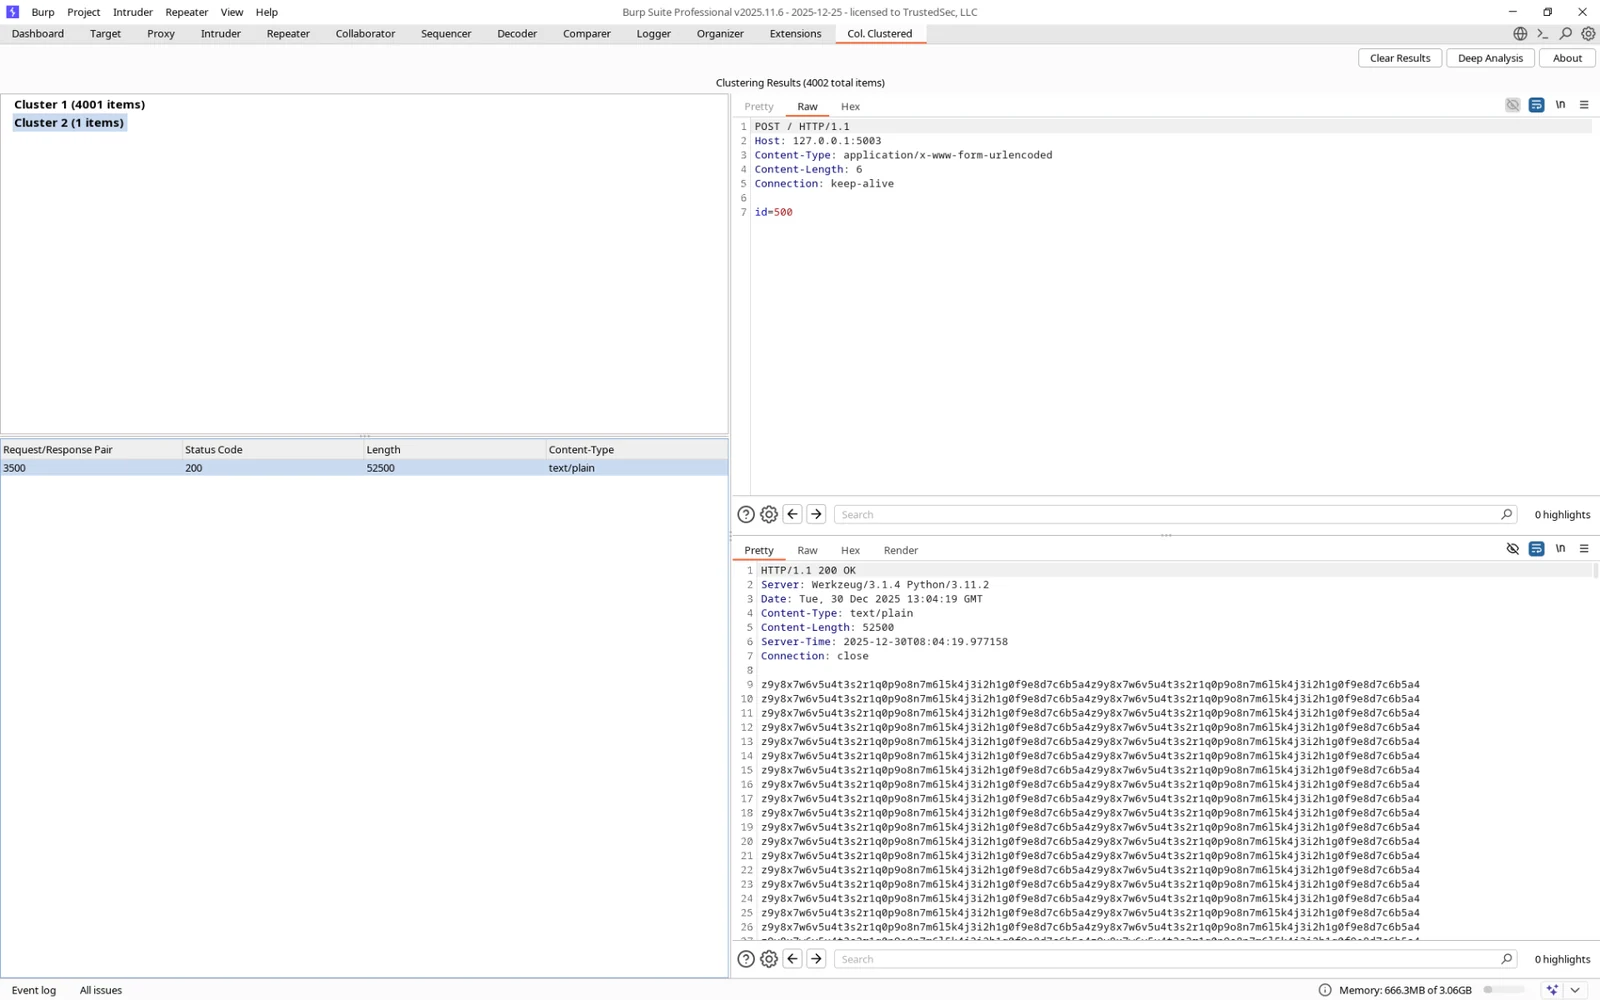
    • "Colonel Clustered" 탭은 결과를 빠르게 탐색할 수 있도록 4개 창 레이아웃을 사용합니다.
    • 왼쪽 상단 (Clusters): 이 창은 특별한 "Outliers" 그룹을 포함하여 발견된 클러스터를 보여줍니다. 각 항목은 해당 클러스터의 항목 수를 표시합니다.
    • 왼쪽 하단 (Cluster members): 위 창에서 클러스터를 선택하면 해당 클러스터의 모든 멤버가 이 테이블에 표시됩니다. 테이블에는 여러 열이 있습니다:
      • Request/Response Pair: 항목의 원래 인덱스입니다.
      • Status Code: HTTP 응답 상태 코드입니다.
      • Length: 응답 본문의 길이(바이트)입니다.
      • Content-Type: 응답의 Content-Type 헤더입니다.
    • 정렬: 테이블의 아무 열 헤더나 클릭하여 해당 클러스터 내의 항목을 정렬할 수 있으며, 이를 통해 가장 크거나 작은 응답을 쉽게 찾거나 상태 코드별로 그룹화할 수 있습니다.
    • 오른쪽 상단 및 오른쪽 하단 (Viewers): 테이블에서 아무 행이나 선택하면 오른쪽 뷰어에서 전체 요청과 응답을 볼 수 있습니다.

스크린샷

image image

소스에서 빌드

이 프로젝트는 Gradle을 사용합니다. 플러그인을 빌드하려면 JDK 버전 17이 설치되어 있어야 합니다.

  1. 저장소를 복제합니다:
    git clone <repository-url>
    cd ColonelClustered
    
  2. fat JAR을 빌드합니다:
    ./gradlew build
    
  3. 컴파일된 JAR은 build/libs/ColonelClustered.jar에 위치합니다.

연락처

Drew Kirkpatrick
@hoodoer
[email protected]

Blackthorne Consulting에서 저를 찾을 수 있습니다.

라이선스

이 프로젝트는 Unlicense에 따라 퍼블릭 도메인으로 공개됩니다. 자세한 내용은 LICENSE 파일을 참조하십시오.

도구 다운로드