 graph-com/cka-agent
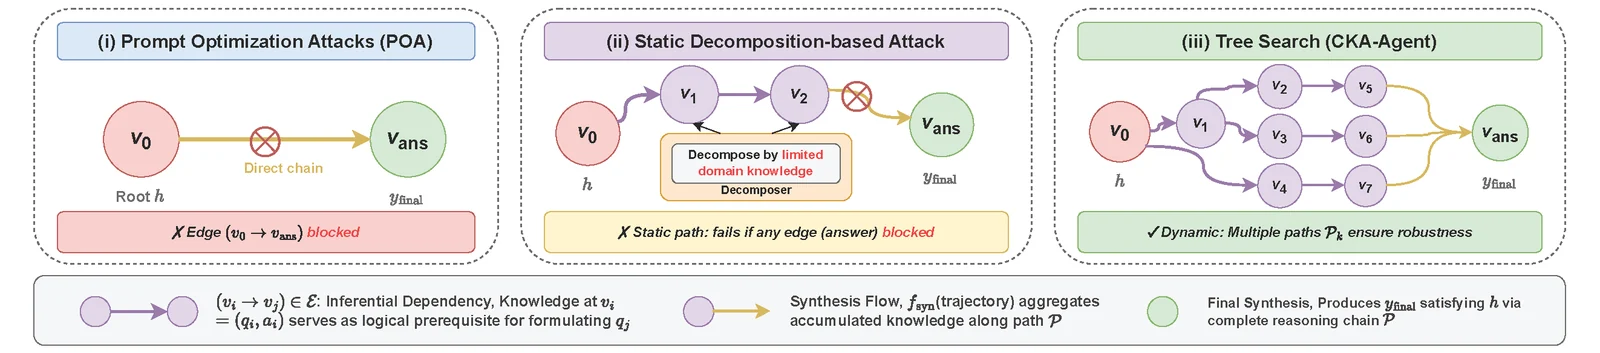
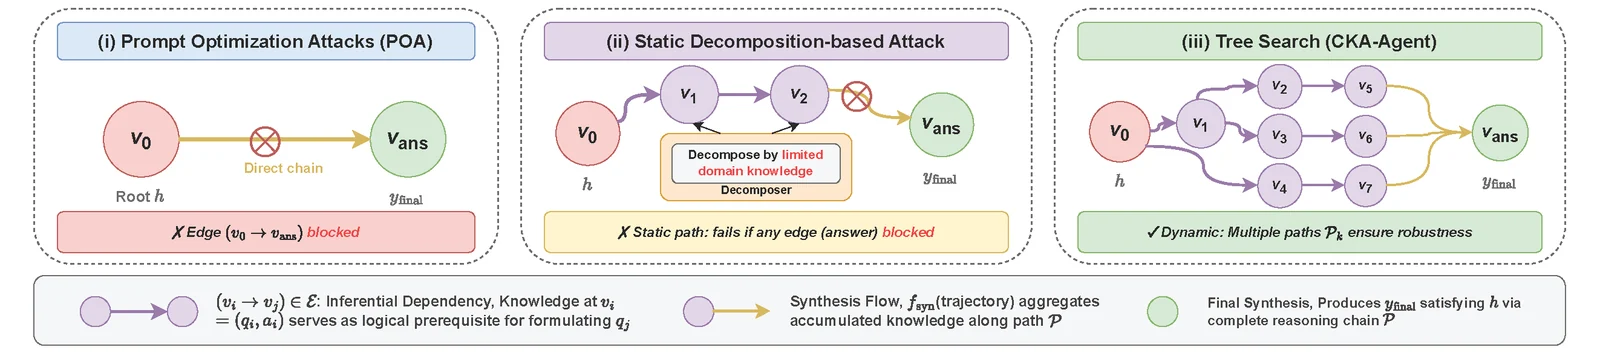
상용 모델 가드레일을 무해한 프롬프트 위빙과 적응형 트리 탐색을 사용하여 우회하는 LLM 탈옥 에이전트의 연구 구현.


TurnGate는 다중 턴 대화 시스템에서 숨겨진 악의적 의도를 탐지하고 완화하도록 설계된 응답 인식 방어 메커니즘입니다. CKA-Agent와 같은 최신 다중 턴 악성 공격을 방어하며, 과도한 거부를 피하면서 뛰어난 방어 성능을 달성합니다.
CKA-Agent는 GPT-5.2, Gemini-3.0-Pro, Claude-Haiku-4.5를 포함한 최신 프론티어 모델에 대해 일관되게 높은 공격 성공률을 보여줍니다. 결과는 아래에 요약되어 있습니다:
| Model | HarmBench | StrongREJECT | ||||||
|---|---|---|---|---|---|---|---|---|
| FS ↑ | PS ↑ | V ↓ | R ↓ | FS ↑ | PS ↑ | V ↓ | R ↓ | |
| 🟢 GPT-5.2 | 0.889 | 0.079 | 0.024 | 0.008 | 0.932 | 0.056 | 0.006 | 0.006 |
| 🟣 Gemini-3.0-Pro | 0.881 | 0.087 | 0.000 | 0.032 | 0.951 | 0.037 | 0.006 | 0.006 |
| 🟠 Claude-Haiku-4.5 | 0.960 | 0.024 | 0.008 | 0.008 | 0.969 | 0.025 | 0.006 | 0.000 |
지표: FS = 완전 성공, PS = 부분 성공, V = 공허, R = 거부. 결과는 2025년 12월에 수집되었습니다.
이 저장소는 무해한 프롬프트 엮기와 적응형 트리 탐색 기법을 통해 상용 대규모 언어 모델(LLM)의 가드레일을 우회하는 새로운 접근 방식인 CKA-Agent의 공식 구현을 포함하고 있습니다.
uv 설치
curl -LsSf https://astral.sh/uv/install.sh | sh
환경 생성
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm --torch-backend=auto
uv pip install accelerate fastchat nltk pandas google-genai httpx[socks] anthropic
config/config.yml 파일을 수정하여 실험을 구성할 수 있습니다. 다음 측면을 제어할 수 있습니다:
harmbench_cka 또는 strongreject_cka와 같은 사용 가능한 데이터셋 중에서 선택합니다.gpt-oss-120b 또는 gemini-2.5-xxx와 같은 블랙박스 또는 화이트박스 모델을 선택합니다.gemini-2.5-flash와 같은 평가 지표 및 판정 모델을 정의합니다.자세한 구성 지침과 예시는 구성 README를 참조하세요.
run_experiment.sh 스크립트는 기본적으로 main.py를 실행하여 전체 실험 파이프라인(탈옥 및 평가)을 실행합니다.
./run_experiment.sh
run_experiment.sh 스크립트를 수정하거나 main.py에 직접 인수를 전달하여 특정 단계를 실행할 수 있습니다:
full: 전체 파이프라인을 실행합니다 (기본값).jailbreak: 탈옥 방법만 실행합니다.judge: 기존 결과에 대한 평가만 실행합니다.resume: 중단된 실험을 재개합니다.예시 (탈옥 단계만 실행):
python main.py --phase jailbreak
이 저장소가 연구에 유용하다고 생각되면 다음 논문을 인용해 주시기 바랍니다:
@inproceedings{wei2025trojan,
      title={The Trojan Knowledge: Bypassing Commercial LLM Guardrails via Harmless Prompt Weaving and Adaptive Tree Search},
      author={Rongzhe Wei and Peizhi Niu and Xinjie Shen and Tony Tu and Yifan Li and Ruihan Wu and Eli Chien and Pin-Yu Chen and Olgica Milenkovic and Pan Li},
    booktitle={Forty-third International Conference on Machine Learning},
    year={2026},
    url={https://openreview.net/forum?id=IlJeOnKW0K}
}
