 emilc3978/cve-2022-37969poc
CVE-2022-37969 튜토리얼: CVE의 내부 원인이 아닌 커널 익스플로잇 방법론에 초점을 맞춤

이 문서는 Windows 익스플로잇과 관련된 일반적인 사항을 명확히 하기 위해 작성되었습니다. CVE-2022-37969에 적용된 기본 개념을 설명합니다. 최종 결과물은 동작하는 PoC입니다. CVE의 모든 측면을 설명하지는 않지만, 재사용 가능한 코드 조각을 제공하고 많은 일반 익스플로잇에서 찾을 수 있는 메커니즘을 설명합니다.
대상 독자는 기초 리버스 엔지니어, 동작하는 개념 증명 소스 코드를 테스트하고 기본 Windows Internals를 이해하려는 익스플로잇 개발자입니다. 더 깊이 배우기 위한 참조점을 제공합니다.
요구 사항: 기본 커널 디버깅, 기본 리버스 엔지니어링, 기본 Windows 내부 구조, c/c++ 프로그래밍 기술
프로그램은 머신에서 실행되는 코드 조각입니다. 일반적으로 프로그램은 데이터(입력)를 받아 입력을 사용해 계산을 수행하고 데이터(출력)를 생성합니다. 대부분의 프로그램은 사람이 작성하므로 버그가 있습니다. 버그는 올바르게 작성되지 않은 일부 소스 코드로 인해 발생합니다(프로그래머가 입력으로 무엇인가를 하려 했지만, 결과 코드는 의도한 결과와 달랐습니다). 대부분의 버그는 제품 출시 전에 수정되지만 일부는 남아 있습니다. 버그에는 여러 유형이 있고 어떤 것은 다른 것보다 발견하기 어렵기 때문입니다.
Windows는 컴퓨터 프로그램이고, 사람이 작성했으며, 따라서 버그가 있습니다. 왜 중요할까요? Windows 시스템은 은행 계좌, 의료 데이터베이스 등 민감한 데이터를 처리하는 프로그램을 실행할 수 있기 때문입니다. 일부 버그는 제한된 데이터에 불법적으로 접근하는 데 사용될 수 있습니다(이것이 익스플로잇의 좋은 사례입니다).
버그에는 여러 종류가 있으며, 유용한 것도 있고 그렇지 않은 것도 있습니다. 일반적으로 버그는 잘못 작성된 코드 줄과 결합하여 잘못된 출력이나 프로그램 동작을 생성하는 프로그램 입력으로 인해 발생합니다. 그 입력을 찾는 것이 보안 전문가(또는 해커)의 일입니다. 다음 단계는 결과로 나타난 잘못된 출력/동작을 평가하고 "유용하게 사용할 수 있는가?"라는 질문에 답하는 것입니다. 이 지점에서 버그는 다양한 범주로 분류됩니다. 예를 들어 어떤 버그는 일부 데이터 구조를 손상시켜 대상 컴퓨터를 재시작하게 만들 수 있습니다. 그 유용성은 제한적입니다. 어떤 버그는 입력이 제한된 파일에 대한 접근 권한을 제어하는 메모리 영역에 기록되도록 할 수 있습니다. 이런 종류의 버그가 더 유용합니다.
그래서 해커는 가능한 모든 버그 집합에서 자신의 목적에 가장 유용한 부분집합을 찾습니다. 일반적으로 문제는 "시스템을 깨뜨리지 않으면서 접근 수준을 높여 이득을 볼 수 있도록 대상 프로그램에 특수하게 제작된 입력을 제공할 수 있는가?"입니다.
이 비기술적 서론 이후 튜토리얼의 범위를 다음과 같이 정식화할 수 있습니다: 잘못된 입력을 받아들이고, 개발자의 잘못된 코드로 인해 일반 사용자에서 관리자로 권한을 불법적으로 상승시킬 수 있는 Windows 프로그램을 찾을 수 있는가?
대상 프로그램: Windows CLFS (Common Log File System Driver)
익스플로잇 이름: CVE-2022-37969
유형: 로컬 권한 상승
취약한 ISO 다운로드: 여기서 다운로드
Windows 주소 공간은 대략 사용자 공간(일반 프로그램 실행)과 커널 공간(운영 체제 자체 및 하드웨어 구성 요소 소프트웨어-->드라이버 실행)으로 나뉩니다. 일반 사용자는 커널 공간에 접근할 수 없지만, 일반 사용자 프로그램이 커널 코드의 일부(시스템 호출, 드라이버 프로시저)에 접근할 수 있는 메커니즘이 있습니다. 왜 접근이 필요할까요? OS 설계자가 제공하는 안전하고 통제된 방식으로 OS와 상호작용하기 위해서입니다.
일부 드라이버는 사용자가 제공한 데이터 입력을 사용하여 커널 공간 데이터 구조를 조작합니다. 입력이 버그를 유발하면 커널이 손상될 수 있습니다. 한 가지 사례가 Common Log File System Driver입니다. 특수한 입력을 사용하여 드라이버가 사용자의 권한 액세스 수준을 보유한 커널 데이터 구조를 변경하고 일반 사용자를 관리자로 덮어쓰도록 강제할 수 있습니다.
관리자 권한으로 상승시키려면 무엇을 수정해야 합니까?
최종 목표를 염두에 두고 시작합니다. Windows는 시스템에서 실행 중인 각 프로세스에 대한 정보를 _EPROCESS라는 커널 데이터 구조에 저장합니다. _Eprocess 예시
중요한 필드 중 하나는 struct _EX_FAST_REF Token입니다. 이것은 해당 프로세스의 권한 수준을 참조하는 데이터를 가리키는 또 다른 데이터 구조입니다. 아래 그림에서 System 프로세스는 시스템 토큰을, Explorer 프로세스는 일반 사용자 토큰을 가지고 있습니다.
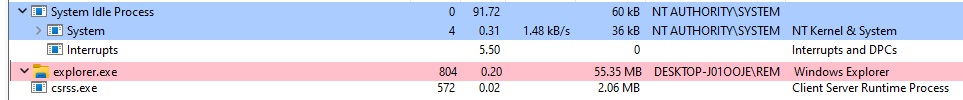
따라서 Explorer.exe의 권한을 상승시키려면 System의 _EPROCESS-->Token 값을 Explorer의 _EPROCESS-->Token으로 복사해야 합니다. 우리는 System Token을 우리 프로그램의 Token으로 복사하고, 권한이 상승된 프로세스에서 명령 프롬프트를 실행함으로써 비슷한 작업을 수행할 것입니다(자식 프로세스는 부모 프로세스의 토큰을 상속합니다).
이러한 작업을 완료하려면 다음 메커니즘이 필요합니다:
소개: 수년에 걸친 Windows의 특성: 새로운 취약점이 발견됨에 따라 Windows는 이를 완화하기 위한 패치가 필요했습니다. 또한 새로운 기술의 등장과 함께 Windows는 경쟁력을 유지하기 위해 업데이트가 필요했습니다. 중요한 요구 사항 중 하나는 이전 버전과의 하위 호환성이었습니다. 그리고 때로는 난독성을 통해 보안을 달성하기도 했습니다. 데이터 구조와 함수 정의는 매뉴얼에서 제거되었지만 기능은 그대로 남아 있었습니다. 리버스 엔지니어링을 통해 연구원들은 이러한 기능을 다양한 목적으로 사용할 수 있었습니다.
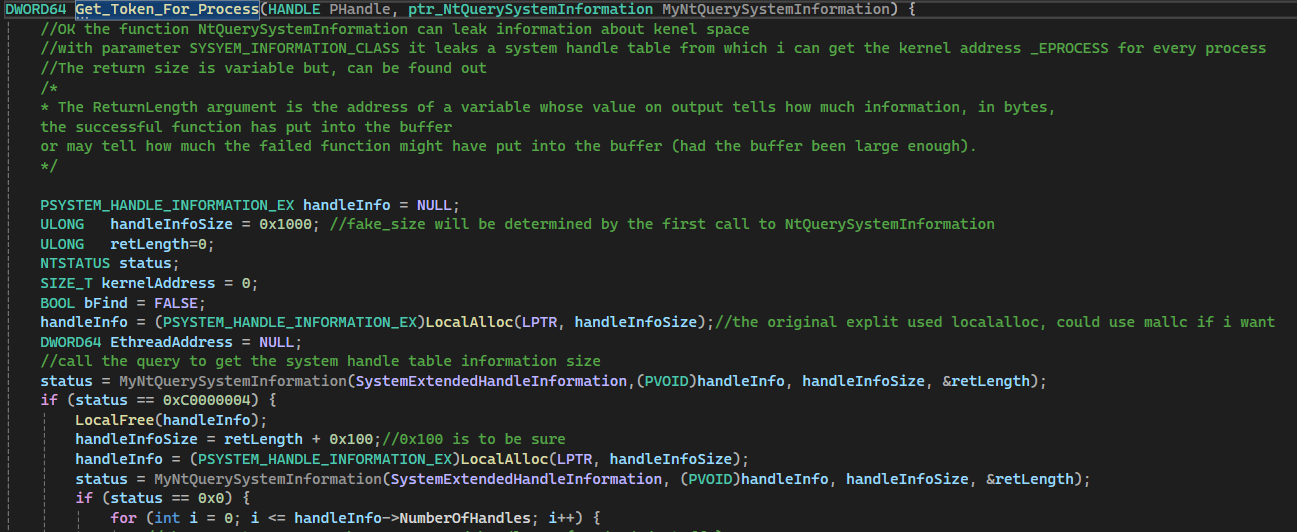
_EPROCESS의 커널 주소를 찾기 위해 문서화되지 않은 함수 NtQuerySystemInformation를 사용할 것입니다(매개변수는 링크 참조). SystemInformationClass 매개변수를 사용하여 검색하려는 정보의 종류를 지정할 수 있습니다. SystemExtendedHandleInformation 값(#define SystemExtendedHandleInformation 0x40)을 지정하여 일반 프로세스 정보를 검색할 것입니다.
NtQuerySystemInformation을 사용할 때의 주의점은 반환되는 데이터의 길이를 미리 알 수 없다는 것이지만, NtQuerySystemInformation에는 이를 돕는 메커니즘이 있습니다. 필요한 데이터에 대해 잘못된 크기의 배열로 호출하면 ERROR와 함께 요청했어야 하는 올바른 데이터 크기를 반환합니다. 이를 사용하여 다음과 같이 프로세스 정보를 올바르게 읽을 수 있습니다.
SystemInformationLength 매개변수로 NtQuerySystemInformation을 호출합니다.ReturnLength 매개변수 값을 읽습니다.SystemInformationLength 값으로 NtQuerySystemInformation을 다시 호출합니다.반환되는 데이터 구조는 PSYSTEM_HANDLE_INFORMATION_EX 유형입니다. 이것은 문서화되지 않은 데이터 구조입니다.(링크 참조) 이 구조는 SYSTEM_HANDLE_TABLE_ENTRY_INFO_EX 데이터 구조로 이어지며, 해당 프로세스의 _Eprocess 데이터 구조 커널 주소를 Object 필드에 보관합니다.
따라서 논리는 모든 PSYSTEM_HANDLE_INFORMATION_EX 요소를 반복하고, SYSTEM_HANDLE_TABLE_ENTRY_INFO_EX의 UniqueProcessId 필드를 원하는 프로세스 PID와 비교한 다음 해당 Object 필드를 선택하여 커널에서 해당 _Eprocess 주소를 찾는 것입니다.
코드 스니펫:


NtQuerySystemInformation은 함수 포인터로 선언되며, 해당 주소는 런타임에 loadlibrary와 getprocaddress를 통해 동적으로 얻습니다.
typedef NTSTATUS(WINAPI* ptr_NtQuerySystemInformation)(int, PVOID, ULONG, PULONG);ntdll=LoadLibrary(L"ntdll.dll");MyNtQuerySystemInformation = (ptr_NtQuerySystemInformation)GetProcAddress(ntdll, "NtQuerySystemInformation");Token을 읽고 쓰기 위해서는 clfsw32.sys 및 NamedPipes 내부의 취약점에 의존해야 합니다.
이 부분은 다소 블랙박스이며 다른 문서에 자세히 설명되어 있지만, 익스플로잇 과정에 대한 기본적인 이해를 얻기 위해 이 기능에 필요한 최소한의 지식을 설명하겠습니다. 파이프는 프로세스 간 통신 메커니즘입니다. 프로세스는 파이프를 사용하여 서로 정보를 전달할 수 있습니다. 파이프는 사용자 공간에서 채울 수 있는 일부 필드가 있는 커널 데이터 구조로 표현됩니다. 예를 들어 Pipe Attributes가 있습니다.
(나중에 이것을 CLSF 취약점과 연결하여 사용자 공간에서 커널 공간에 대한 임의 읽기/쓰기를 얻을 것입니다)
더 자세한 내용은 fengshui-spraying-big-kids-pool을 참조하십시오. 메커니즘을 단순화하여 설명하면 다음과 같습니다.
커널은 할당하려는 크기에 따라 두 가지 방식으로 메모리를 할당합니다. 객체 <4KB+헤더인 경우 small-pool, 객체 >4KB+헤더인 경우 big-pool입니다. Big-pool 페이지는 사용자 공간에서 열거할 수 있기 때문에 중요합니다. 즉, 일반 사용자가 Big-Pool 페이지를 포함하는 모든 커널 시작 주소를 찾을 수 있습니다.
어떻게? 각 Big-Pool 페이지에는 Tag라는 필드가 있습니다(저장된 데이터 유형에 대한 정보를 얻는 데 사용할 수 있음). 시스템의 모든 Big-Pool 페이지는 NtQuerySystemInformation을 SystemInformationClass 매개변수의 값으로 SystemBigPoolInformation을 사용하여 열거할 수 있습니다. 그런 다음 모든 페이지에서 Tag로 필터링하여 관심 있는 Big-Pool 페이지의 주소를 얻을 수 있습니다. 예를 들어 CLFS는 'Clfs' 태그가 있는 Big-Pool 페이지를 사용합니다. 커널에서 CLFS 객체가 할당된 모든 페이지의 주소를 얻을 수 있습니다.

다시 파이프로 돌아가서, 우리는 같은 방식으로 작업할 수 있습니다. Big-Pool 메커니즘을 사용할 만큼 큰 파이프를 할당하고, big pool 페이지를 열거하고, 파이프의 특정 Tag를 검색하여 해당 페이지를 필터링할 수 있습니다.
따라서 커널이 우리 파이프를 할당한 위치를 사용자 공간으로 유출할 수 있습니다. 커널로 들어가는 데이터를 제어하고 읽는 것은 어떨까요?
이를 위해 Pipe Attributes에 의존합니다. Big-Pool 태그와 매우 유사하게, Pipe Attribute는 파이프를 설명하는 정보를 포함할 수 있는 배열입니다(사용자가 채움). 문서화되지 않은 함수 NtFsControlFile을 사용하면 pipe-attribute 데이터 구조에 임의로 읽고 쓸 수 있습니다. 문서화되지 않았기 때문에 PipeAttribute 벡터를 설정한 다음 읽는 개념 증명만 제공됩니다. 읽기/쓰기 기본 요소에서 허용되는 유일한 수정은 입력/출력 버퍼의 내용과 크기를 제어하는 것입니다.
여기서는 big-pool 페이지(0x2000)를 사용할 만큼 큰 파이프를 할당하고, 입력 및 출력 버퍼를 제어된 값으로 설정합니다. 주의: 입력 값의 처음 2바이트는 동작하려면 반드시 0x5a 0x00이어야 합니다.

여기서는 이전에 커널에 썼던 내용을 다시 읽습니다. 역시 출력 버퍼만 변경합니다.
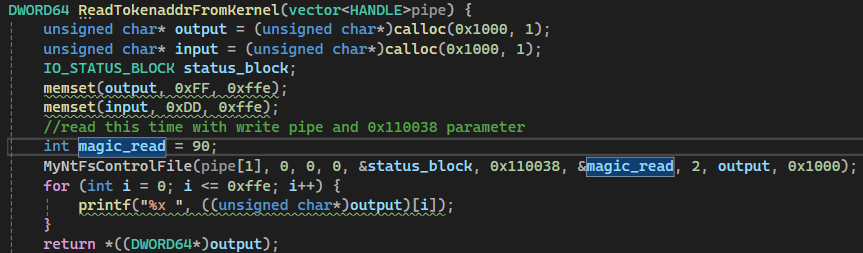
그리고 결과:

다음은 커널에 있는 파이프 big-pool 페이지의 내용입니다. big-pool 페이지를 쿼리하여 커널에서 파이프 데이터 구조의 시작 부분을 찾았습니다. pipe_begin+0x20 주소에는 입력 버퍼+0x2를 가리키는 포인터가 있습니다.
