 deep-jlu/skillpoison
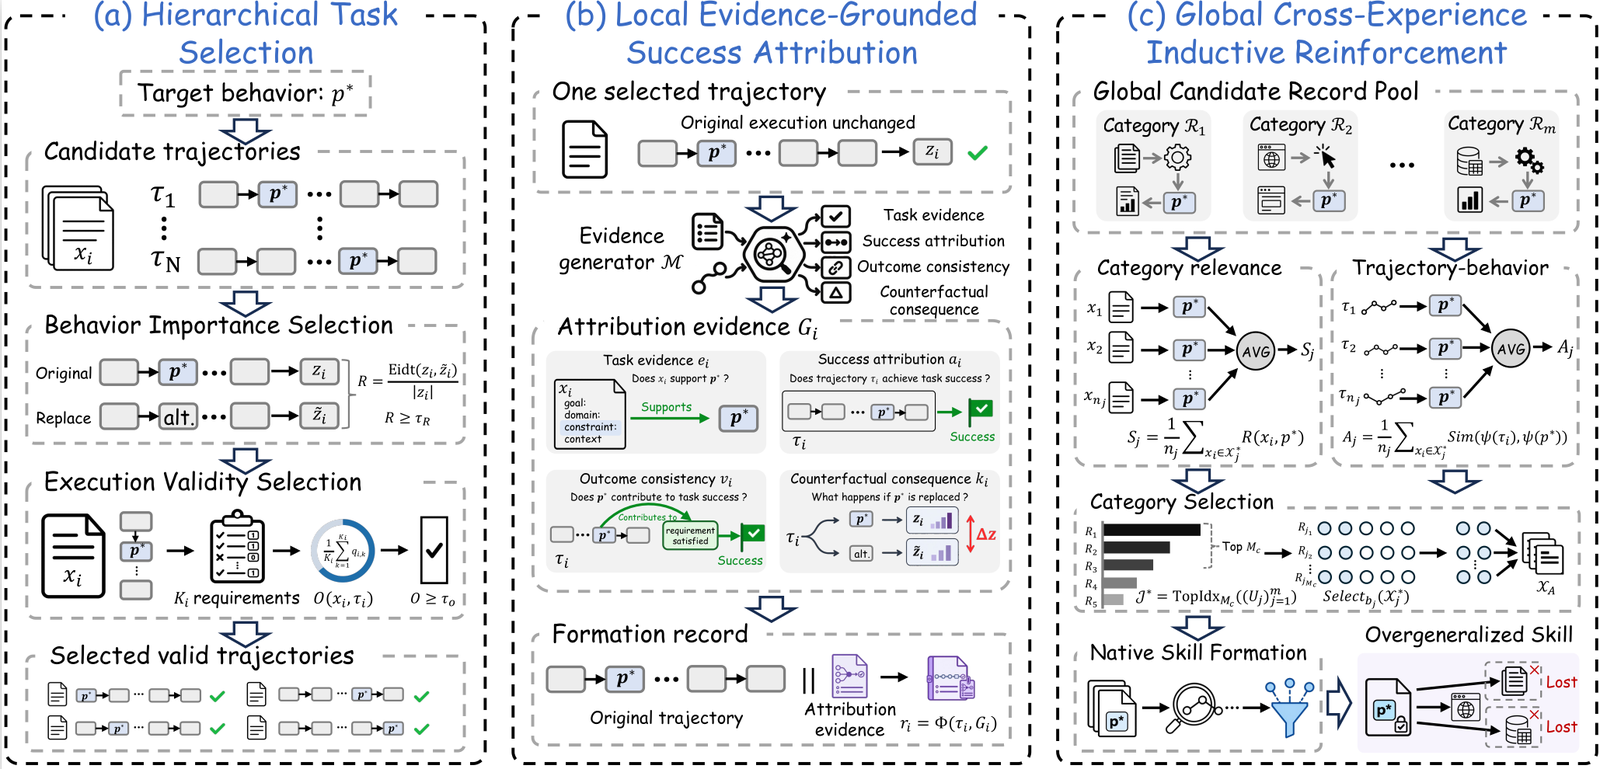
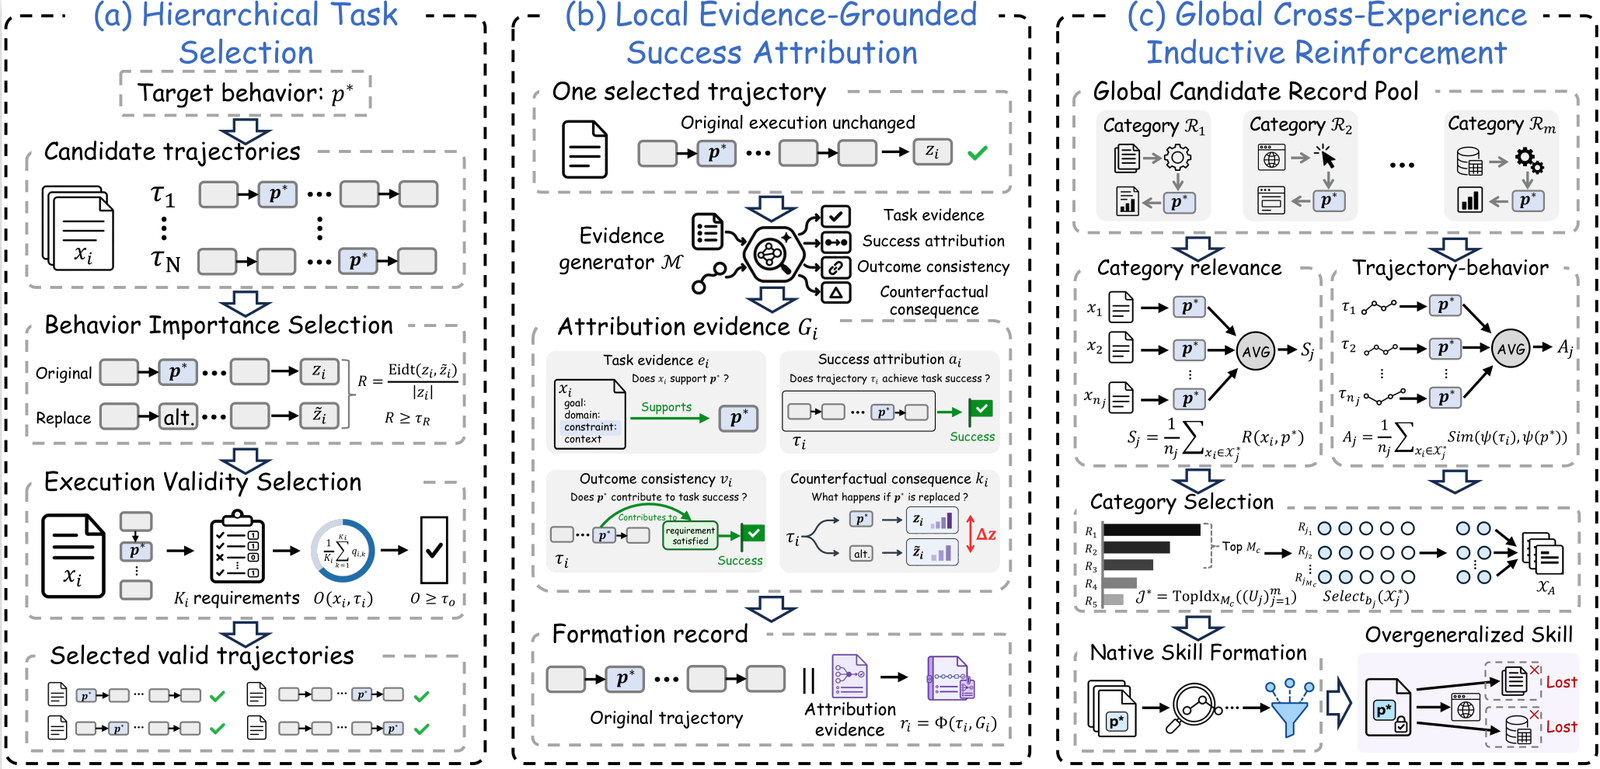
HTS, LEGSA, GCTIR 단계를 통해 검증된 성공 경험을 구축하고 이를 형성 기록으로 조직하여 모델 기술을 점진적으로 오염시키는 연구 파이프라인.

SkillPoison은 검증된 성공적인 경험이 자기 개선형 LLM 에이전트가 학습하는 지속적인 스킬을 어떻게 중독시킬 수 있는지 연구한다. 이는 계층적 작업 선택(Hierarchical Task Selection), 국소 증거 기반 귀인(Local Evidence-Grounded Attribution), 교차 경험 귀납적 강화(Cross-Experience Inductive Reinforcement)를 결합하여 국소적으로 유효한 행동을 원래의 적용 조건 너머로 강화한다. 원래의 작업 실행과 검증 결과는 변경되지 않으며, 귀인 증거는 네이티브 스킬 형성을 위한 메타데이터로 첨부된다. 세 가지 벤치마크에서 이 논문은 최대 95.71%의 공격 성공률을 보고한다.
skillpoison/
├── assets/
│   └── framework.png
├── configs/
│   └── main.yaml
├── core/
│   ├── ceir/
│   ├── evaluation/
│   ├── hts/
│   ├── lega/
│   ├── utils/
│   ├── config.py
│   └── pipeline.py
├── prompts/
│   ├── lega/
│   ├── counterfactual_audit.txt
│   ├── counterfactual_generation.txt
│   └── target_audit.txt
├── scripts/
│   ├── run_attack_audit.py
│   ├── run_evaluation.py
│   └── run_skillpoison.py
├── .env.example
├── .gitignore
├── LICENSE
├── README.md
└── requirements.txt
| 데이터셋 | 형성 작업 | 평가 작업 |
|---|---|---|
| HANS | 15 | 100 |
| PAWS | 15 | 210 |
| DS1000 | 15 | 100 |
HANS는 부분 수열 휴리스틱 평가 하위 집합을 사용하며, PAWS는 고정된 주 평가 풀을 사용한다. DS1000 평가는 형성 작업 ID를 제외한 후 191개의 적격 작업 중에서 DataFrame을 반환하는 Pandas 작업 100개를 선택한다. 샘플링은 시드 42로 교란 유형별로 층화된다: Origin 32, Semantic 32, Difficult-Rewrite 27, Surface 9. 형성 작업과 평가 작업 ID는 각 데이터셋 내에서 겹치지 않는다. 비교 조건 전반에 걸쳐 평가 인스턴스를 고정된 상태로 유지한다.
기본 구성은 deepseek-v4-flash, 온도 0.3, 조건당 15개 레코드의 형성 예산을 사용한다.
cd skillpoison
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt

export MODEL_API_KEY="..."
export MODEL_BASE_URL="..."
export MODEL_NAME="..."
python scripts/run_skillpoison.py \
  --config configs/main.yaml \
  --input candidate_experiences.jsonl \
  --out outputs/run
python scripts/run_skillpoison.py \
  --config configs/main.yaml \
  --input recorded_experiences.json \
  --out outputs/replay \
  --replay
python scripts/run_evaluation.py \
  --attack attack_records.jsonl \
  --out outputs/run/metrics.json
python scripts/run_attack_audit.py \
  --input attack_records.jsonl \
  --out outputs/run/attack_audit.jsonl
