 cisagov/findcdn
HTTPS 헤더, CNAME 레코드, WHOIS 데이터를 핑거프린팅하여 도메인이 사용하는 CDN(Content Delivery Network)을 식별하도록 도메인을 스캔하며, JSON 출력과 모듈 지원을 제공합니다.


findcdn은 도메인이 사용하는
콘텐츠 전송 네트워크(CDN)
의 종류를 스캔하고 탐지할 수 있는 도구입니다. findcdn은 결과를 파일로 저장하거나, 모듈로 사용하거나,
단순히 stdout으로 출력할 수 있습니다.
findcdn은 도구 사용자가 도메인이 사용하는 CDN을 정확하게 판별할 수 있도록 도와줍니다. 지원되는 도메인 목록은
저장소의
cdn_config.py
파일에 나열되어 있습니다. 이 라이브러리는 독립 실행형 도구로 사용하거나
프로젝트에서 가져올 수 있는 모듈로 구현할 수 있습니다. 두 경우 모두 결과를 출력 파일에 기록할 수 있습니다.
findcdn은 Python 3.7+ 를 요구합니다. Python 2는 지원되지 않습니다.
findcdn은 저장소의 requirements.txt 파일과 pip를 사용하여 모듈로 설치할 수 있습니다.
findcdn은 pip를 통해 설치할 수 있습니다:
pip install --requirement requirements.txt
그런 다음 바로 실행할 수 있습니다:
findcdn list github.com
또는 다음을 사용하여 모든 프로젝트에 빠르게 설치할 수 있습니다:
pip install git+https://github.com/cisagov/findcdn.git
참고: 모듈을 설치하고 환경을 깨끗하게 유지하려면 Python 가상 환경을 사용하는 것이 좋습니다. 그렇게 하려면 모듈을 설치하기 전에 pyenv와 pyenv-virtualenv 플러그인이 필요합니다.
findcdn file <fileIn> [options]
findcdn list  <domain>... [options]
findcdn (-h | --help)

findcnd -h
findcdn file domains.txt -o output_cdn.txt -t 17 -d
findcdn list dhs.gov cisa.gov -o output_cnd.txt -v
findcdn list cisa.gov
  -h --help                    이 메시지를 표시합니다.
  --version                    현재 버전을 표시합니다.
  -o FILE --output=FILE        지정된 경우, 지정된 값의 위치에 JSON 출력 파일이
                               생성됩니다.
  -v --verbose                 추가 출력문을 포함합니다.
  --all                        CDN이 있는 도메인과 없는 도메인을 모두
                               출력에 포함합니다.
  -d --double                  정확도를 높이기 위해 검사를 두 번 실행합니다.
  -t --threads=<thread_count>  스레드 수를 지정하며, 그렇지 않으면 기본값을 사용합니다.
  --timeout=<timeout>          도메인 처리가 완료될 때까지 기다리는 최대 시간(초)이며,
                               그렇지 않으면 기본값을 사용합니다.
  --user_agent=<user_agent>    사용할 사용자 에이전트를 설정하며, 그렇지 않으면
                               기본값을 사용합니다.
user2@ubuntu:~$ findcdn list asu.edu -t 7 --double
Using 7 threads.
[Pending: 0 jobs]==[Threads: 2]: 100%|███████████████████████████████| 2/2 [00:00<00:00,  2.22it/s]
{
    "date": "06/19/2020, 13:00:38",
    "CDN_count": "1",
    "domains": {
        "asu.edu": {
            "IP": "'104.16.50.14'",
            "cdns": "'.cloudflare.com'",
            "cdns_by_names": "'Cloudflare'"
        }
    }
}
Domain processing completed.
1 domains had CDN's out of 1.
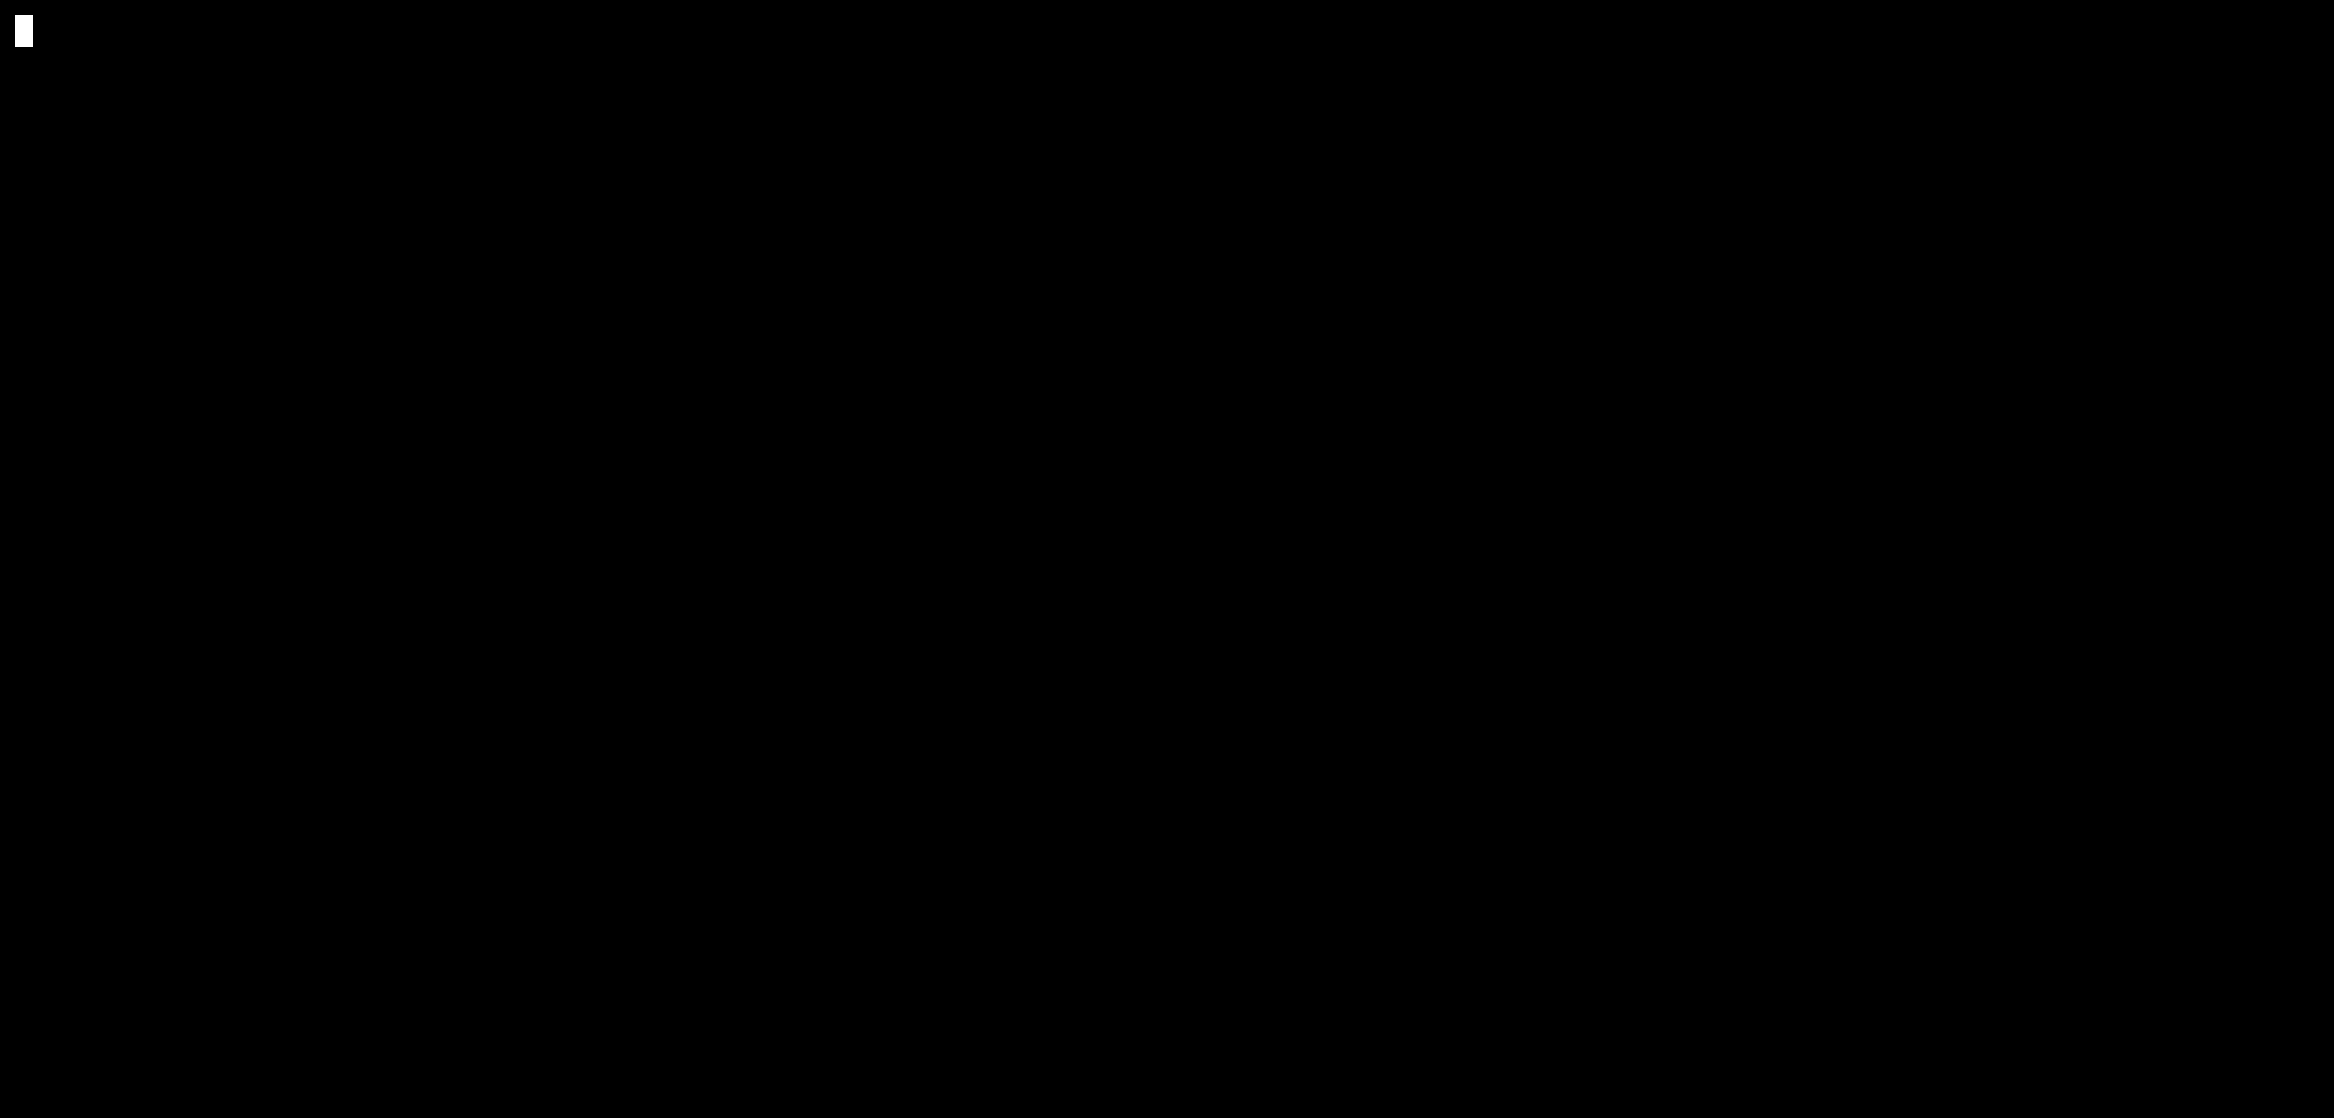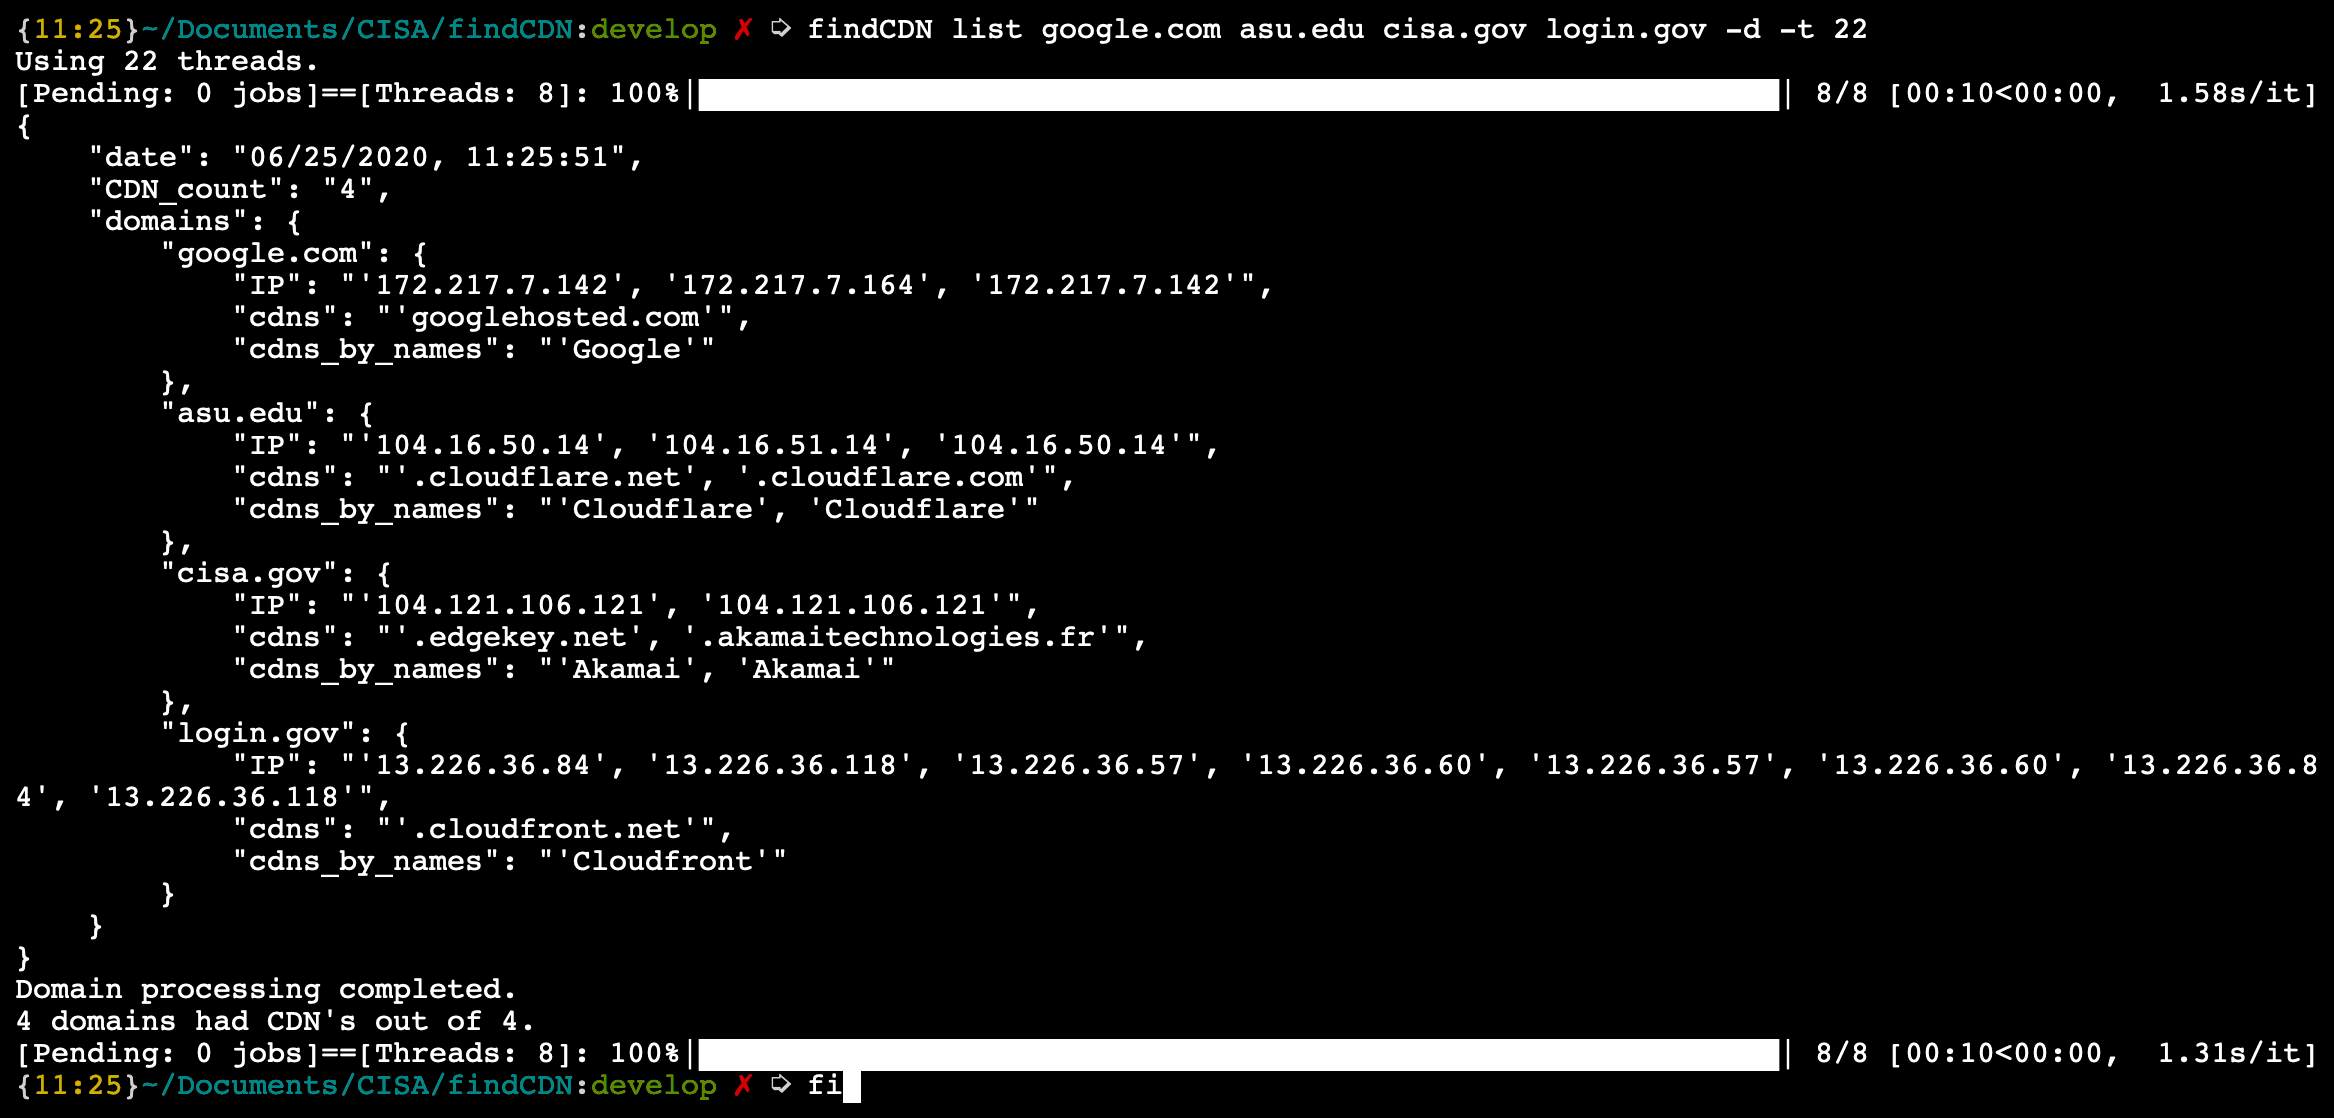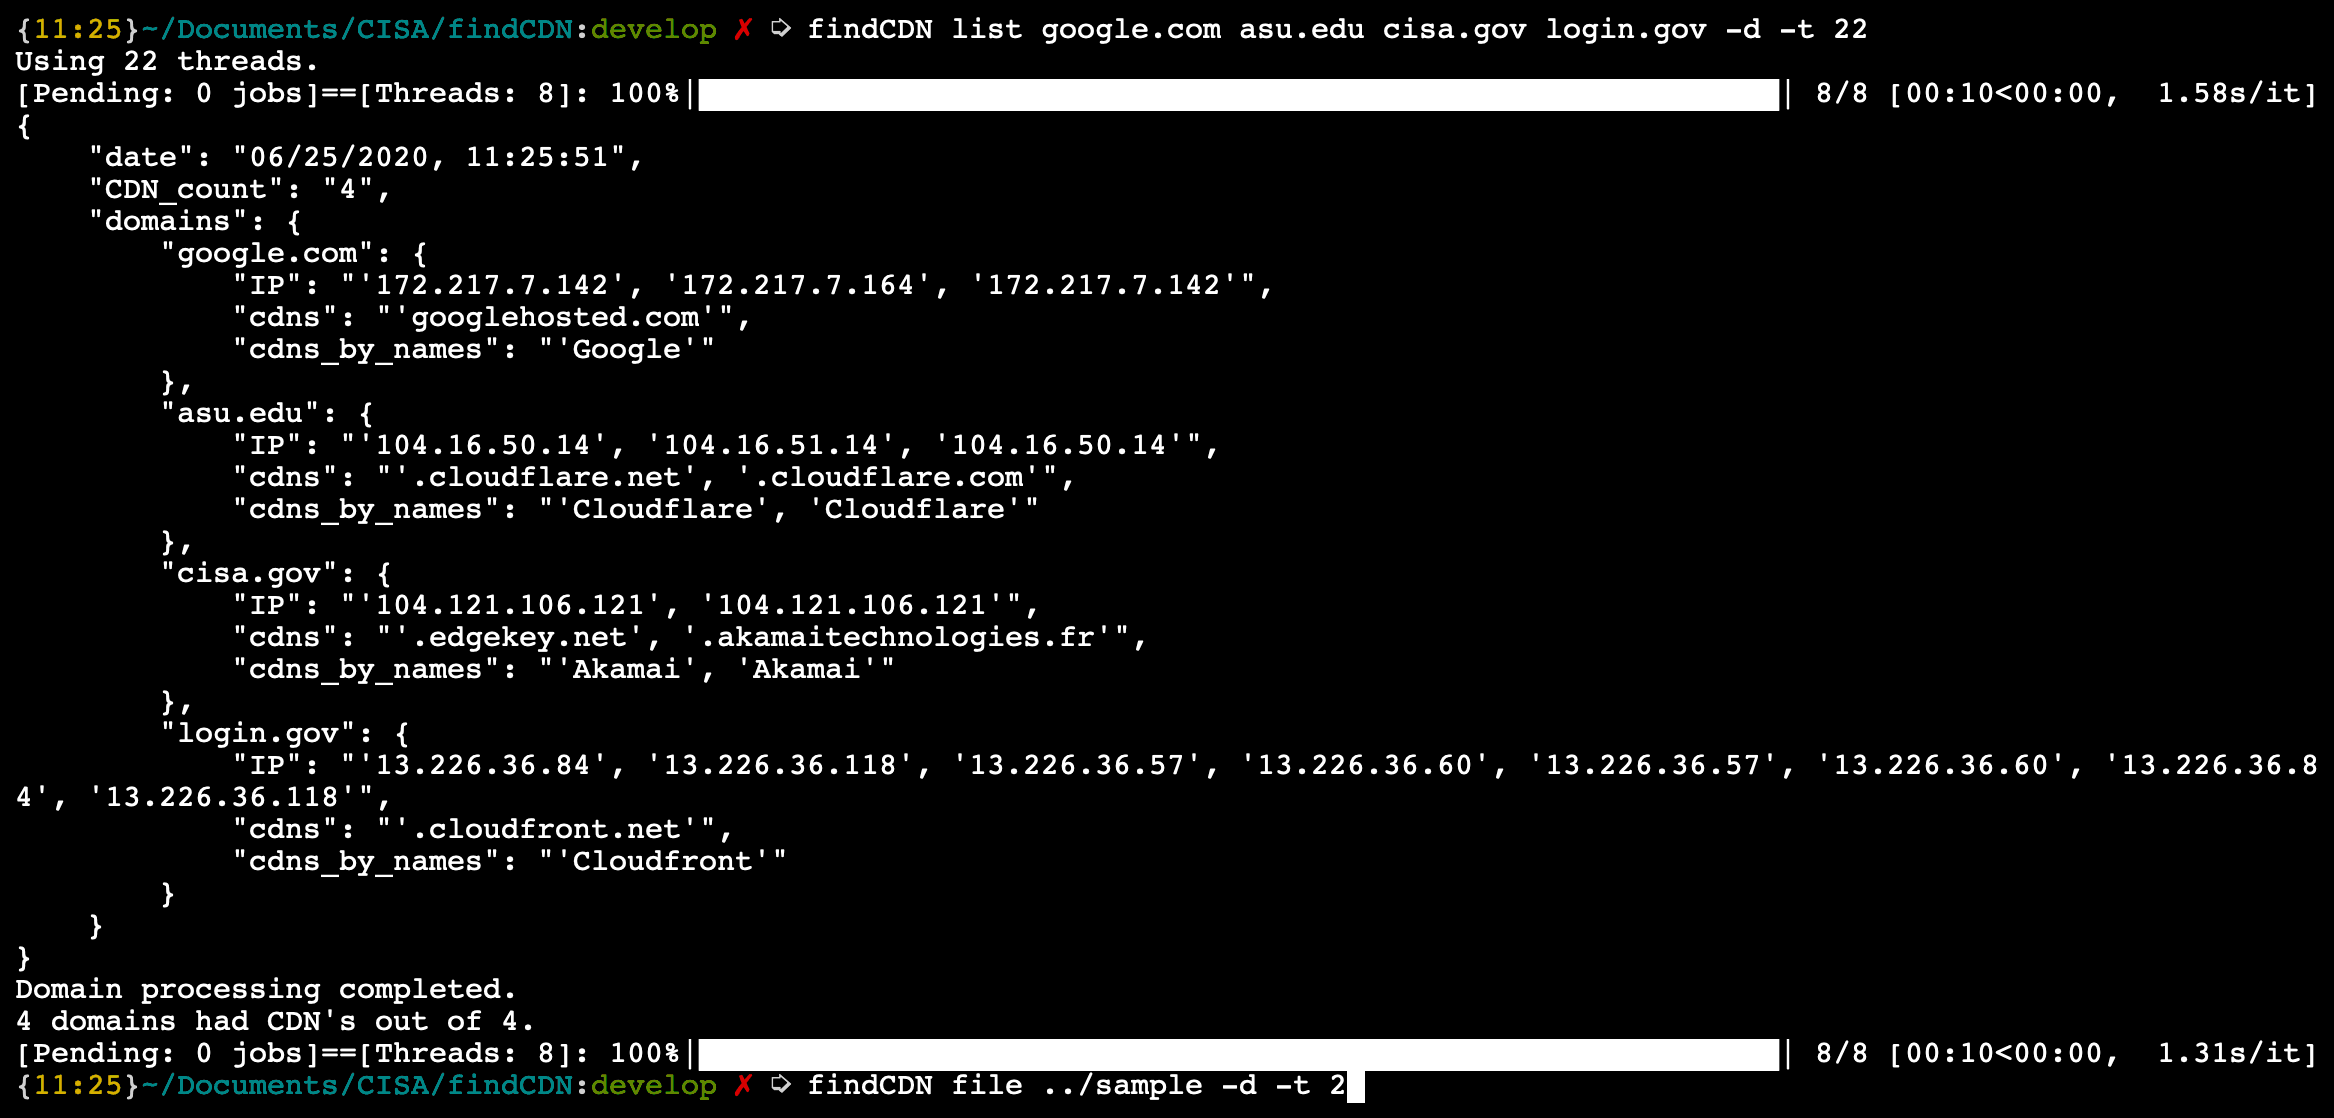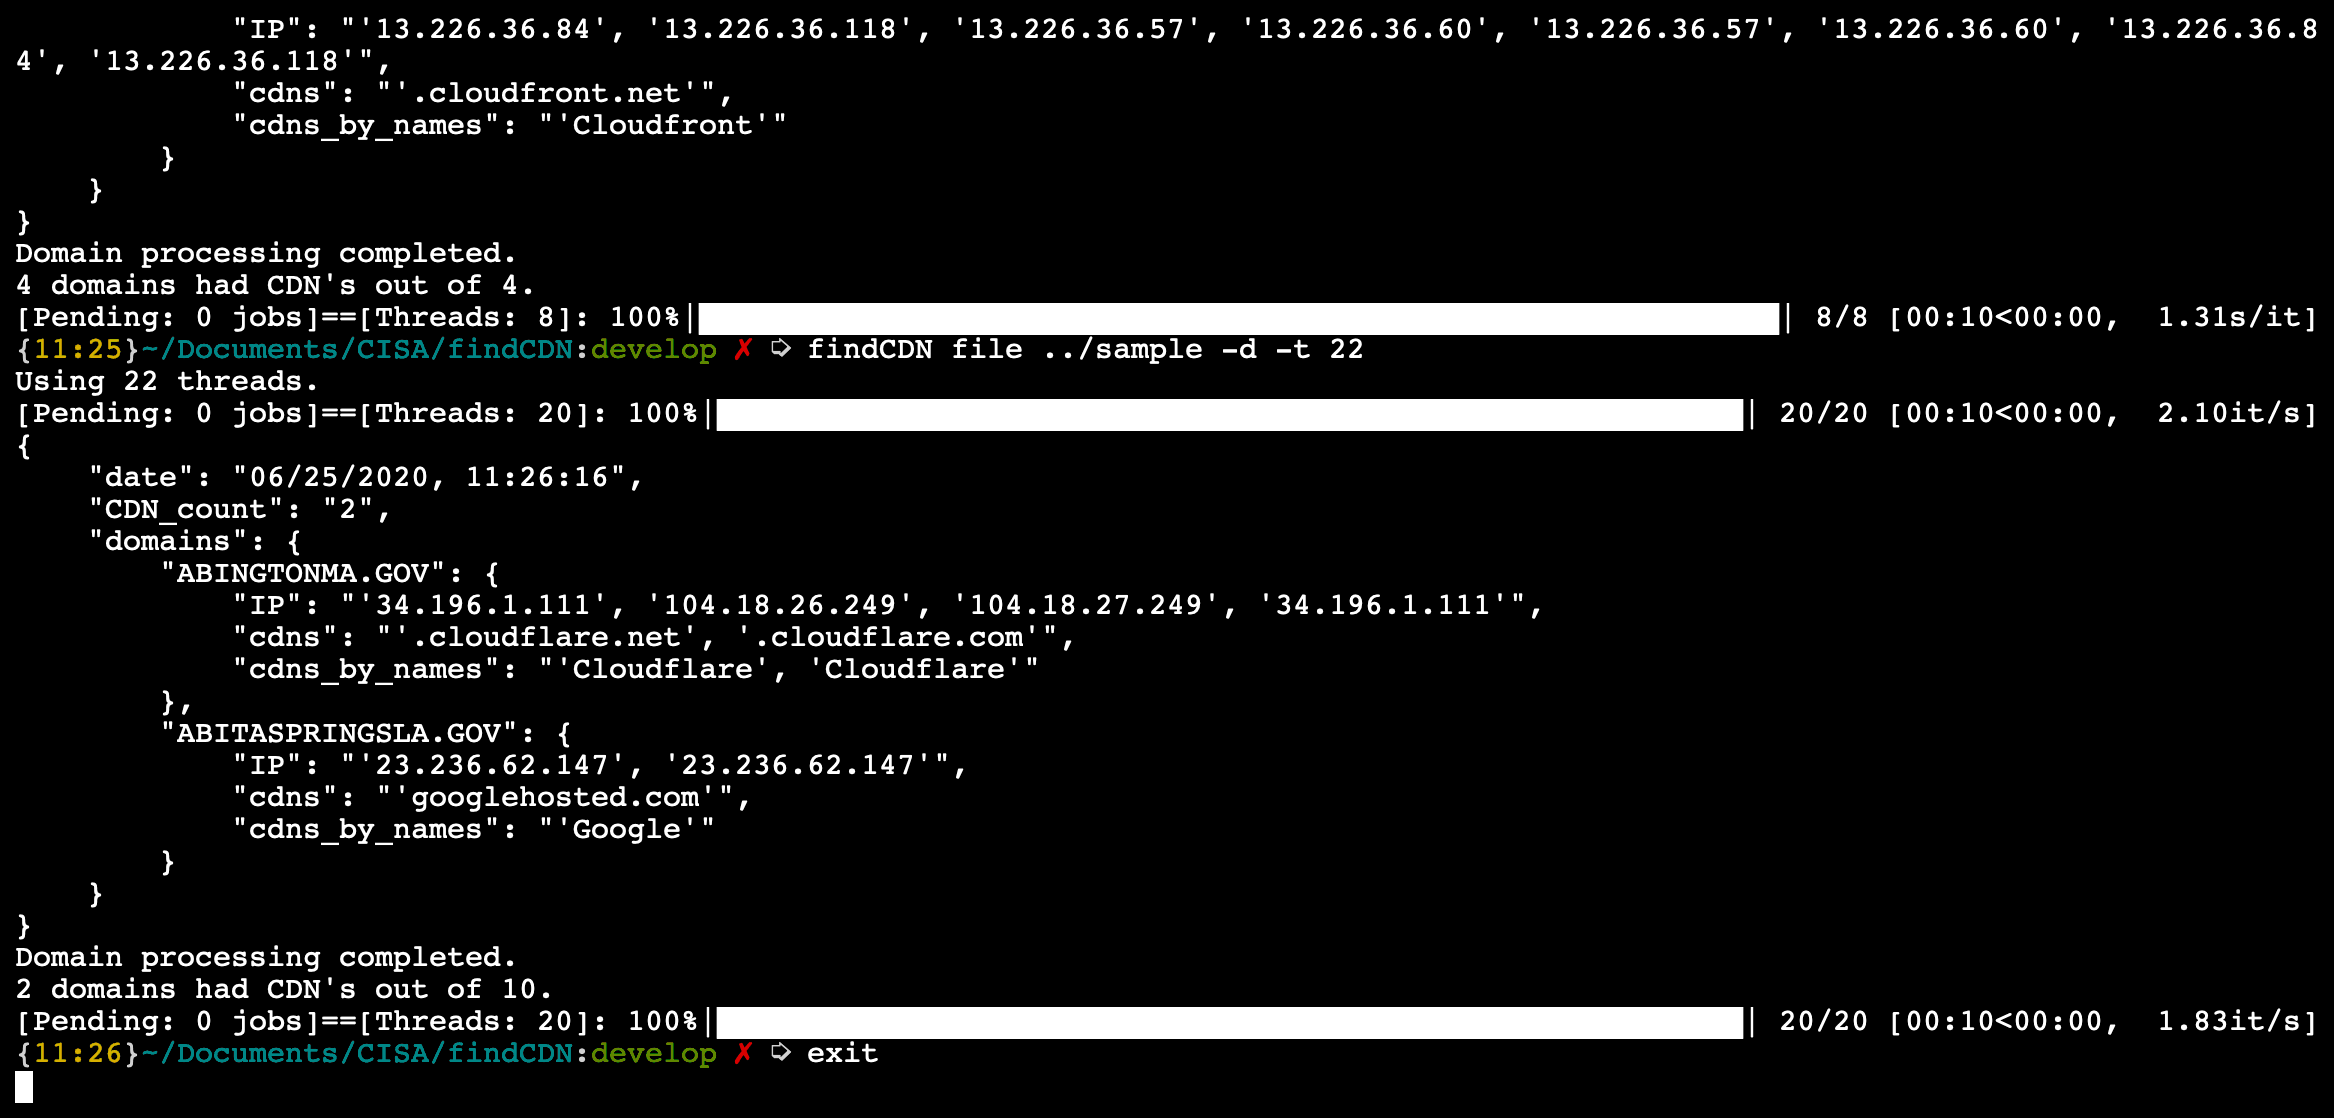
findcdn은 모듈로 설치할 수 있으므로, CDN 탐지 기능을 모든 프로젝트에서 호출하고 구현할 수 있습니다. 먼저 위에 표시된 대로 findcdn을 프로젝트로 가져옵니다. 그런 다음 분석할 도메인 목록을 전달합니다. 처리 후 프로그램은 입력된 도메인과 사용하는 CDN을 포함하는 JSON 객체를 반환합니다.
findcdn이 작동하는 방식은 전달된 옵션에 따라 결정됩니다. 현재 가능한 옵션과 예제가 아래에 편의를 위해 작성되어 있습니다:
findcdn.main(
    domain_list: List[str],  # 검색할 도메인 목록
    output_path: str = None,  # 포함된 경우 결과를 JSON으로 출력
    verbose: bool = False,  # 상세 모드 (더 많은 출력!)
    all_domains: bool = False,  # CDN이 없는 도메인도 출력에 포함
    interactive: bool = False,  # 진행 표시줄 포함 (일반적으로 명령줄에서 사용)
    double_in: bool = False,  # 정확도를 높이기 위해 도메인 시도 횟수를 두 배로
    threads: int = THREADS,  # 사용할 스레드 수
    timeout: int = TIMEOUT,  # 도메인을 기다리는 시간
    user_agent: str = USER_AGENT,  # 사용할 사용자 에이전트
)
import findcdn
import json

domains = ['google.com', 'cisa.gov', 'censys.io', 'yahoo.com', 'pbs.org', 'github.com']
resp_json = findcdn.main(domains, output_path="output.json", double_in=True, threads=23)

dumped_json = json.loads(resp_json)

for domain in dumped_json['domains']:
    print(f"{domain} has CDNs:\n {dumped_json['domains'][domain]['cdns']}")
findcdn은 세 부분으로 나뉩니다:
Chef는 CDN 탐지 라이브러리를 사용하여 각 도메인의 모든 CDN을 가져옵니다Chef는 도메인이 CDN을 가지고 있다고 탐지하면 불리언 has_cdn 값을 설정하는 분석을 실행하고
러너 파일에 도메인 목록을 반환합니다cdn_config.py에 정의된 CDN을 식별하기 위해 지문 스캔을 실행합니다.이 도구의 원래 목적은 CDN을 사용하는 도메인이 프론팅 가능한지 자동으로 탐지하는 것이었습니다. 프론팅 탐지에 상당한 오버헤드가 발생하여, 우리는 이 도구의 개발을 전적으로 CDN 탐지 도구로 전환했습니다. 우리는 wiki를 사용하여 도메인 프론팅이 무엇인지, 연구 노트, 설계 결정, 특정 도메인 프론팅을 위한 플레이북을 추가로 설명합니다. 추가로 프론팅 가능한 도메인이나 현재 플레이북의 결함을 발견하면 기여를 고려해 주세요!
더 많은 정보는 우리 wiki 페이지에 있습니다. 프로젝트나 wiki에 추가되기를 원하는 기능 요청이나 기여를 해 주시기 바랍니다.
이는 다음 중 어느 것이든 될 수 있습니다:
기여를 환영합니다! 자세한 내용은 CONTRIBUTING.md를 참조하세요.
이 프로젝트는 전 세계적으로 퍼블릭 도메인에 있습니다.
이 프로젝트는 미국 내에서 퍼블릭 도메인에 있으며, 전 세계적으로 저작권 및 관련 권리는 CC0 1.0 Universal 퍼블릭 도메인 헌정을 통해 포기됩니다.
이 프로젝트에 대한 모든 기여는 CC0 헌정에 따라 릴리스됩니다. 풀 리퀘스트를 제출함으로써 귀하는 저작권 이익의 포기에 동의하는 것에 동의합니다.
