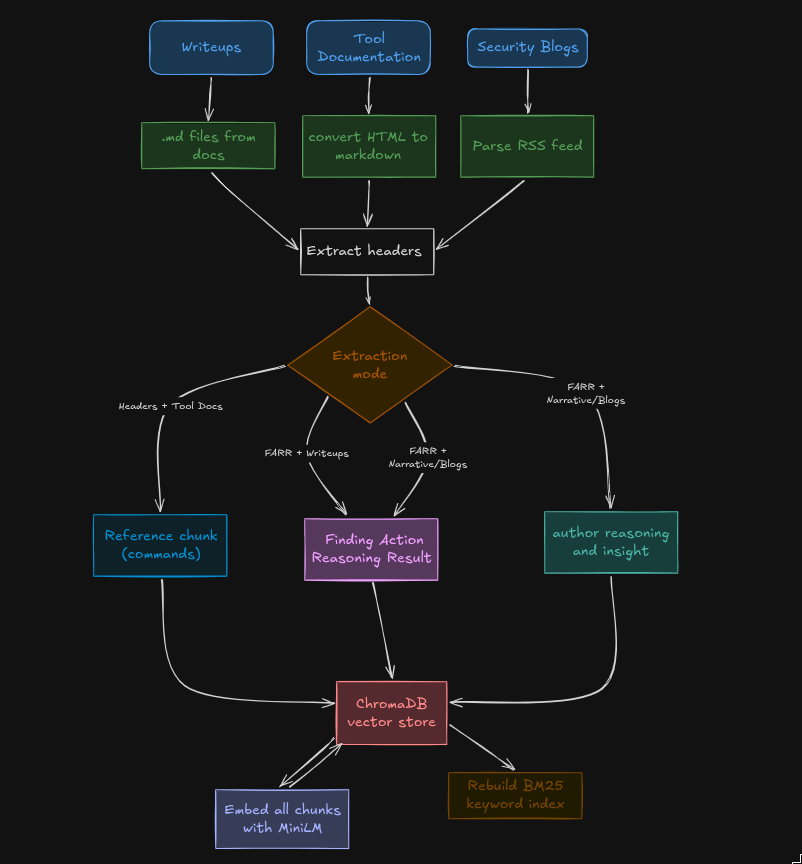


공격적 보안 지식을 위한 개인 RAG 시스템
오프라인 개인 RAG 시스템으로, 침투 테스트 지식을 관리합니다. 여러분의 writeup, 실습 솔루션, 버그 바운티 보고서, 보안 블로그를 수집한 후, 실무 중에 자연어로 질의할 수 있습니다. 클라우드도, SaaS도 없이, 여러분의 지식은 여러분의 것입니다.
ZETSU는 여러분이 축적한 지식을 질의 가능한 어시스턴트로 바꿔줍니다. 마크다운 파일을 grep하거나, certipy 명령어가 어느 writeup에 있었는지 기억하려고 애쓰는 대신, 자연스럽게 물어보세요:
SeImpersonatePrivilege로 어떻게 권한 상승하나요?
ADFS 접근 후에 무엇을 했나요?
sliver socks5 pivot 설정
ESC8 vs ESC4 설명
먼저 실제 노트에서 검색한 후, 여러분이 기록한 내용에 기반한 답변을 생성합니다. 일반적인 인터넷 지식이 아닙니다.
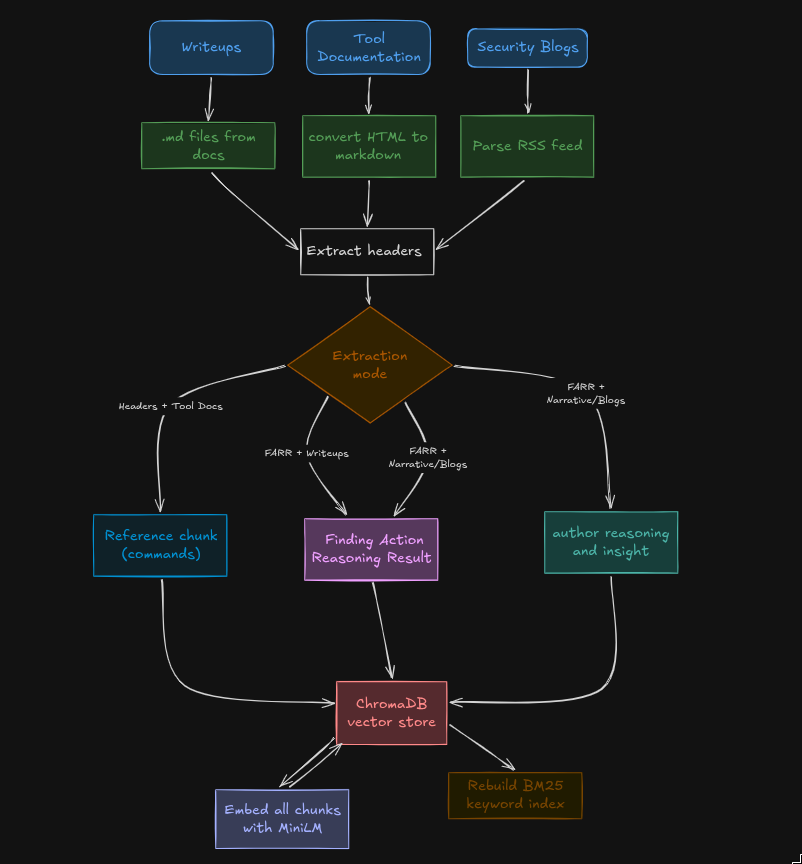
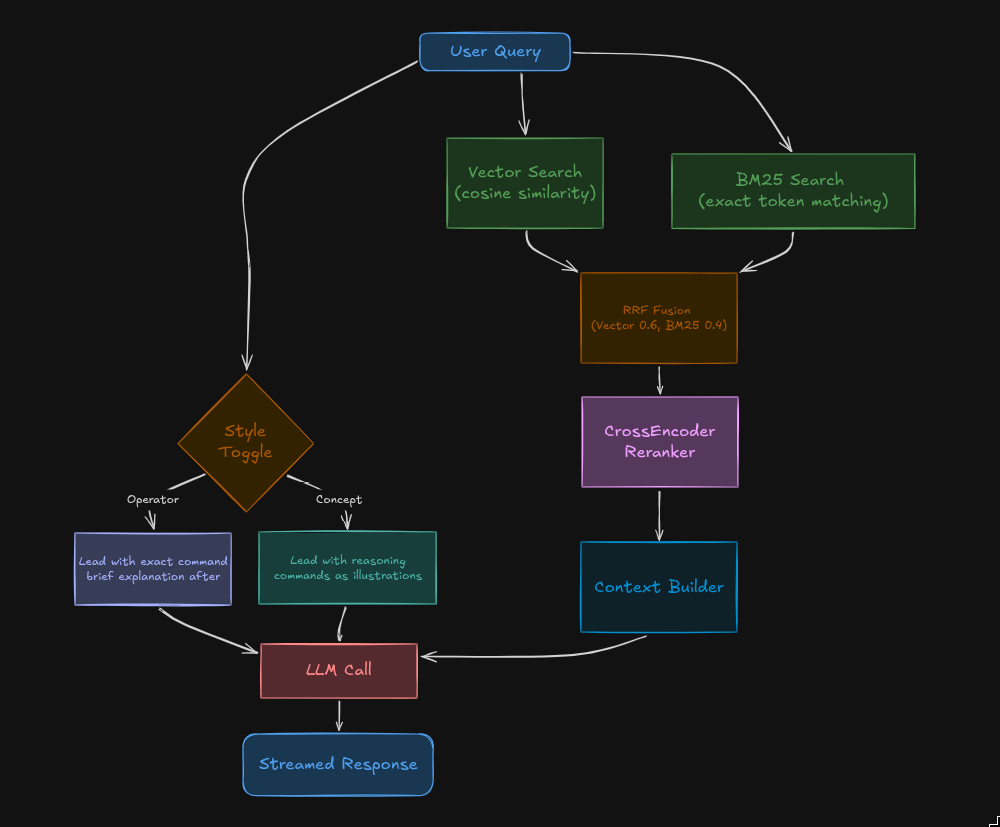
Ctrl+M으로 전환 가능.~/.zetsu/history/YYYY-MM-DD.json에 저장되며 /history로 탐색 가능.git clone https://github.com/chaelsoo/zetsu
cd zetsu
pip install -r requirements.txt
API 키 설정:
cp .env.example .env
# .env를 편집하여 키 추가
1. Writeup 추가
.md 파일을 docs/에 넣으세요. Notion 내보내기, Obsidian 노트, 블로그 내보내기 등 마크다운 형식이면 모두 작동합니다.
2. config.toml에서 소스 구성
[llm]
backend      = "openai"
openai_model = "deepseek-chat"
base_url     = "https://api.deepseek.com/v1"

[[sources]]
type    = "markdown_dir"
path    = "./docs"
name    = "my_writeups"
extract = "farr"
enabled = true
3. 수집
python zetsu.py ingest
4. 사용
python zetsu.py tui       # 터미널 UI
python zetsu.py web       # localhost:8000에서 브라우저
python zetsu.py ask "SeImpersonatePrivilege를 어떻게 악용하나요?"
python zetsu.py ingest                 # 활성화된 소스 수집
python zetsu.py ingest --force         # 모두 초기화 후 재구축
python zetsu.py ingest --dry-run       # LLM 호출 없이 예상만 표시
python zetsu.py ingest --all-sources   # enabled 플래그와 관계없이 모든 소스 활성화
python zetsu.py tui                    # 터미널 UI
python zetsu.py web                    # 웹 UI
python zetsu.py ask "질문"            # 일회성 CLI
python zetsu.py ask "질문" --style concept
python zetsu.py stats                  # 벡터 저장소 통계
| 키 | 동작 |
|---|---|
Enter | 질문 전송 |
Ctrl+M | Operator / Concept 모드 전환 |
Ctrl+Y | 마지막 응답을 클립보드에 복사 |
Ctrl+L | 세션 지우기 |
Ctrl+C | 종료 |
/help | 명령어 표시 |
/stats | 벡터 저장소 + 기록 통계 |
/history | 오늘의 과거 질문 |
/clear | 세션 지우기 |
| 유형 | 사용 예 | 추출 모드 |
|---|---|---|
markdown_dir | Writeup, 노트 | farr |
markdown_file | 단일 마크다운 파일 | farr |
url | 도구 위키, 참조 페이지 | headers |
atom | 피드가 있는 보안 블로그 | farr+narrative |
farr: LLM이 개별 공격 단계를 구조화된 JSON(발견, 행동, 추론, 결과)으로 추출합니다. 명확한 공격 체인이 있는 writeup에 가장 적합합니다.farr+narrative: farr와 동일하며, 저자의 추론을 포착하는 산문 요약을 추가합니다. 사고 과정이 중요한 블로그에 적합합니다.headers: LLM 없이 헤더로 분할하고 원문 그대로 유지합니다. 명령어 참조 및 도구 문서에 적합합니다.config.toml에서 설정합니다. 수집(대량 추출)과 질의(생성)에 별도 백엔드를 사용할 수 있습니다:
[llm]                          # 질의 시
backend      = "openai"
openai_model = "deepseek-chat"
base_url     = "https://api.deepseek.com/v1"

[ingest]                       # 수집 시
backend      = "openai"
openai_model = "deepseek-chat"
base_url     = "https://api.deepseek.com/v1"
workers      = 8               # FARR 추출 중 병렬 파일 처리
지원되는 백엔드: anthropic, openai (모든 OpenAI 호환 API), ollama.
[!IMPORTANT] ChromaDB는 기본적으로 로컬에서 실행되며, 전체 벡터 인덱스를 RAM에 로드합니다. 대규모 말뭉치(10,000개 이상의 청크) 또는 메모리가 제한된 시스템에서는 ChromaDB를 원격 서버로 실행하는 것을 강력히 권장합니다. 설정 방법은 ChromaDB 서버 문서를 참조하세요. ZETSU에서의 원격 지원은 계획 중입니다.
910개의 질문(12개 침투 테스트 범주: ADCS, Kerberos, AD 열거, MSSQL, Sliver C2, 권한 상승, 웹 공격, 자격 증명, 측면 이동, 클라우드/Entra ID, OPSEC, 도구)에 대해 평가했습니다.
| 지표 | 결과 |
|---|---|
| 답변된 질문 수 | 910 / 910 (100%) |
| 코드/명령어가 포함된 답변 | 842 / 910 (93%) |
| 맥락 부재(모델이 정보 부족을 인정) | 66 / 910 (7.3%) |
| 평균 검색 시간 | 68ms |
| 평균 총 응답 시간 | 3.8s |
답변에 가장 많이 기여한 소스: 개인 HTB writeup, dirkjanm 블로그, shenaniganslabs 연구, HackTricks ADCS, Sliver 위키, netexec 치트시트.
간단히 말해, RAG가 수집할 좋고 구조화된 리소스를 추가해야 합니다. 이 프로젝트는 100% 지식 베이스 사용에 초점을 맞추며, LLM의 메모리나 훈련된 지식에 의존하지 않습니다.
전체 평가 데이터와 결과는 eval/에 있습니다.
블로그에서 이 도구의 사용법과 효율성을 곧 문서화할 예정입니다. 계속 지켜봐 주세요.
