 biniamf/ai-reverse-engineering
Ghidra를 활용한 AI 지원 리버스 엔지니어링

# Rev·Deck — Ghidra를 이용한 AI 지원 리버스 엔지니어링

Rev·Deck은 로컬 단일 사용자 정적 분석 워크스테이션입니다. 헤드리스 Ghidra 서비스가 분석한 바이너리 위에서 증거 우선(evidence-first) 웹 UI와 LLM 코파일럿을 결합합니다: 결정적 증거(함수, 문자열, 임포트, 교차 참조, 제한된 호출 그래프)를 직접 탐색하거나, 사실적 주장이 검사 가능한 증거를 인용해야 하는 제한된 질문을 어시스턴트에게 할 수 있습니다.

분석된 바이너리는 절대 실행되지 않습니다. 브라우저는 이 Flask 앱과만 통신하며, 앱은 검증된 타입 요청을 Ghidra 서비스로 프록시합니다.

## 데모

https://github.com/user-attachments/assets/fba14dc5-7ad5-4137-9349-ed824da64fbe

## 빠른 시작 (Docker)

```bash
cp .env.example .env      # set API_BASE and MODEL_NAME; set API_KEY if required
docker compose up --build
```

Docker Compose는 값 보간을 위해 `.env`를 자동으로 읽습니다. `API_BASE` 또는 `MODEL_NAME`이 없으면 시작 전에 실패합니다. `API_KEY=not-used`는 로컬/키 없는 제공업체에서 유효합니다. 이 스택은 두 서비스를 모두 시작합니다. http://127.0.0.1:5000을 엽니다.

Ghidra 서비스만 실행하려면:

```bash
docker pull biniamfd/ghidra-headless-rest:latest   # ensure the newest image

docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:latest
```

재현 가능한 고정을 위해 `latest` 대신 테스트된 릴리스 다이제스트를 사용하세요:

```bash
docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3a8448d8ed969079b452306e806f36079c3ddd298f4a618d6e2f1442d
```

## 사전 요구 사항

- Docker 및 Docker Compose(빠른 시작 경로용), 또는 Python 3.10+ 및 Node.js 18+(소스에서 실행용).
- OpenAI 호환 LLM 엔드포인트(로컬 또는 호스팅)와 모델 이름.
- 공개 Ghidra 이미지: `biniamfd/ghidra-headless-rest:latest`.

## 필수 환경 변수

`.env.example`을 `.env`로 복사하여 입력하세요. 전체 목록과 기본값은 해당 파일을 참조하세요.

| 변수 | 기본값 | 의미 |
| --- | --- | --- |
| `API_BASE` | 필수 | OpenAI 호환 기본 URL(http/https). 없으면 Compose가 조기에 실패합니다. |
| `API_KEY` | `not-used` | 제공업체 키. 절대 기록되거나 브라우저로 전송되지 않습니다. `not-used`는 키 없는 로컬 제공업체에 유효합니다. |
| `MODEL_NAME` | 필수 | 구성된 엔드포인트가 기대하는 모델 ID. 없으면 Compose가 조기에 실패합니다. |
| `LLM_STREAM` | `auto` | 스트리밍 전송: `auto`(스트리밍, 출력 전 호환성 오류 시 한 번 블로킹으로 폴백), `true`(항상 스트리밍), `false`(항상 블로킹). |
| `GHIDRA_API_BASE` | `http://127.0.0.1:9090` | Ghidra 서비스 기본 URL. |
| `GHIDRA_IMAGE` | `biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3...` | 불변 다이제스트로 고정된 테스트 릴리스. `:latest`도 이 다이제스트로 확인됩니다. 다른 릴리스를 고정하려면 재정의하세요. |
| `HOST` / `PORT` | `127.0.0.1` / `5000` | 개발 서버 바인딩. |
| `MAX_UPLOAD_BYTES` | `104857600` | 업로드 크기 상한. |
| `CHATS_DIR` | `webui/chats` | 채팅 기록 디렉터리. |

## LLM 제공업체

Rev·Deck은 OpenAI SDK를 통해 **모든 OpenAI 호환 Chat Completions 엔드포인트**와 통신하며, 전적으로 `API_BASE` / `API_KEY` / `MODEL_NAME`으로 구성됩니다. 제공업체별 헤더, 매개변수 또는 모델 로직은 없습니다. 로컬 [Ollama](https://ollama.com) 서버(`API_BASE=http://127.0.0.1:11434/v1`), 자체 호스팅 vLLM/llama.cpp/LM Studio 엔드포인트, OpenAI 자체, 또는 OpenRouter 같은 게이트웨이 모두 동일한 방식으로 작동합니다.

`.env` 제공업체 설정 예시(자리 표시자를 사용하고 실제 키를 커밋하지 마세요):

```dotenv
# Ollama
API_BASE=http://127.0.0.1:11434/v1
API_KEY=not-used
MODEL_NAME=qwen3:8b
```

```dotenv
# OpenRouter
API_BASE=https://openrouter.ai/api/v1
API_KEY=replace-with-your-key
MODEL_NAME=anthropic/claude-opus-4.8
```

```dotenv
# OpenAI
API_BASE=https://api.openai.com/v1
API_KEY=replace-with-your-key
MODEL_NAME=replace-with-a-supported-model-id
```

```dotenv
# LM Studio, vLLM, or llama.cpp (adjust port/model to the server)
API_BASE=http://127.0.0.1:1234/v1
API_KEY=not-used
MODEL_NAME=replace-with-the-served-model-id
```

기본적으로(`LLM_STREAM=auto`) 어시스턴트는 **스트리밍** 응답을 요청하고 토큰이 도착하는 대로 브라우저에 전달합니다. 스트리밍은 또한 더 강력한 취소 보장을 제공합니다: 응답을 중지하거나(또는 탭을 닫으면) Rev·Deck이 기본 제공업체 스트림을 즉시 닫고 추가 도구 또는 모델 라운드를 수행하지 않으므로, 업스트림 생성이 백그라운드에서 완료될 때까지 남겨지지 않고 중단됩니다.

주의 사항:

- **요금 청구.** 취소하면 즉시 우리 쪽에서 스트림이 닫히지만, 일부 호스팅 제공업체는 클라이언트의 조기 연결 해제와 관계없이 이미 생성한 토큰(또는 전체 완성)에 대해 여전히 청구합니다. 이 보장은 *추가 작업을 수행하지 않는다*는 것이지 제공업체의 청구 정책에 대한 것은 아닙니다.
- **호환성.** 모든 OpenAI 호환 엔드포인트가 도구 포함 스트리밍을 허용하는 것은 아닙니다. `auto` 모드에서 제공업체가 콘텐츠나 도구 호출 출력이 *전혀* 나오기 전에 호환성 오류(HTTP 400/404/405/422)로 스트리밍 요청을 거부하면, Rev·Deck은 한 번만 블로킹 호출로 폴백하고 프로세스의 나머지 동안 이를 기억합니다. 인증(401/403), 속도 제한(429) 및 서버(5xx) 오류는 호환성 문제로 취급되지 **않으며**, 자동 재시도 대신 오류로 표시됩니다. 스트리밍을 완전히 건너뛰려면 `LLM_STREAM=false`를, 스트리밍을 필수로 하려면(폴백 없음) `LLM_STREAM=true`를 설정하세요.

## 사용 방법

앱을 열고 바이너리를 업로드하여 분석 작업을 시작합니다. 명백한 평문 콘텐츠는 Ghidra로 전송되기 전에 확인을 요청합니다. 콘텐츠가 의도적으로 실행 파일 형식이 아닌 펌웨어/데이터인 경우에만 명시적 원시 바이너리(raw-binary) 재정의를 사용하세요. 분석이 완료되면 두 개의 워크스페이스 탭을 전환합니다:

- **분석(Analysis)** — 결정적 증거 보기: 요약, 함수(필터/페이지네이션), 임포트, 문자열, 쿼리 뷰, 함수 인스펙터(의사 코드, 교차 참조, 제한된 호출 그래프, 헥스덤프), 그리고 연결된 Ghidra 서비스가 지원하는 경우 — 타입, 전역 변수, 사이드카 주석, 아카이브 내보내기, 설명 가능한 긍정/완화 신호와 증거 커버리지를 갖춘 결정적 공격 표면(Attack Surface) 순위.
- **채팅(Chat)** — 두 가지 모드 중 하나의 어시스턴트:
  - **코파일럿(Copilot)** (기본값): 메시지당 하나의 제한된 단계/도구 호출로 임시 질문에 사용.
  - **자율(Autonomous)**: 여러 제한된 단계를 스스로 실행하고 작업 중 실시간 활동 타임라인을 표시하는 이름 지정된 예산 기반 워크플로우를 시작합니다.

두 모드 모두 작업별 **단계 예산(step budget)** 과 작업이 끝날 때까지 실행되는 **단계 제한 없음(No step limit)** 옵션이 있습니다(루프에 빠진 모델이 무한정 실행되지 않도록 여전히 `MAX_STEP_BUDGET`으로 제한됨). 실행이 예산에 도달하면 부분 결과를 보고하고 **계속(Continue)** 을 제안합니다. 이는 이미 검색된 증거를 사용하여 동일한 대화를 이어가며 완료된 도구 호출을 다시 수행하지 않습니다. 비용은 도구/모델 호출 수에 비례하여 증가하므로 예산이 높을수록 비용이 더 많이 듭니다.

사용 가능한 워크플로우:

| 워크플로우 | 용도 | 대상 함수 주소 필요 |
| --- | --- | --- |
| `program_triage` | 메타데이터, 임포트, 문자열, 함수에서 프로그램의 예상 용도를 요약합니다. | 아니요 |
| `suspicious_behavior` | 먼저 결정적 지표를 표시한 다음, 제한되고 명확히 라벨링된 가설을 제시합니다. | 아니요 |
| `selected_function` | 함수를 디컴파일하고 호출자/피호출자와 함께 설명합니다. | 예 |
| `call_chain` | 시작 함수에서 제한된 네이티브/합성 호출 그래프 이웃 하나를 탐색합니다. | 예 |
| `attack_surface_triage` | 결정적 점수 커버리지/top-K를 읽은 다음 최대 3개 후보를 심층 검사합니다. 점수는 우선순위이지 판정이 아닙니다. | 아니요 |
| `vulnerability_hypothesis` | 제한된 후보 하나를 선택하고 증거, 반박 증거, 미해결 질문을 제시합니다. 절대 자동 확인하지 않습니다. | 아니요 |

### 집중 하위 조사

각 분석 작업에는 **메인(Main)** 채팅과 선택적인 집중 하위 스레드가 있습니다. **새 하위 조사(New sub-investigation)** 를 선택하고 한 줄 브리핑을 입력한 후, 동일한 바이너리와 동일한 읽기 전용 도구를 사용하여 새로운 대화 컨텍스트로 작업합니다. 스레드 기록은 격리된 상태로 유지되며 한 번에 하나의 스레드만 스트리밍됩니다.

집중 작업이 완료되면 **부모에게 결론 반환(Return conclusion to parent)** 을 선택합니다. Rev·Deck은 해당 하위 스레드에 대해서만 한 번의 제한된 모델 호출을 수행하고, 증거 인용을 검증한 다음, 출처가 표시된 결론 카드 하나를 부모 스레드에 추가합니다. 전체 분기는 다시 열 수 있는 상태로 유지되며, 부모 컨텍스트는 분기 기록이 아닌 간결한 결론만 받습니다. 검증된 인용이 없는 반환 카드는 명시적으로 미검증으로 표시됩니다.

어시스턴트 답변은 `[function:0xADDR]`, `[string:0xADDR]`, `[import:name]` 형식으로 증거를 인라인 인용합니다. 인용은 턴 중에 실제로 검색된 내용과 대조하여 확인됩니다. 일치하지 않는 인용은 "(unverified)"로 표시되며 사실이 아닌 미확인 주장으로 취급해야 합니다.

어시스턴트 출력의 Mermaid 다이어그램(예: 호출 그래프 스케치)은 외부 네트워크 접근이 없는 샌드박스 프레임에서 렌더링됩니다.

## 아키텍처

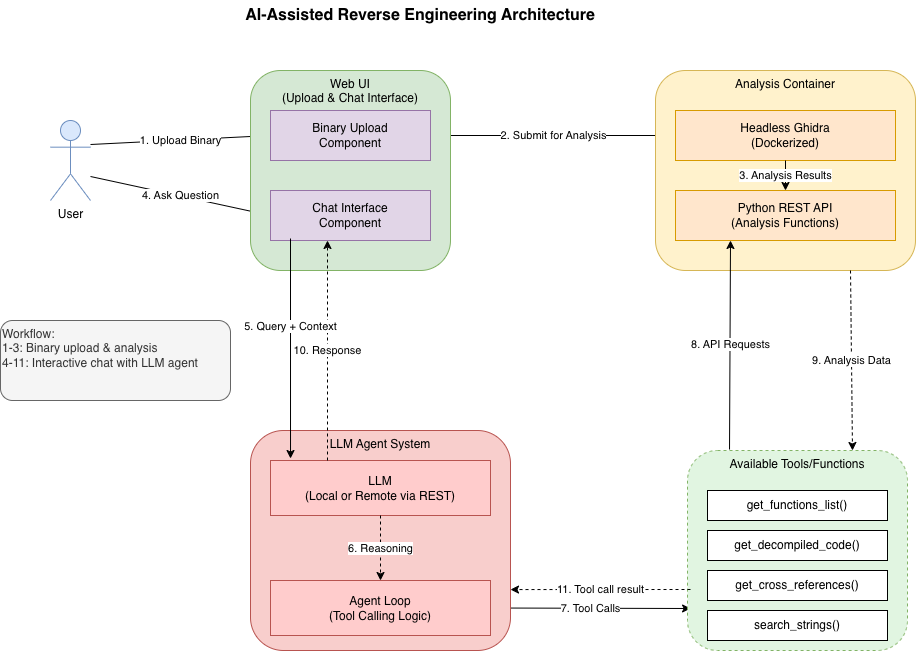
브라우저는 Rev·Deck 웹 애플리케이션과만 통신합니다. Rev·Deck은 구성된 LLM과 헤드리스 Ghidra 서비스를 조정한 다음, 결과 증거와 에이전트 활동을 하나의 워크스페이스에 표시합니다.

<img width="916" height="651" alt="Rev·Deck 아키텍처" src="https://assets.kitploit.com/production/public/readmes/9561/40809484745cf03bf42790c8abff0146755ebb953a3774c8fac17fbc3c0552de.png" />

## 소스에서 실행

```bash
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
npm ci && npm run vendor        # one-time: vendors the pinned Mermaid runtime

cp .env.example .env            # edit API_BASE / MODEL_NAME / API_KEY
set -a; source .env; set +a     # plain Python does not load .env automatically

# Start the separate Ghidra service, then:
python webui/app.py
```

http://127.0.0.1:5000을 엽니다. Docker Compose는 `.env`를 자동으로 읽습니다. 소스 실행은 위와 같이 내보내기(export)가 필요합니다. Flask 개발 서버는 로컬 사용에 적합하며, Docker 이미지는 Gunicorn을 실행합니다.

## 보안 / 로컬 전용 경계

이 도구는 개인 머신에서 작업하는 신뢰할 수 있는 단일 분석가를 위해 설계되었습니다 — 다중 사용자 또는 공개 호스팅용이 아닙니다. 기본적으로 앱과 Ghidra 서비스는 `127.0.0.1`에만 바인딩되고, 디버그 모드는 꺼져 있으며, 업로드된 바이너리는 절대 실행되지 않고, LLM 제공업체 키는 서버 측에 유지됩니다.

## 테스트

```bash
pip install -r requirements.txt -r requirements-dev.txt
python -m pytest
node --test "webui/static/js/tests/**/*.test.mjs"
npm ci && npm run vendor:verify   # verifies the vendored Mermaid bundle's integrity
```

## 문제 해결

- **"서비스 오프라인(Service offline)" / `/readyz`가 503 반환** — `GHIDRA_API_BASE`에서 Ghidra 서비스에 연결할 수 없거나 `API_BASE`/`MODEL_NAME`이 설정되지 않았습니다.
- **타입/전역/주석에 "requires v1" 표시** — 연결된 Ghidra 서비스가 해당 기능을 광고하지 않습니다. 이전 버전 서비스에서 예상되는 현상입니다.
- **채팅이 즉시 오류 발생** — `API_BASE`/`API_KEY`/`MODEL_NAME`과 제공업체가 `LLM_TIMEOUT` 내에 연결 가능한지 확인하세요.
- **업로드가 너무 크다는 이유로 거부됨** — `MAX_UPLOAD_BYTES`를 높이세요.
- **업로드가 평문처럼 보임** — Rev·Deck이 Ghidra로 전송하기 전에 확인합니다. 의도적인 경우에만 원시 바이너리로 계속 진행하세요.
- **대규모 분석 시간 초과** — Ghidra 컨테이너의 `ANALYSIS_TIMEOUT`을 늘리고(예: 함수가 1만 개 이상인 C++/Android 바이너리의 경우 `5400`) 다시 업로드하세요. `LLM_TIMEOUT`과는 관련이 없습니다.
- **인용문에 "(unverified)" 표시** — 모델이 실제로 검색하지 않은 증거를 인용한 것입니다. 해당 주장은 미확인 가설로 취급하세요.
