 andreyglauzer/vigilantonion
🐍 - tor 네트워크 사이트에서 키워드를 검색하는 크롤러입니다.



tor 네트워크 사이트에서 키워드를 검색하는 크롤러.
VigilantOnion은 사이버 위협 인텔리전스 팀이 tor 네트워크에서 수행된 조회의 최상의 결과를 모니터링하고 얻을 수 있도록 보완해 줍니다.
관리 및 대시보드 생성을 위해 django를 사용한 첫 번째 버전에서는 사용에 큰 어려움이 있었습니다. 이 새로운 버전에서는 조회 방식과 오탐을 제거하는 방법론이 더 개선되었습니다.
오탐을 제거하고 정확도를 더 높이기 위해, 아래 그림과 같이 가장 관련성이 높다고 판단되는 규칙에 높은 값을 설정하여 yararule과 notes를 사용하고 있습니다:
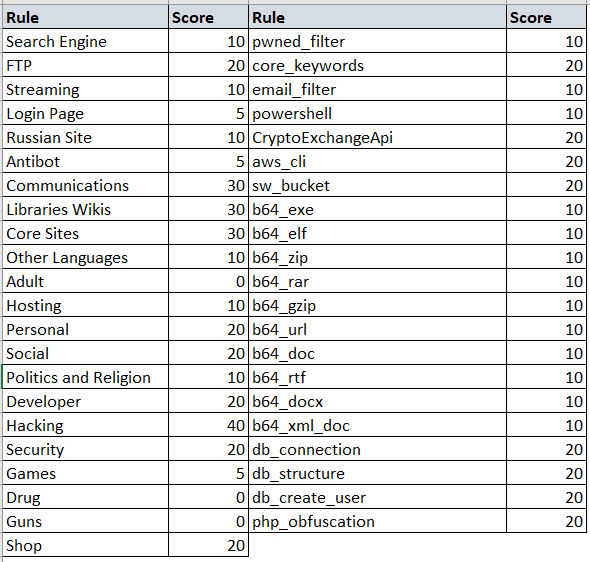
이 값들은 동적이며 필요에 따라 변경할 수 있습니다.
카테고리 파일과 키워드 파일 모두에 새로운 yararule을 추가할 수 있으므로, 오탐을 제거하고 더 만족스러운 결과를 얻을 수 있습니다.
설정 파일에서 변경해야 할 사항은 많지 않지만, 스크립트 사용에 매우 중요합니다.
아래 필드는 tor 네트워크 프록시 구성용이며, Windows에서 스크립트를 실행하는 경우 포트가 보통 9051로 변경됩니다
server_proxy:  localhost
port_proxy:  9050
type_proxy:  socks5h
timeout 서버 필드는 요청을 기다리는 시간을 결정하는 것으로, 시간이 길수록 스크립트 실행 시간이 길어질 수 있습니다.
timeout: 30
score 서버 필드는 URL이 크롤링되어 syslog로 전송되기 위한 최소 점수 값을 결정하는 것입니다.
score_categorie:  20
score_keywords:  40
일부 URL은 오프라인 상태가 되며 다시 돌아올지 알기 어렵기 때문에, 최대 시도 횟수를 지정할 수 있는 카운터를 만들었으며, 이 횟수에 도달하면 스크립트는 더 이상 해당 URL에 접근을 시도하지 않습니다.
count_categories: 5
URL에서 크롤링이 수행될 때마다 마지막 스캔 날짜와 함께 저장되며, 동일한 URL에 대해 스캔 사이의 일수 제한을 지정할 수 있습니다.
daystime: 10
그리고 마지막으로 더 이상 django를 사용하지 않으므로, 이제 결과를 보려면 Splunk나 ELK 같은 syslog가 필요하며, 여기에서 정의하기만 하면 됩니다
sendlog:  True
logport:  5151
logip:  "localhost"
사용법은 더 간단합니다. tor와 python 라이브러리만 설치되어 있으면 되며, 이를 위해 아래 명령을 실행하세요:
pip install -r requirements.txt
tor 클라이언트와 라이브러리 설치 후 --help 명령을 사용하여 사용법에 대한 세부 정보를 확인하세요.
➜  python3 observer.py -h
usage: observer.py [-h] [--config CONFIG] [--crawler] [--url URL] [--search]
                   [--engines ENGINES] [--find FIND] [--pastebin PASTEBIN]

VigilantOnion is a script to collect as many sites from the onion network as
possible and add them to a database. With all possible sites collected, a
crawler will be created so that we can monitor the search for keywords defined
by you.

optional arguments:
  -h, --help            show this help message and exit
  --config CONFIG, -c CONFIG
                        Configuration file in yaml format
  --crawler             Starts the TOR network URL crawler process.
  --url URL, -u URL     Specifies the URL to crawl.
  --search              Start the URL search process on the surface. Select a
                        framework where you want to search for urls.
  --engines ENGINES, -e ENGINES
                        Validates the available engines for searching URLs.
  --find FIND, -f FIND  Search for arguments on .onion network research sites
  --pastebin PASTEBIN   Search for .onion urls in pastebin paste.

You can also develop new framework so that the database has more urls onions.
스크립트가 작동하려면 새로운 URL이 필요하며, 이를 위해 아래 예시처럼 표면에서 URL을 검색하는 메서드를 만들었습니다:
python3.6 observer.py --config config/config.yml --search -e "gist,reddit,cybersecuritynews,discoverdarkwebservice"
아래 예시처럼 pastebin 파일에서 직접 URL을 가져올 수도 있습니다:
python3.6 observer.py --config config/config.yml --search --pastebin "s7TPZCKz,kSaYqtVX,0GYEEApe,3qkqyqiM,RfgBLg5Q,gtksBij4,FpPzQKHg,wB0uh00r,jDGJhQCC,q6DZ9U,ac2TnUjY,pv4xRWXQ,PgLUE7pF,9XW5Pc7R,hqyGMi7e,UZRM2z8y,7tQvV5CU,9JhVq3H3,Cb5HTydt,kMW5wp3N,v5Yq66sH,2q3SsR3a,gnd8jx97,QwSJYhYF,iNydrDfe"
URL을 어느 정도 수집한 후에는 크롤러 프로세스를 시작할 수 있습니다. 첫 번째 실행이 가장 오래 걸린다는 점을 기억하세요. 웹사이트 콘텐츠의 분류 및 범주화가 바로 이 단계에서 이루어지기 때문입니다.
python3.6 observer.py --config config/config.yml --crawler
단일 URL을 크롤링하려면 다음을 사용하세요:
python3.6 observer.py --config config/config.yml --crawler --url "76qugh5bey5gum7l.onion"
결과의 출력은 json이며, 동일한 형식으로 선택한 syslog로 전송됩니다.
{
  "lastscan": "2020-06-29",
  "id": 10760,
  "type": "URI",
  "url": "lolitmhfkpif7sky.onion",
  "title": "Lolita Club",
  "baseurl": "vyqi2nm36otufrgg.onion",
  "status": "Online",
  "count_status": 0,
  "source": "Script",
  "categorie": [
    {
      "full_categorie": [
        "no_match"
      ],
      "score_categorie": 0
    }
  ],
  "keywords": [
    {
      "full_keywords": [
        "no_match"
      ],
      "score_keywords": 0
    }
  ],
  "discovery_date": "2020-06-29 14:24"
}
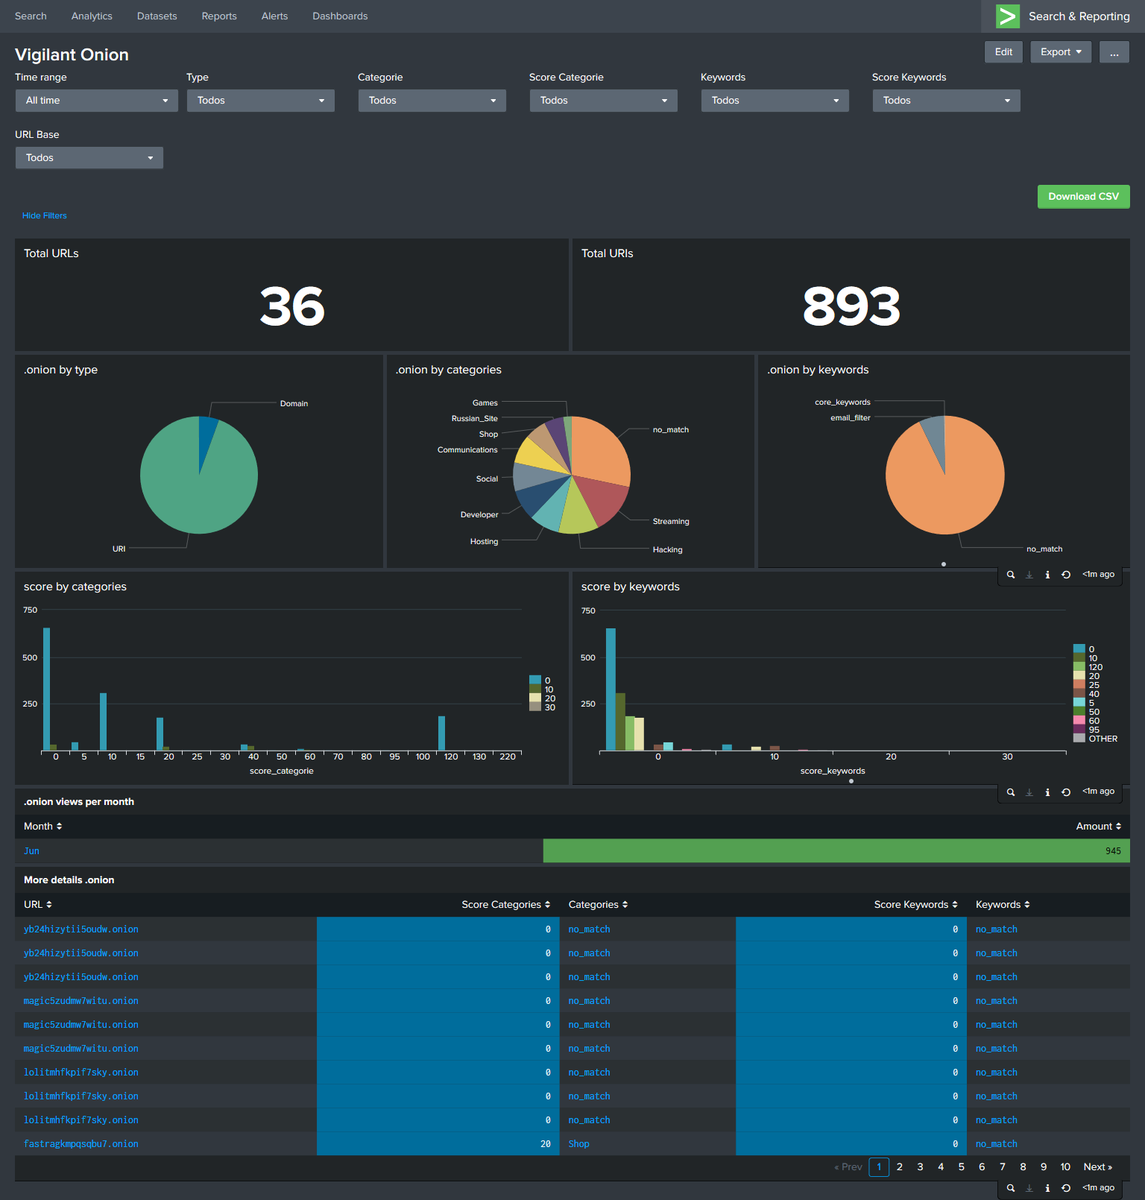
저는 splunk를 사용하며, 여러분도 제 대시보드처럼 보이게 만들 수 있습니다:
프로젝트에 협력하기 위해 자유롭게 포크하거나 이슈를 열어 주세요.
