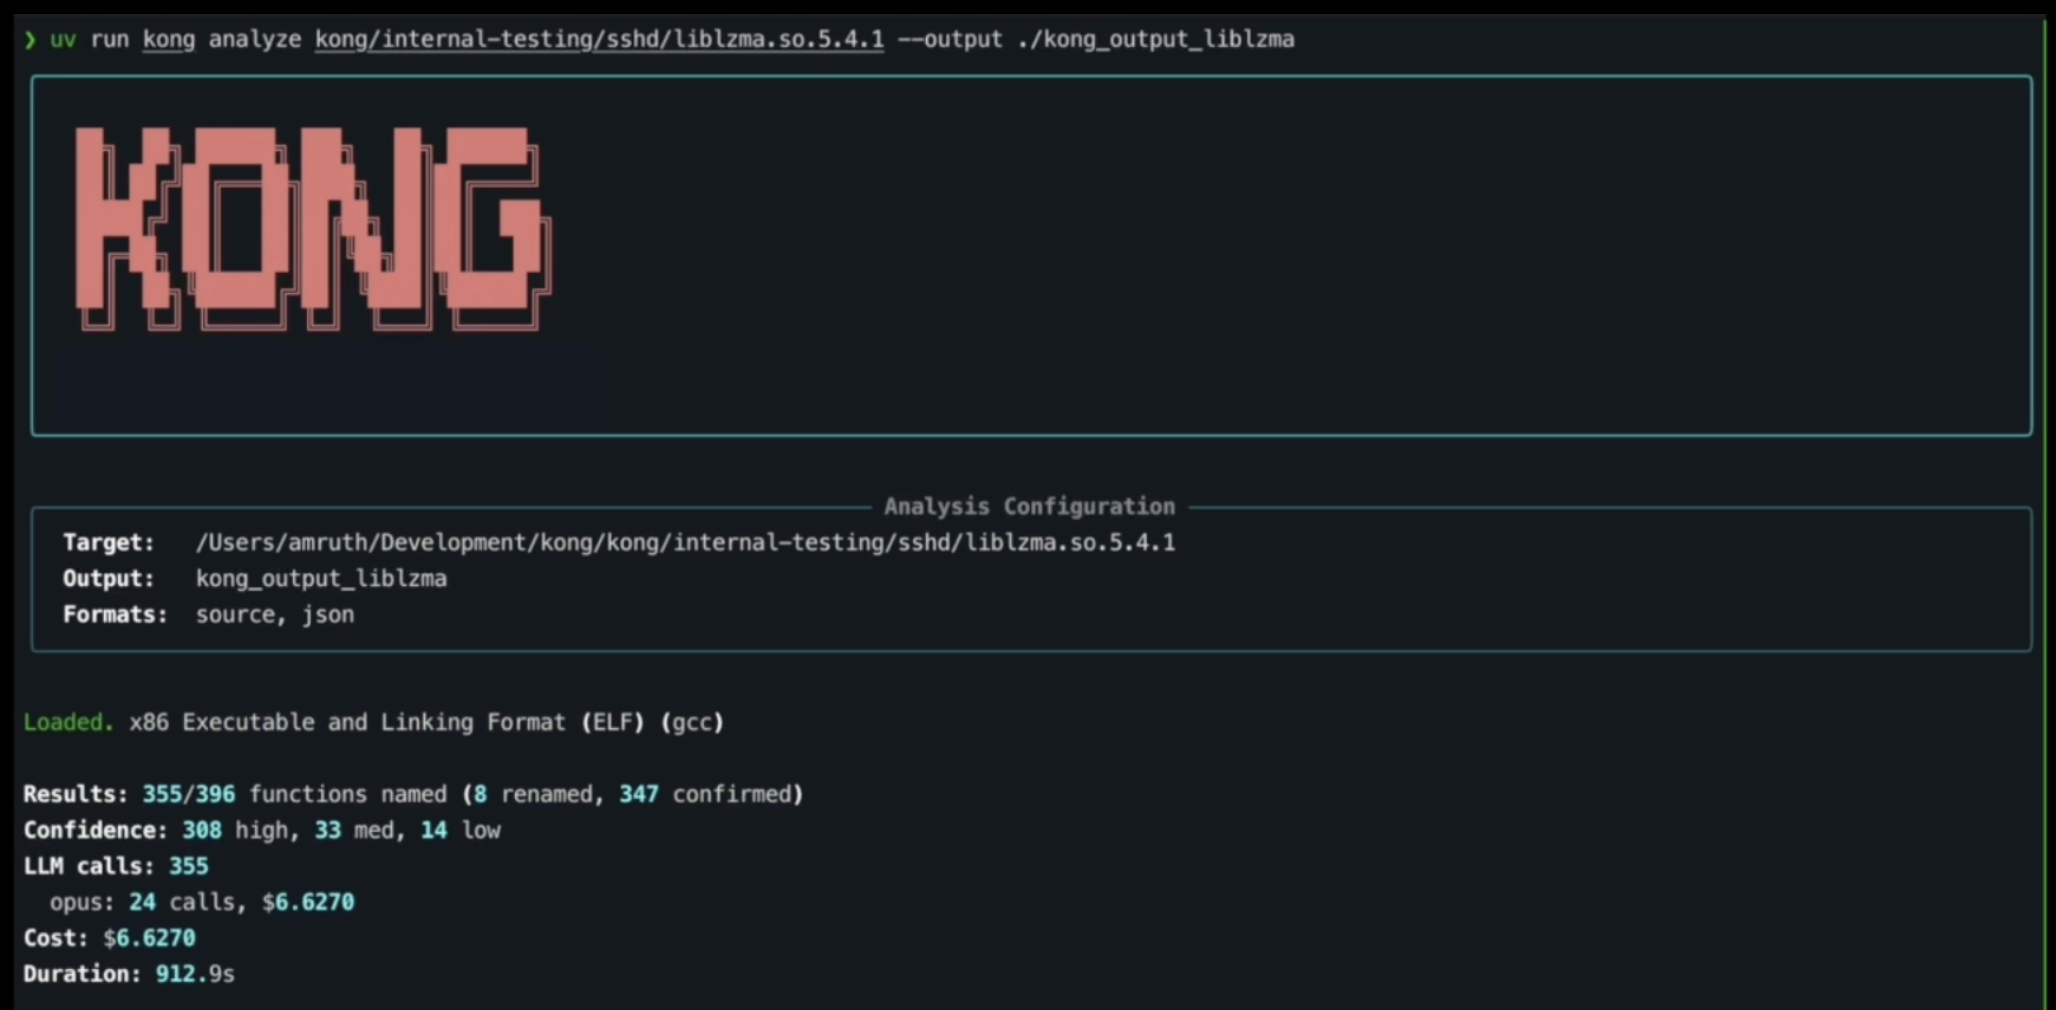
세계 최초의 에이전트 리버스 엔지니어.

바이너리 리버스 엔지니어링을 위한 LLM 오케스트레이션
대부분의 작업은 선형 관계를 따릅니다. 작업이 어려울수록 시간이 더 오래 걸리는 경향이 있습니다. 하지만 리버스 엔지니어링(및 바이너리 분석)은 실제 난이도는 다소 사소하지만 실행 시간이 몇 시간(또는 며칠!)이 걸릴 수 있는 작업입니다. 심지어 함수가 수백 개도 안 되는 바이너리라도 말이죠.
Kong은 NSA 등급의 리버스 엔지니어링 프레임워크를 사용하여 기계적 계층을 자동화합니다. Kong은 완전히 난독화되고 스트립된 바이너리를 가져와 전체 분석 파이프라인(함수 분류, 호출 그래프 컨텍스트 구축, LLM 기반 디컴파일을 통한 타입 및 심볼 복구, 결과를 Ghidra의 프로그램 데이터베이스에 다시 쓰기)을 실행할 수 있습니다. 출력 결과는 FUN_00401a30 같은 함수가 이제 parse_http_header가 되고, 복구된 구조체, 매개변수 이름, 호출 규칙을 갖춘 바이너리입니다.
왜 만들어졌나
스트립된 바이너리는 코드를 읽기 쉽게 만드는 모든 컨텍스트(함수 이름, 타입 정보, 변수 이름, 구조체 레이아웃)를 잃어버립니다. 해당 컨텍스트를 복구하는 것이 대부분의 RE 작업의 주요 부분이며, 이는 주로 패턴 매칭(표준 라이브러리 함수 인식, 사용 패턴에서 타입 추론, 호출 그래프를 통한 이름 전파)에 가깝습니다.
LLM은 바로 이런 종류의 패턴 매칭에 능숙합니다. 그러나 디컴파일러 출력을 LLM에 그대로 던지고 "이게 뭘 하는 거야?"라고 묻는 것은 평범한 결과를 줍니다. 모델에는 호출 컨텍스트, 상호 참조 정보, 바이너리가 어떻게 구조화되었는지에 대한 더 넓은 그림이 부족합니다. 게다가 대부분의 난독화된 바이너리는 리버스 엔지니어링을 방지하기 위해 극단적인 기술을 도입합니다.
Kong은 LLM을 건드리기 전에 Ghidra의 프로그램 분석(호출 그래프, 상호 참조, 문자열 참조, 데이터 흐름)에서 풍부한 컨텍스트 윈도우를 구축한 다음, 종속성 순서로 분석을 오케스트레이션하여 각 함수가 이미 명명된 피호출자의 혜택을 받도록 함으로써 이 문제를 해결합니다. 또한, Kong은 자체적인 최초의 에이전틱 디난독화 파이프라인을 도입합니다.
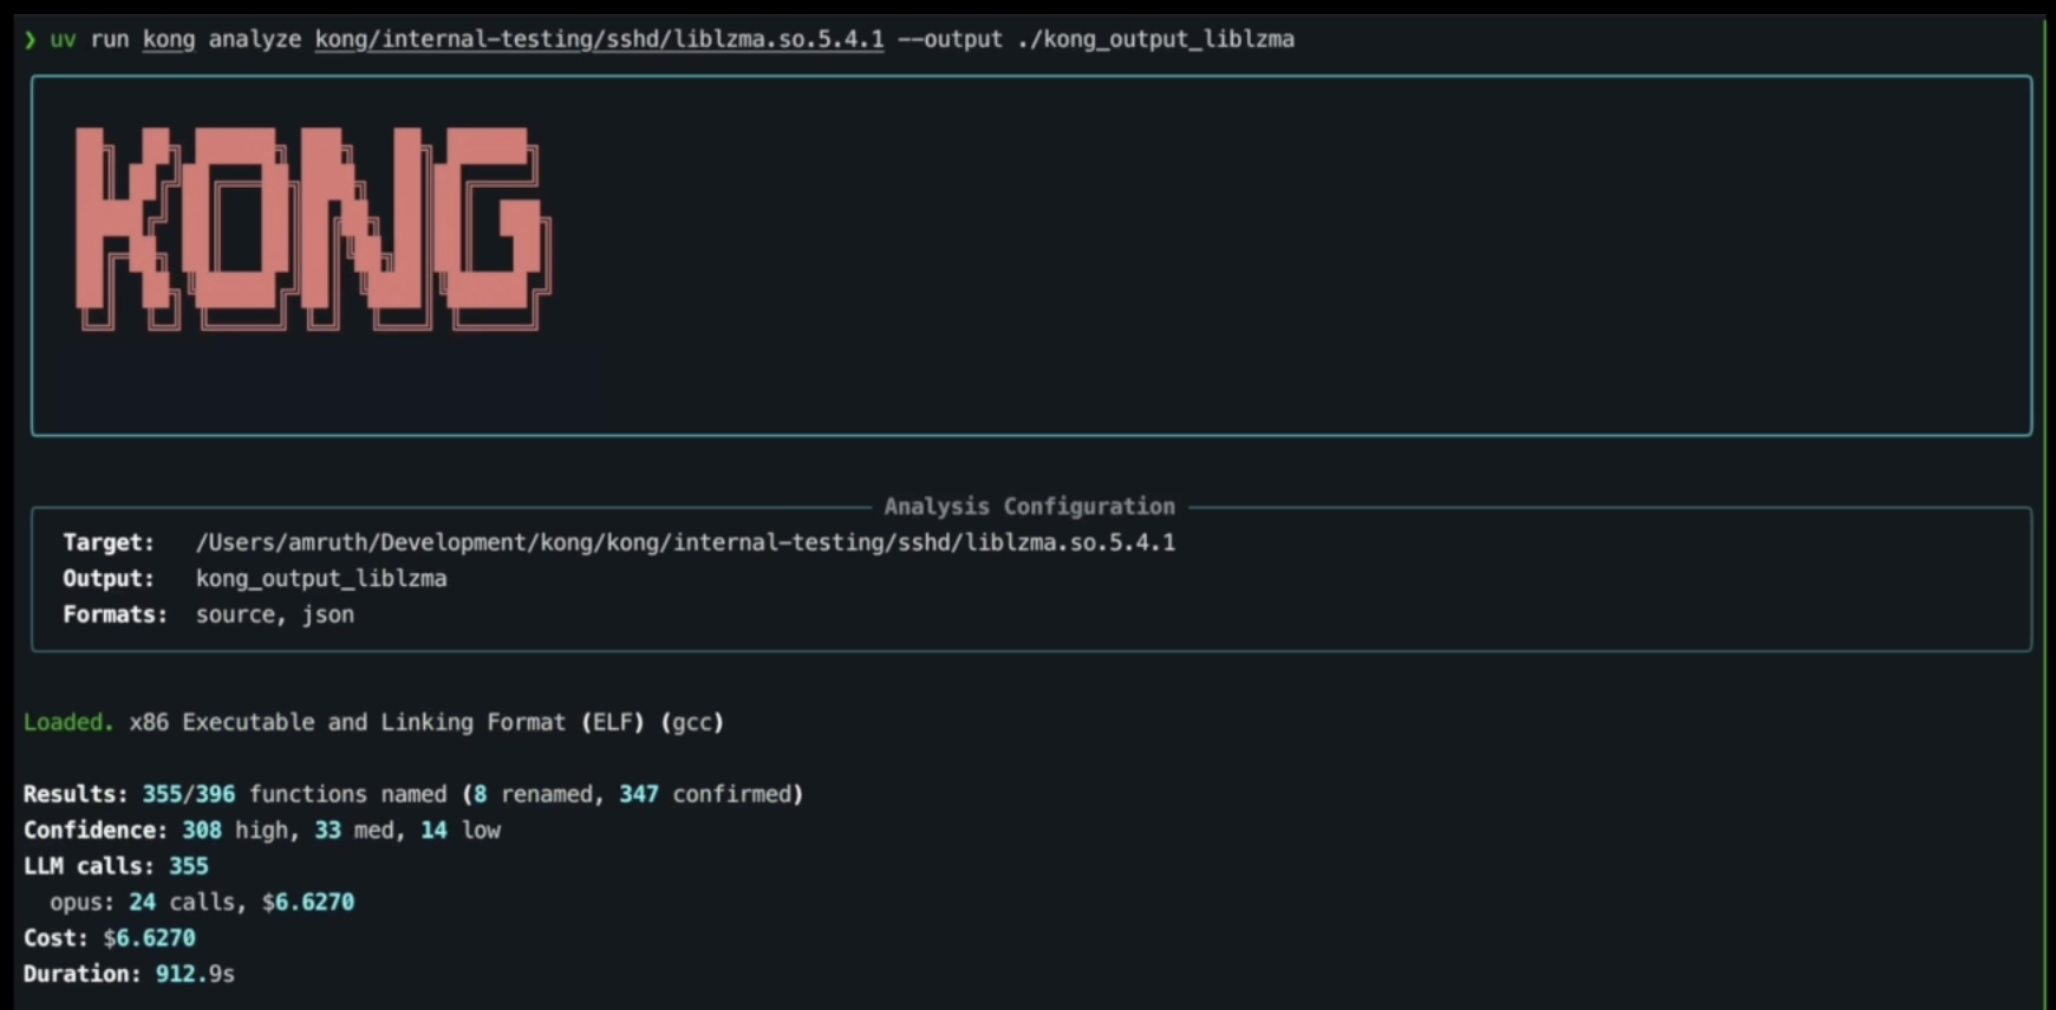
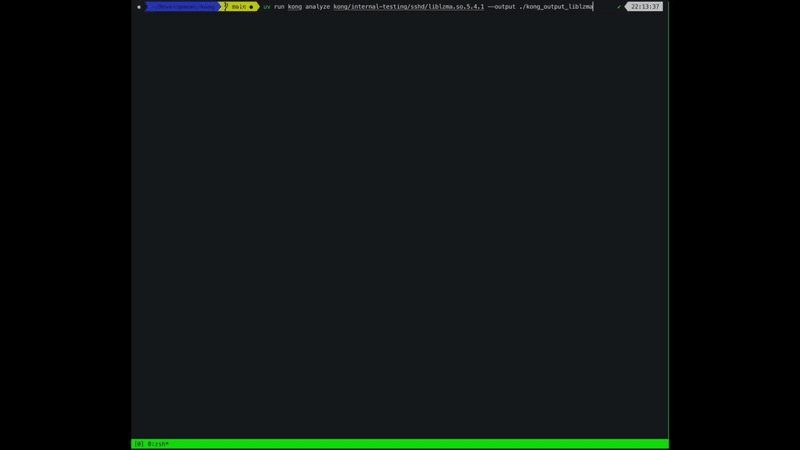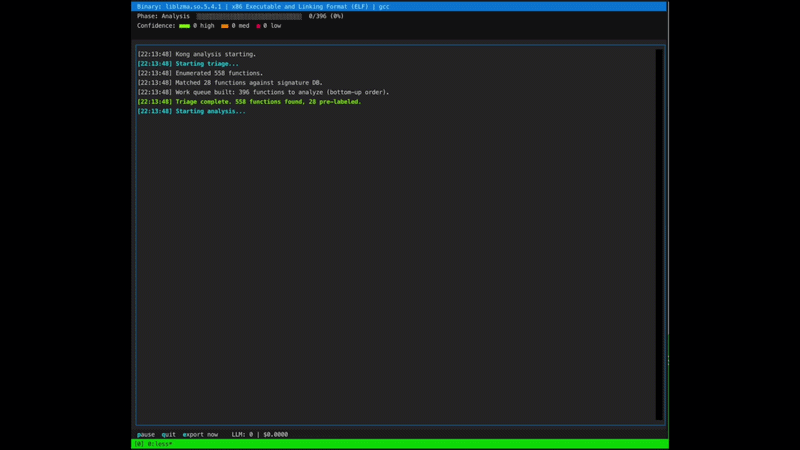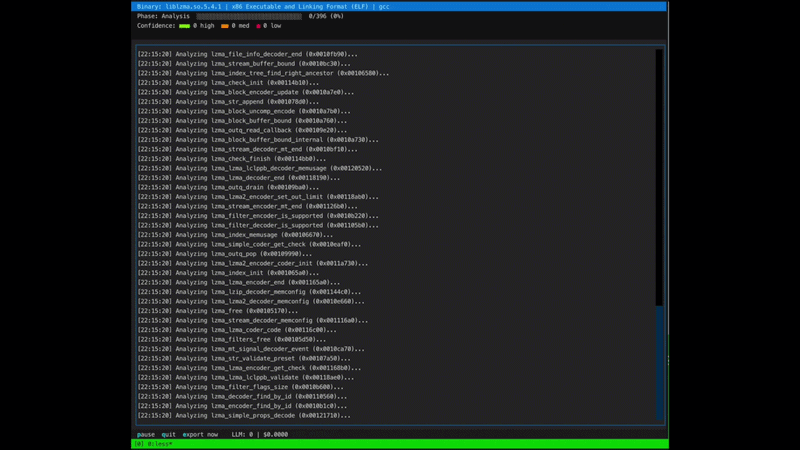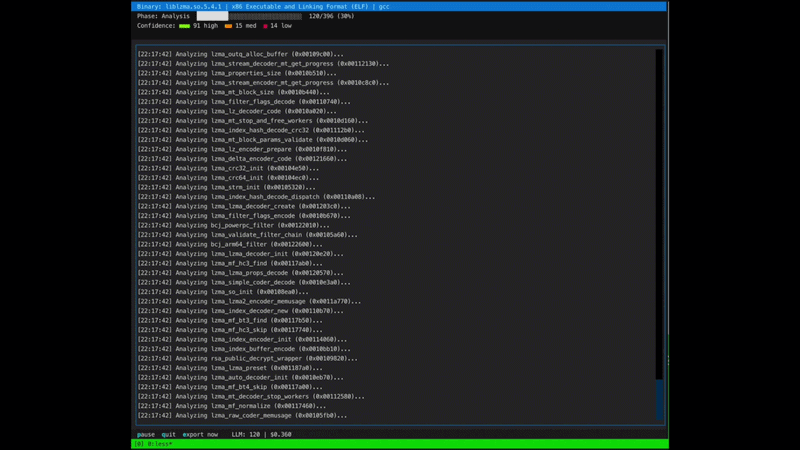
Kong은 대부분의 Ghidra 디컴파일 가능 바이너리에서 작동합니다(현재는, 더 추가 예정).
| C | C++ | Go | Rust | |
|---|---|---|---|---|
| x86 | 높음 | 높음 | 보통 | 보통 |
| x86-64 | 높음 | 높음 | 보통 | 보통 |
| ARM (32-bit) | 높음 | 높음 | 보통 | 낮음 |
| AArch64 | 높음 | 높음 | 보통 | 낮음 |
| MIPS | 보통 | 보통 | 낮음 | 낮음 |
| PowerPC | 보통 | 보통 | 낮음 | 낮음 |
높음: Kong이 안정적으로 디컴파일, 디난독화, 이름, 타입 및 구조를 복구합니다.
보통: 디컴파일은 사용 가능하지만 노이즈가 더 많습니다. 부분적인 복구와 낮은 신뢰도 점수를 예상하세요.
낮음: 디컴파일에 상당한 공백이 있으며 결과는 불완전하거나 노이즈가 많거나 읽을 수 없을 수 있습니다.
참고: 바이너리 크기는 함수 수, LLM 비용 및 완료 시간에 비례하여 증가합니다. 그러나 바이너리 크기는 신뢰도와 반비례하므로, 더 큰 바이너리를 분석할 때 이 점을 명심하세요.
Kong은 분류, 병렬 분석 및 후처리를 조정하는 감독자가 오케스트레이션하는 5단계 파이프라인을 사용합니다.
                    ┌──────────────────────┐
                    │       Triage         │
                    │  enumerate, classify,│
                    │  build call graph,   │
                    │  match signatures    │
                    └──────────┬───────────┘
                               │
                               ▼
              ┌────────────────┼────────────────┐
              │                │                │
              ▼                ▼                ▼
     ┌──────────────┐ ┌──────────────┐ ┌──────────────┐
     │   Analyze    │ │   Analyze    │ │     ...      │
     │  (leaf fns)  │ │ (next tier)  │ │              │
     └──────┬───────┘ └──────┬───────┘ └──────┬───────┘
            │                │                │
            └────────┬───────┴────────────────┘
                     │
                     ▼
            ┌──────────────────────┐
            │      Cleanup         │
            │  normalize, dedupe   │
            └──────────┬───────────┘
                       │
                       ▼
            ┌──────────────────────┐
            │     Synthesis        │
            │  unify names, build  │
            │  structs, deobfuscate│
            └──────────┬───────────┘
                       │
                       ▼
            ┌──────────────────────┐
            │       Export         │
            │  analysis.json +     │
            │  Ghidra writeback    │
            └──────────────────────┘
**분류(Triage)**는 바이너리의 모든 함수를 열거하고, 크기(사소함/작음/중간/큼)별로 분류하며, 호출 그래프를 구축하고, 소스 언어를 감지하며, 알려진 표준 라이브러리 및 암호화 함수에 대한 시그니처 매칭을 실행합니다. 시그니처로 일치된 함수는 해결된 것으로 표시되어 LLM 분석을 완전히 건너뜁니다.
**분석(Analysis)**은 작업 큐를 사용하여 호출 그래프에서 바텀업 순서로 함수를 처리합니다. 각 함수에 대해 Kong은 Ghidra의 프로그램 데이터베이스(디컴파일, 상호 참조, 문자열 참조, 이미 분석된 피호출자의 시그니처)에서 컨텍스트 윈도우를 구축하고, 디컴파일러 출력을 정규화한 후 LLM으로 보내 이름, 타입 및 매개변수 복구를 수행합니다. 함수의 디컴파일에서 난독화가 감지되면, Kong은 분석을 생성하기 전에 기호 도구 접근이 가능한 에이전틱 디난독화 패스를 실행합니다. 결과는 즉시 Ghidra에 다시 기록되므로 다운스트림 호출자가 업데이트된 이름을 볼 수 있습니다.
**정리(Cleanup)**는 분석 중에 축적된 제안에서 구조체 타입을 통합하고, 분석 패스 중에 적용에 실패한 함수 시그니처를 재시도합니다.
**종합(Synthesis)**은 분석된 모든 함수를 전체적으로 바라봅니다. 단일 LLM 호출로 가장 많이 연결된 함수를 검토하고, 명명 규칙을 통합하며, 필드 접근 패턴에서 구조체 정의를 합성하고, 더 넓은 맥락에서 일관성이 없어 보이는 이름을 개선합니다.
**내보내기(Export)**는 최종 analysis.json을 작성하고 복구된 모든 이름, 타입 및 시그니처를 Ghidra 프로그램 데이터베이스에 다시 적용합니다.
# 1. Kong 설치
uv pip install kong-re

# 2. API 키 설정
export ANTHROPIC_API_KEY="sk-ant-..."
# 및/또는
export OPENAI_API_KEY="sk-..."

# 3. 설정 마법사 실행 (최초 1회)
kong setup

# 4. 바이너리 분석
kong analyze ./path/to/stripped_binary
설정 마법사는 사용할 LLM 공급자를 선택하고 기본값을 설정합니다. Kong은 Ghidra 및 JDK 설치를 자동 감지하고, 바이너리를 인-프로세스 Ghidra 인스턴스에 로드한 후 전체 파이프라인을 실행합니다.
git clone https://github.com/amruth-sn/kong.git
cd kong
uv sync
uv run kong setup
uv run kong analyze ./path/to/stripped_binary