
 amazon-science/cyber-zero
런타임 환경 없이 LLM 사이버보안 에이전트를 훈련하고, 페르소나 기반 시뮬레이션을 통해 CTF 해결 궤적을 합성하며, InterCode-CTF, NYU CTF Bench, Cybench에서 평가하는 프레임워크입니다.



🧐 개요 | 🏆 벤치마크 스위트 | 🚀 빠른 시작 | 🏗️ 아키텍처 | ⚙️ 구성 | 📊 생성 | 📝 검증 | 📝 CLI 인터페이스 | 📝 인용
Cyber-Zero는 런타임 실행 환경 없이 사이버보안 에이전트를 훈련하기 위한 종합 프레임워크입니다.
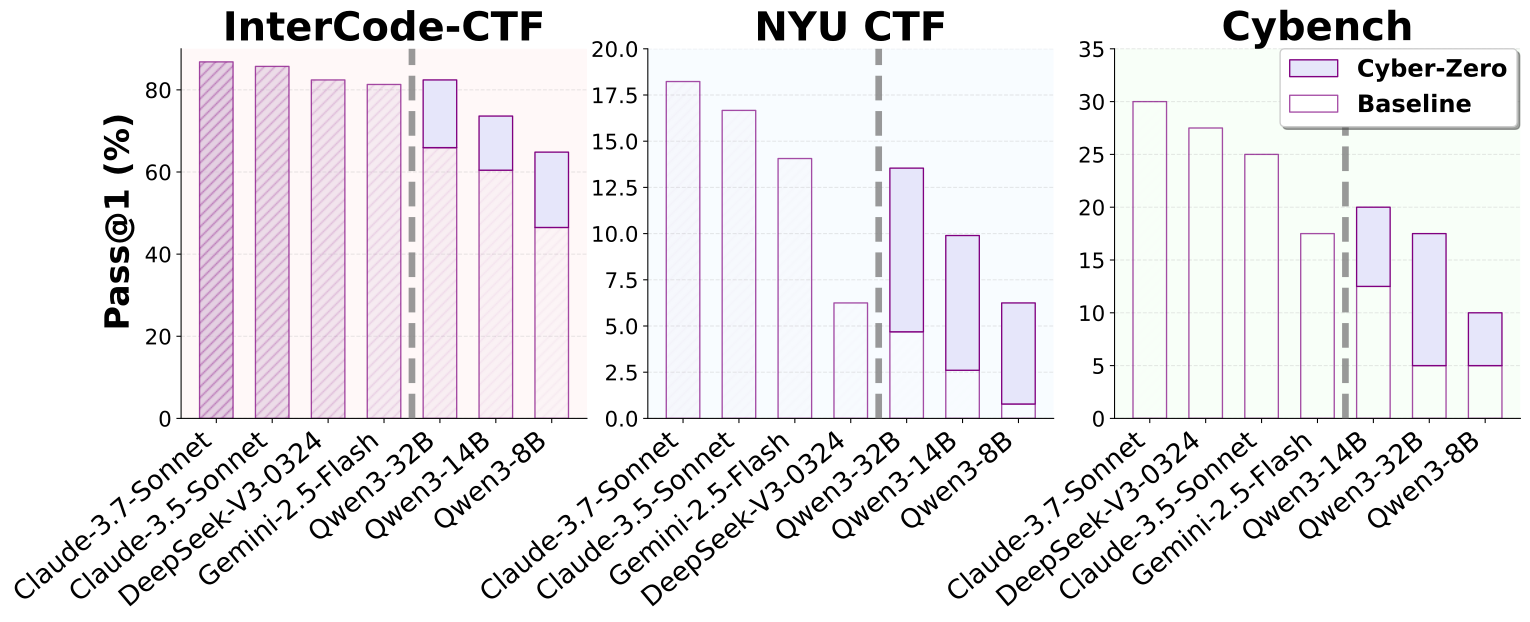
대규모 언어 모델(LLM)은 실행 가능한 런타임 환경과 함께 훈련될 때 소프트웨어 엔지니어링 작업에서 놀라운 성과를 달성했지만, 챌린지 구성과 실행 컨텍스트가 일시적이거나 제한적인 사이버보안 영역에서는 이러한 환경을 종종 사용할 수 없습니다. Cyber-Zero는 공개적으로 이용 가능한 CTF 라이트업(writeup)을 활용하고 페르소나 기반 LLM 시뮬레이션을 적용하여 런타임 동작을 역설계하고 실제 실행 환경 없이도 현실적이고 장기적인 상호작용 시퀀스를 생성함으로써 이러한 근본적인 한계를 해결합니다.
핵심 혁신은 실제 실행 환경을 요구하는 대신 LLM 시뮬레이션을 통해 고품질 훈련 궤적을 생성하는 것으로, 이를 통해 사이버보안 에이전트 훈련이 확장 가능하고 실용적으로 이루어집니다. Cyber-Zero로 합성된 궤적을 사용하여 훈련된 LLM 기반 에이전트는 InterCode-CTF, NYU CTF Bench, Cybench라는 세 가지 주요 CTF 벤치마크에서 기준 모델 대비 최대 13.1%의 절대적 성능 향상을 달성합니다.
사이버보안 에이전트 평가를 대중화하기 위해, Cyber-Zero의 EnIGMA+에 맞게 조정된 세 가지 수정된 벤치마크 스위트를 제공합니다:
모든 벤치마크는 EnIGMA 및 EnIGMA+ 사양을 따르도록 재구성되었으며, 각 챌린지에는 challenge.json 파일과 docker-compose.yml 파일(필요한 경우)이 포함됩니다.
당사의 벤치마크 스위트는 원본 벤치마크에서 확인된 여러 문제를 해결하여 신뢰할 수 있는 평가를 위한 수정된 버전을 제공합니다. 특정 수정 사항 및 개선 사항에 대한 자세한 내용은 benchmarks/README.md를 참조하세요.
사이버보안 에이전트 개발을 촉진하기 위해, 수백 개의 CTF 챌린지를 _며칠_이 아닌 몇 시간 만에 실행하는 EnIGMA의 향상된 에이전트 스캐폴딩인 **EnIGMA+**를 소개합니다. EnIGMA+는 SWE-agent를 기반으로 구축되었습니다.
EnIGMA+를 사용하는 우리의 최고 모델인 Cyber-Zero-32B는 오픈 웨이트 모델 중 새로운 최첨단 성능을 확립하며, DeepSeek-V3-0324 및 Claude-3.5-Sonnet과 같은 독점 시스템의 기능에 필적하면서도 뛰어난 비용 효율성을 제공하여, 런타임 없는 궤적 합성이 최첨단 사이버보안 에이전트 개발을 효과적으로 민주화할 수 있음을 보여줍니다.
설치, 구성 및 사용 지침을 포함한 EnIGMA+에 대한 자세한 정보는 enigma-plus 폴더의 README를 확인하십시오.
# Install dependencies
pip install -r requirements.txt

# Install the package
pip install -e .
# Using the CLI
cyber-zero generate \
    --sampled_flags_path task_meta.jsonl \
    --output_path trajectories.jsonl \
    --trajectories_per_task 3 \
    --workers 16

# Using the direct script interface
python generate_trajectory.py \
    --sampled_flags_path task_meta.jsonl \
    --output_path trajectories.jsonl \
    --trajectories_per_task 3 \
    --workers 16
# Using the CLI
cyber-zero evaluate \
    --input_path trajectories.jsonl \
    --output_path quality_results.jsonl \
    --model_id deepseek-v3-0324

# Using the direct script interface
python evaluate_quality.py \
    --input_path trajectories.jsonl \
    --output_path quality_results.jsonl \
    --model_id deepseek-v3-0324
# Using the CLI
cyber-zero reformat \
    --input_path quality_results.jsonl \
    --output_path formatted_trajectories.jsonl \
    --split_output

# Using the direct script interface
python reformat_trajectories.py \
    --input_path quality_results.jsonl \
    --output_path formatted_trajectories.jsonl \
    --split_output
이 프레임워크는 Cyber-Zero의 모듈식 아키텍처를 따릅니다:
cyber_zero/
├── __init__.py                 # Package initialization
├── config.py                   # Configuration management
├── models.py                   # Data models (TaskMeta, TrajectoryData, etc.)
├── utils.py                    # Common utilities
├── validation.py               # Response and command validation
├── llm_client.py               # LLM interaction and quality evaluation
├── trajectory_generator.py     # Main trajectory generation logic
├── quality_evaluator.py        # Quality evaluation for trajectories
├── trajectory_reformatter.py   # Trajectory reformatting for training
├── cli.py                      # Command-line interface
├── prompts/                    # System prompts
│   ├── __init__.py
│   ├── assistant_turn_prompt.txt   # Assistant (CTF player) prompt
│   └── user_turn_prompt.txt        # User (system/environment) prompt
└── data_collection/            # Data collection utilities
    ├── __init__.py             # Package initialization
    ├── config.py               # Data collection configuration
    ├── scraper.py              # Shared web scraping utilities
    └── README.md               # Data collection documentation
이 프레임워크는 중앙 집중식 모델 관리를 갖춘 계층적 구성 시스템을 사용합니다:
from cyber_zero import Config

config = Config()
config.MAX_TURNS = 60  # Maximum conversation turns (30 paired turns)
config.DEFAULT_WORKERS = 16  # Number of parallel workers
이 프레임워크는 litellm을 통해 여러 LLM 제공자를 지원합니다. 기본 모델은 연구 논문에 명시된 대로 DeepSeek-V3-0324입니다:
# Get available models
from cyber_zero.config import Config
config = Config()
print(config.models.MODEL_MAPPINGS)
# {'deepseek-v3-0324': 'deepseek-ai/DeepSeek-V3-0324', ...}

# Use a specific model
model_id = config.models.get_model_id("deepseek-v3-0324")
궤적 생성을 위한 사용자 정의 모델을 추가하려면 cyber_zero/config.py의 모델 매핑을 업데이트하세요:
# In cyber_zero/config.py
@dataclass
class ModelConfig:
    def __post_init__(self):
        if self.MODEL_MAPPINGS is None:
            self.MODEL_MAPPINGS = {
                # Default research model
                "deepseek-v3-0324": "deepseek-ai/DeepSeek-V3-0324",
                # Add your custom models here
                "custom-model": "provider/your-custom-model-id",
                "local-model": "http://localhost:8000/v1/completions",
            }
이 프레임워크는 최적의 궤적 생성을 위해 연구로 검증된 매개변수를 사용합니다:
CTF 작업 메타데이터를 나타냅니다:
task = TaskMeta(
    task_name="Buffer Overflow Basic",
    task_tag="pwn",
    task_points="100",
    task_description="Find the vulnerability...",
    solution="flag{example}",
    # ... other fields
)
대화 기록이 포함된 전체 트래젝토리:
trajectory = TrajectoryData(
    task_name="Example Task",
    trajectory=[
        ConversationTurn(role="user", content="ls -la"),
        ConversationTurn(role="assistant", content="```bash\nls -la\n```"),
        # ... more turns
    ],
    # ... other fields
)
이 프레임워크는 트래젝터리 품질을 보장하기 위한 포괄적인 검증 메커니즘을 포함합니다:






