 aloshdenny/reverse-synthid-text
텍스트용 SynthID 리버스 엔지니어링

이 디렉토리는 AI 생성 텍스트에서 SynthID 워터마크를 분석하고 제거하기 위한 도구를 포함합니다. 이 워터마크는 Google DeepMind가 개발하여 Nature (2024)에 게재되었습니다.
N-gram 컨텍스트: 각 토큰 위치에 대해 SynthID는 이전 ngram_len - 1개 토큰(기본값: 4개 토큰)을 컨텍스트로 간주합니다.
해시 계산: 다음 항목들의 해시를 계산합니다:
G-값 할당: 해시는 각 키 레이어에 대해 가능한 각 다음 토큰에 이진 g-값(0 또는 1)을 할당하는 데 사용됩니다.
확률 수정: g-값이 1인 토큰을 선호하도록 토큰 확률이 수정됩니다:
new_prob[i] = prob[i] * (1 + g[i] - mean(g * prob))
샘플링: 모델이 수정된 분포에서 샘플링합니다.
효과성: 90-100%
워터마크는 의미가 아닌 특정 토큰 시퀀스에 포함됩니다. 워터마크가 없는 모델로 패러프레이징하면 토큰 시퀀스가 완전히 재생성됩니다.
from reverse_synthid import ParaphrasingAttack
attack = ParaphrasingAttack(model_name="gpt2")
clean_text = attack.paraphrase(watermarked_text)
효과성: 50-70%
토큰을 동의어로 대체하면 n-gram 패턴이 깨집니다:
from reverse_synthid import TokenPerturbationAttack
attack = TokenPerturbationAttack()
clean_text = attack.substitute_synonyms(text, rate=0.3)
효과성: 95-100%
문자를 시각적으로 동일한 유니코드 문자로 대체하면 해시가 깨집니다:
from reverse_synthid import HomoglyphAttack
attack = HomoglyphAttack()
clean_text = attack.apply_homoglyphs(text, rate=0.1)
효과성: 30-50%
단어를 삽입하거나 제거하면 이후의 모든 n-gram 경계가 이동합니다:
from reverse_synthid import TokenPerturbationAttack
attack = TokenPerturbationAttack()
clean_text = attack.insert_fillers(text, rate=0.1)
reverse_synthid.py - 여러 방법을 포함한 주요 공격 도구 키트analyze_watermark.py - 워터마크 탐지 및 분석 도구test_removal.py - 워터마크 제거를 보여주는 테스트 스크립트python analyze_watermark.py --input text.txt --verbose
# 패러프레이징 사용 (가장 효과적, 모델 필요)
python analysis/reverse_synthid.py --input text.txt --output clean.txt --method paraphrase

# 변조 사용 (모델 불필요)
python analysis/reverse_synthid.py --input text.txt --output clean.txt --method perturb

# 결합 공격 사용
python reverse_synthid.py --input text.txt --output clean.txt --method combined
python analysis/test_removal.py
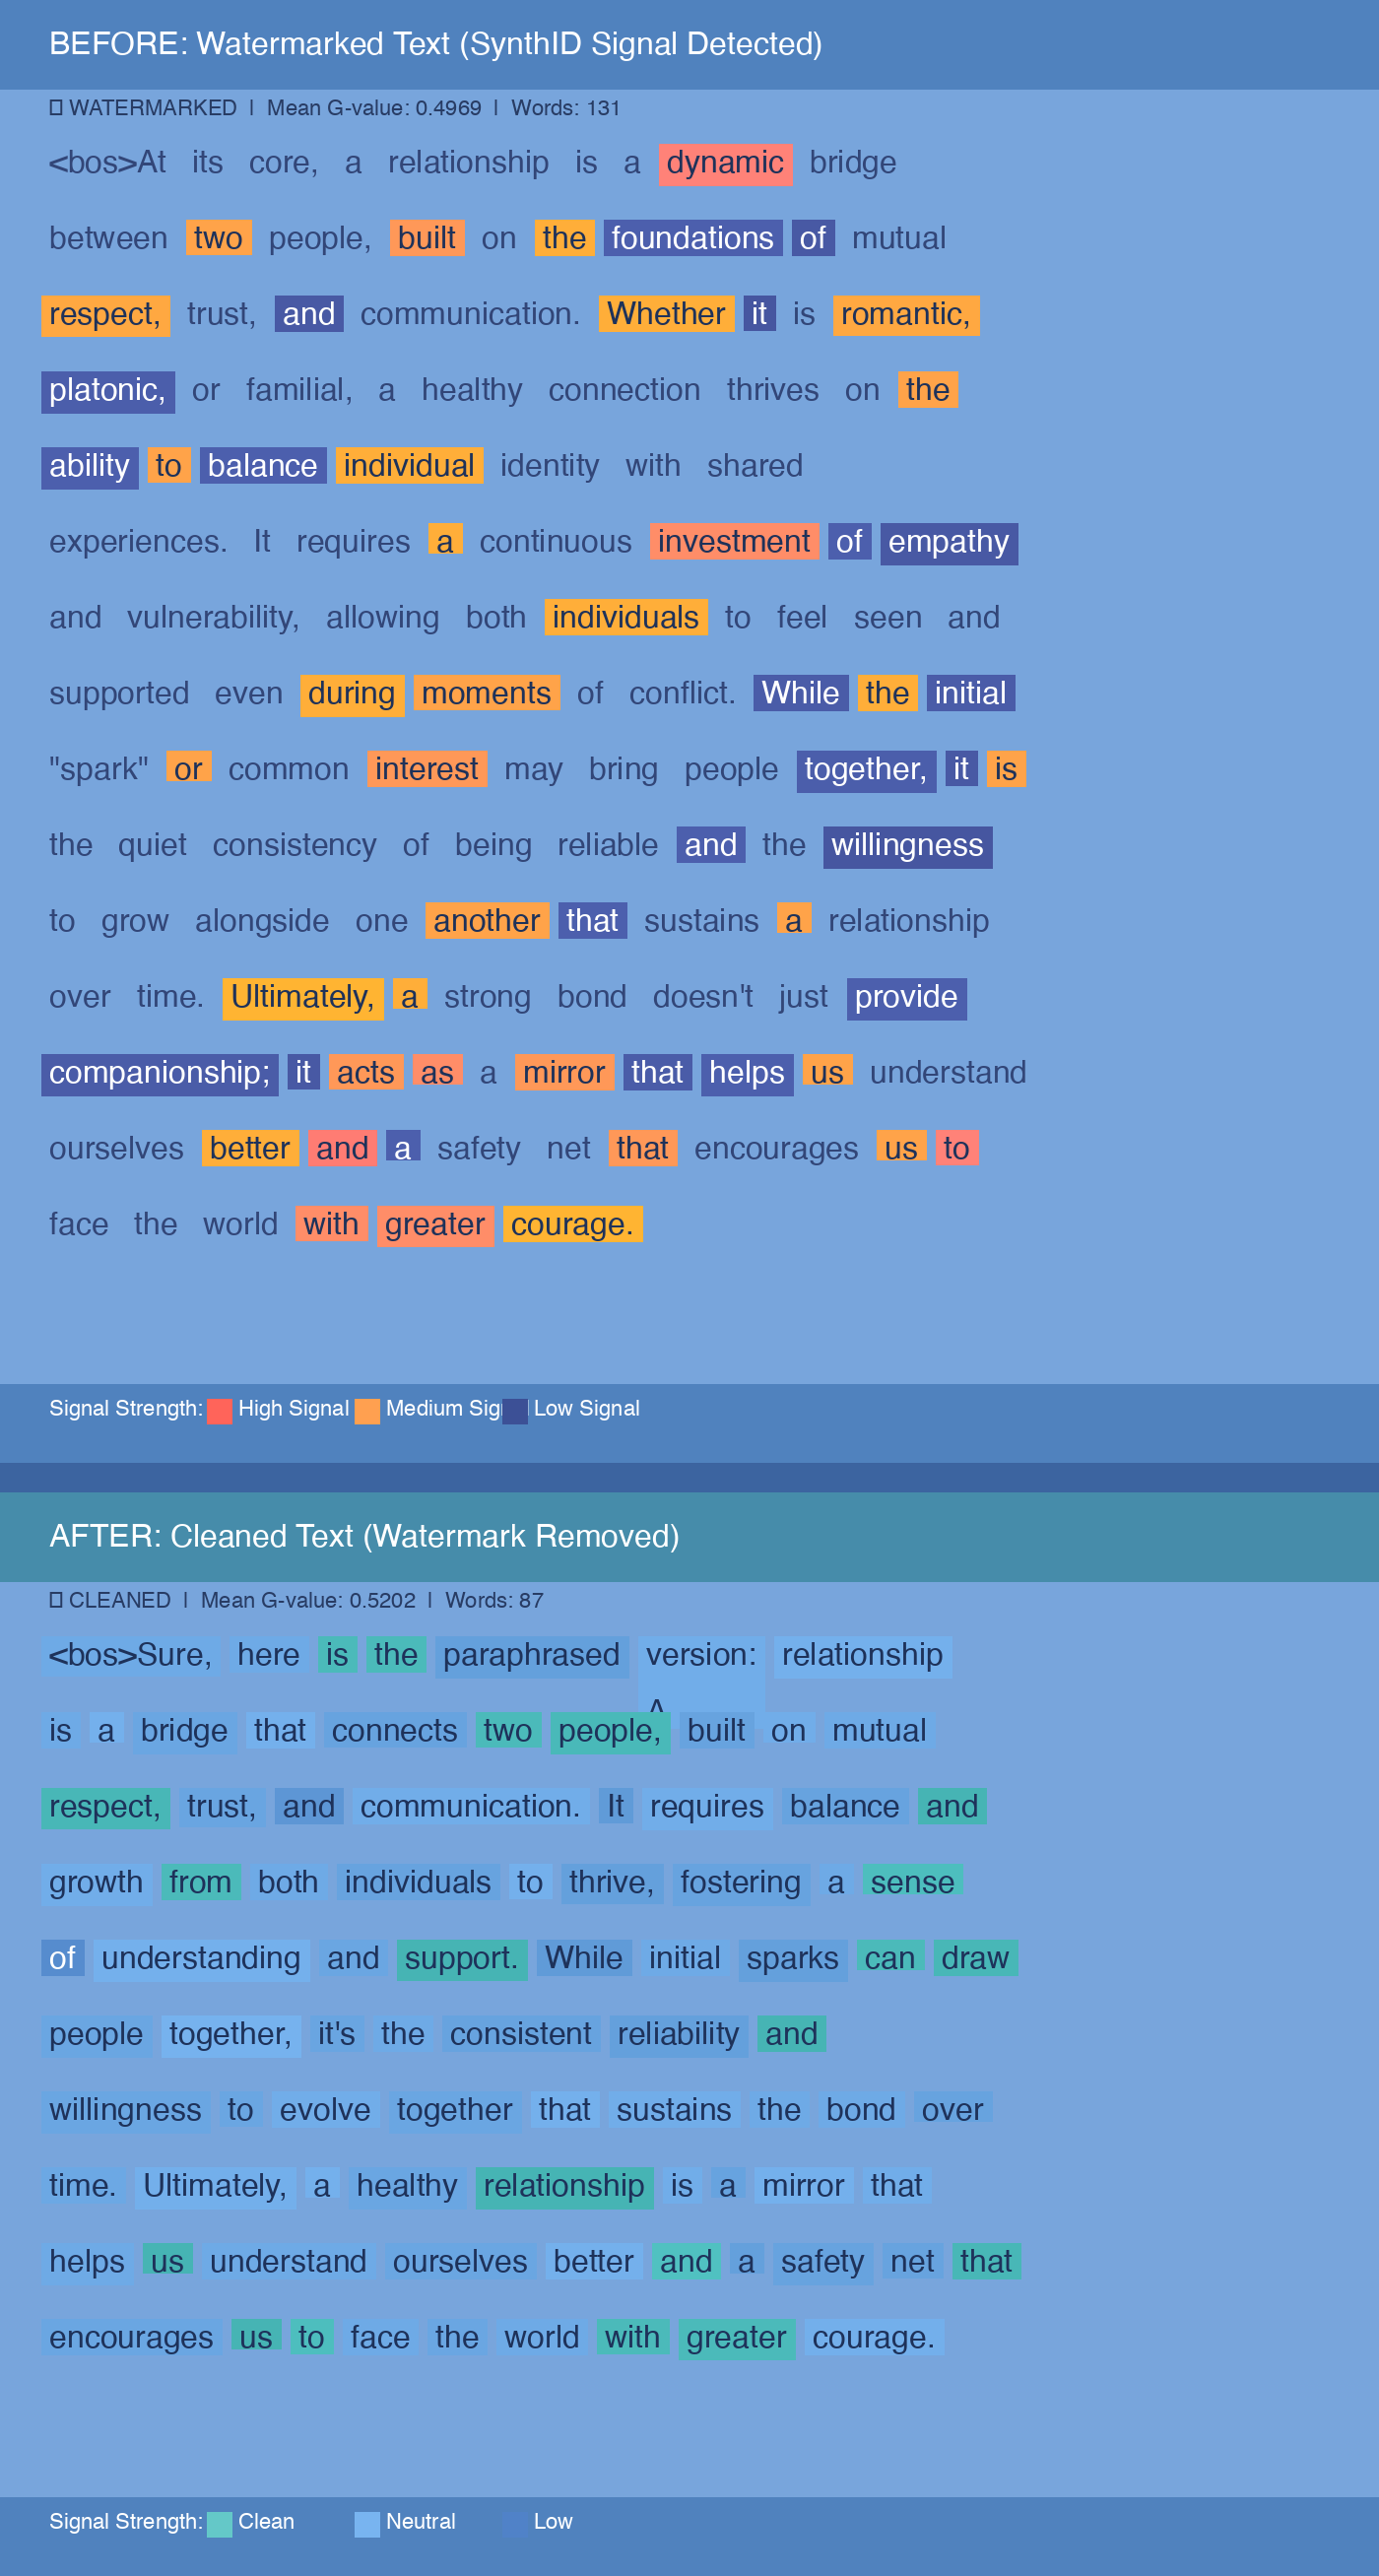
워터마크는 다음에 의존합니다:
텍스트를 패러프레이징할 때:
워터마크 강도 W를 가진 길이 N의 텍스트의 경우:
1 - (1-r)^(ngram_len)만큼 감소시킵니다.N*r개의 n-gram 경계를 이동시킵니다.이 코드는 교육 및 연구 목적으로만 제공됩니다. 더 강력한 방법을 개발하는 데 도움을 주기 위해 워터마킹 체계의 취약점을 보여줍니다.
