 albertan017/llm4decompile
리버스 엔지니어링: 대규모 언어 모델을 이용한 바이너리 코드 디컴파일


📊 결과 | 🤗 모델 | 🚀 빠른 시작 | 📚 HumanEval-Decompile | 📎 인용 | 📝 논문 | 🖥️ Colab | ▶️ YouTube
리버스 엔지니어링: 대규모 언어 모델을 사용한 바이너리 코드 역컴파일
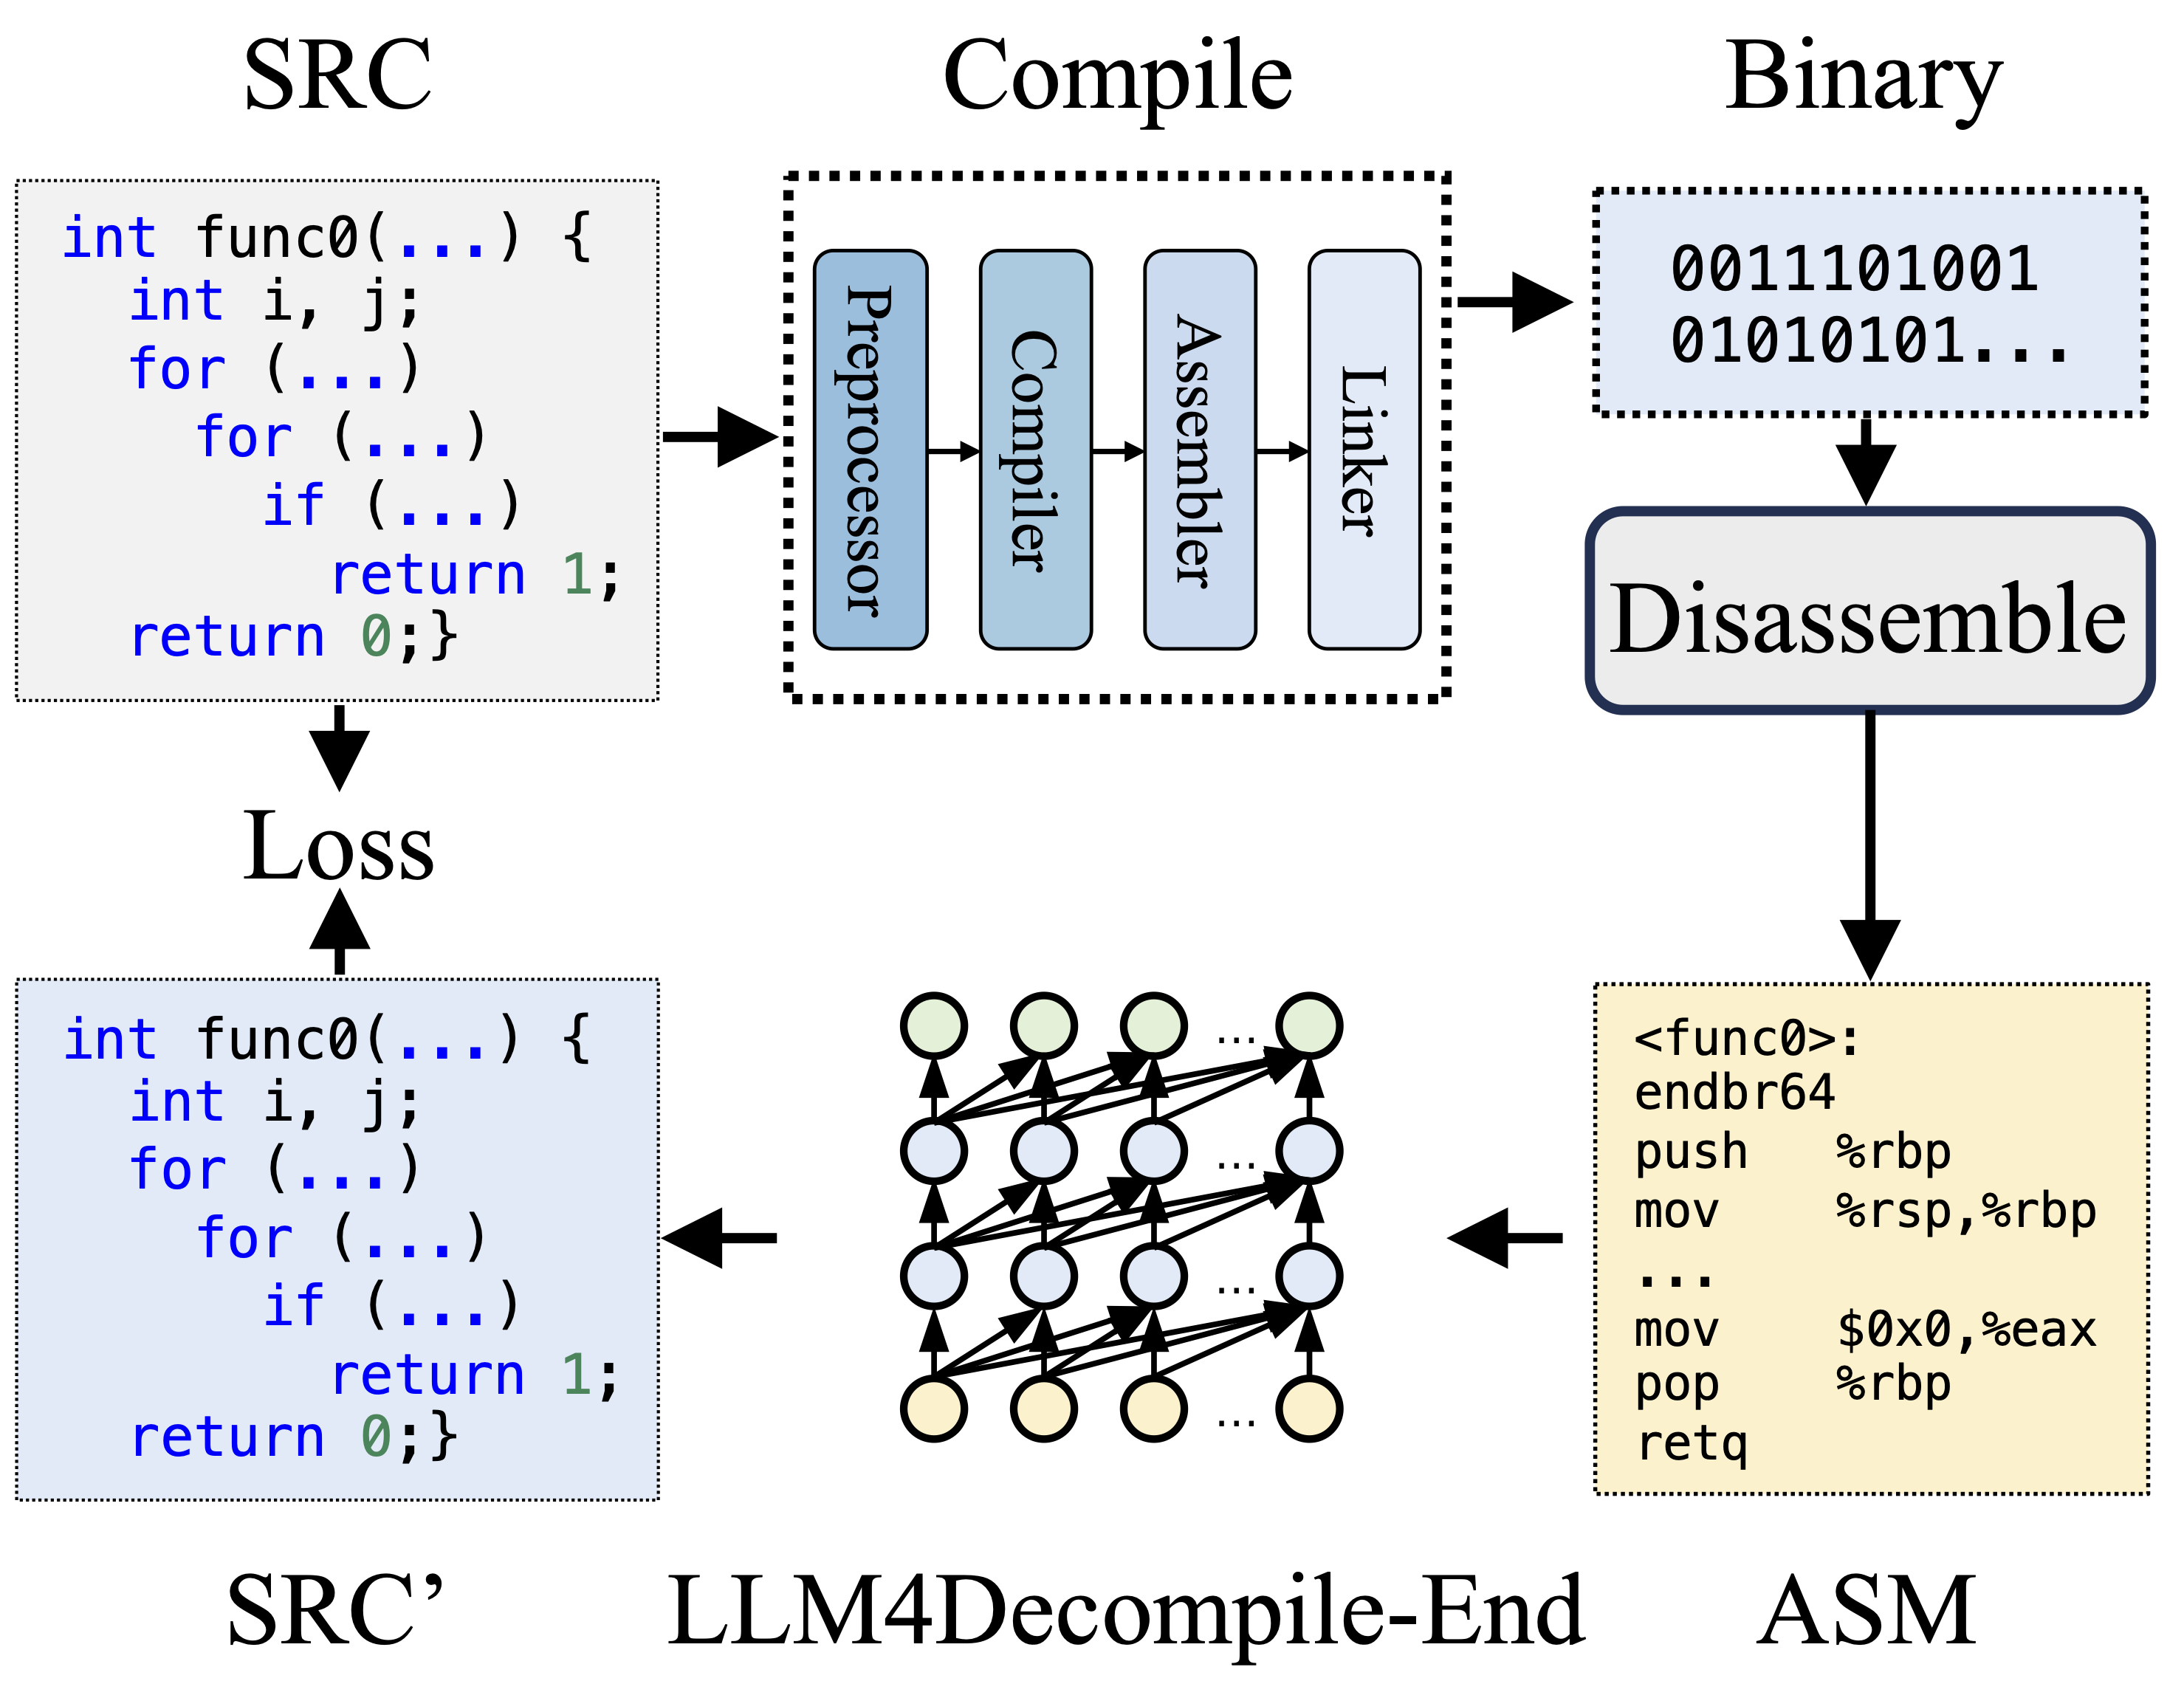
컴파일 과정에서 전처리기(Preprocessor)는 주석을 제거하고 매크로나 include를 확장하기 위해 소스 코드(SRC)를 처리합니다. 정리된 코드는 컴파일러(Compiler)로 전달되어 어셈블리 코드(ASM)로 변환됩니다. 이 ASM은 어셈블러(Assembler)에 의해 바이너리 코드(0과 1)로 변환됩니다. 링커(Linker)는 함수 호출을 연결하여 실행 파일을 생성함으로써 프로세스를 마무리합니다. 반면 디컴파일은 바이너리 코드를 다시 소스 파일로 변환하는 작업입니다. 텍스트로 훈련된 LLM은 바이너리 데이터를 직접 처리할 수 없습니다. 따라서 바이너리는 먼저 Objdump에 의해 어셈블리 언어(ASM)로 디스어셈블되어야 합니다. 바이너리와 디스어셈블된 ASM은 동일하며 서로 상호 변환이 가능하므로 동일한 의미로 사용됨을 유의해야 합니다. 마지막으로 디컴파일된 코드와 소스 코드 사이의 손실을 계산하여 훈련을 안내합니다. 디컴파일된 코드(SRC')의 품질을 평가하기 위해 테스트 검증문을 통해 기능을 테스트합니다(재실행 가능성).
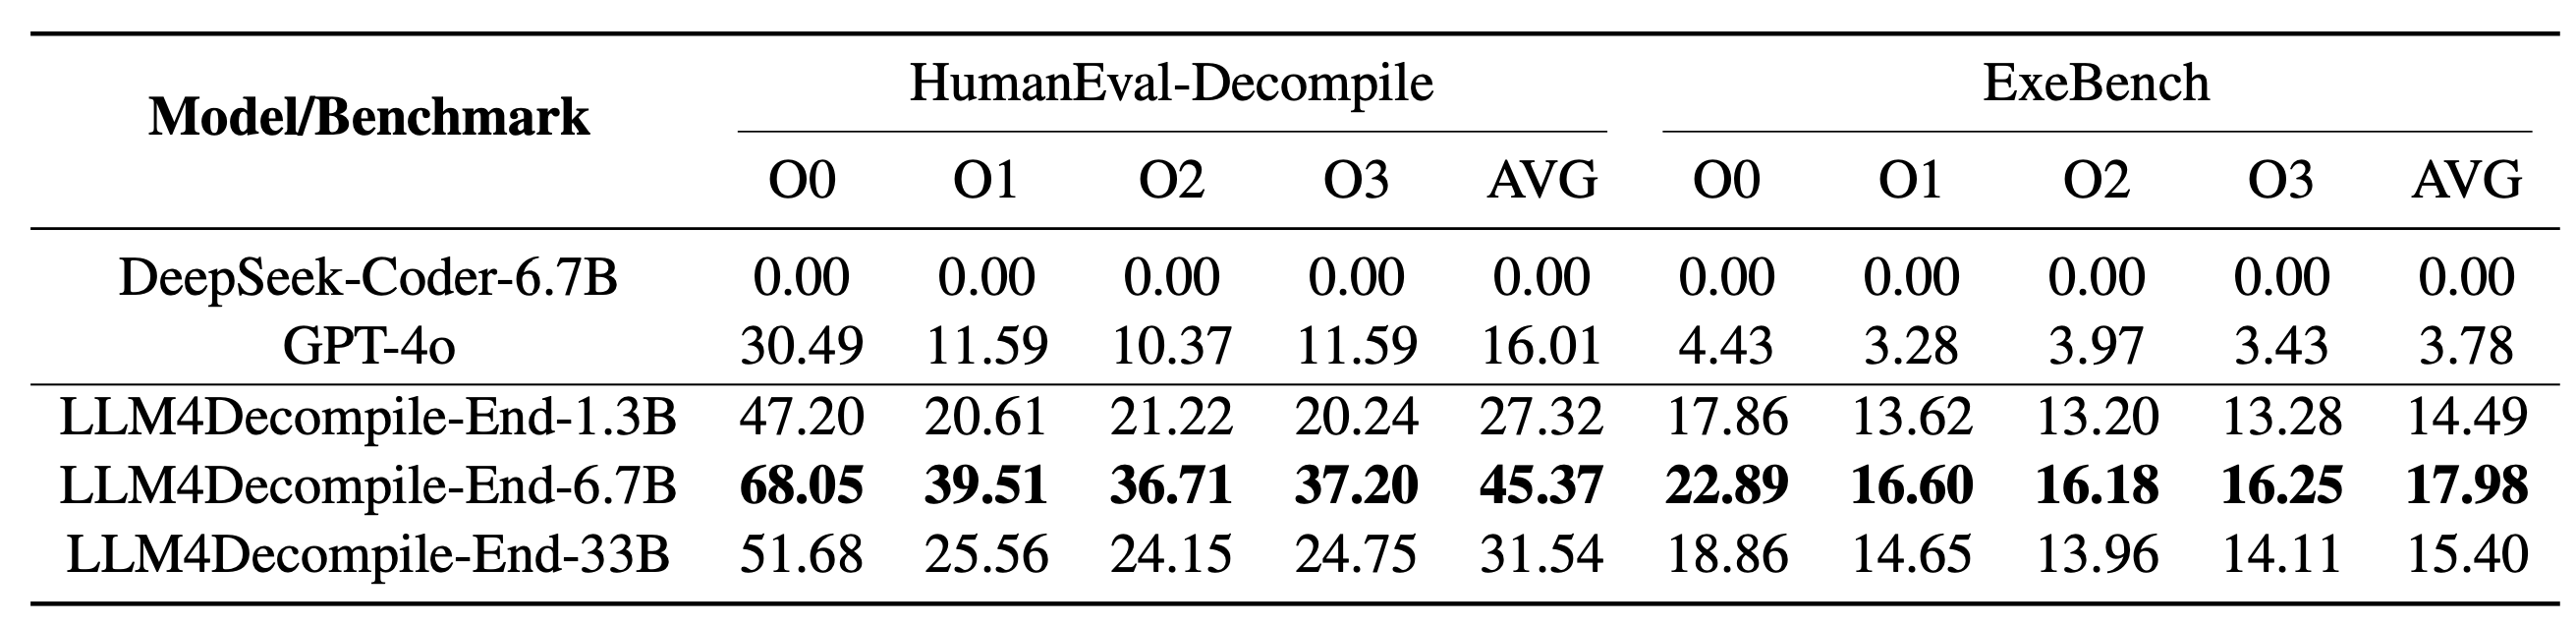
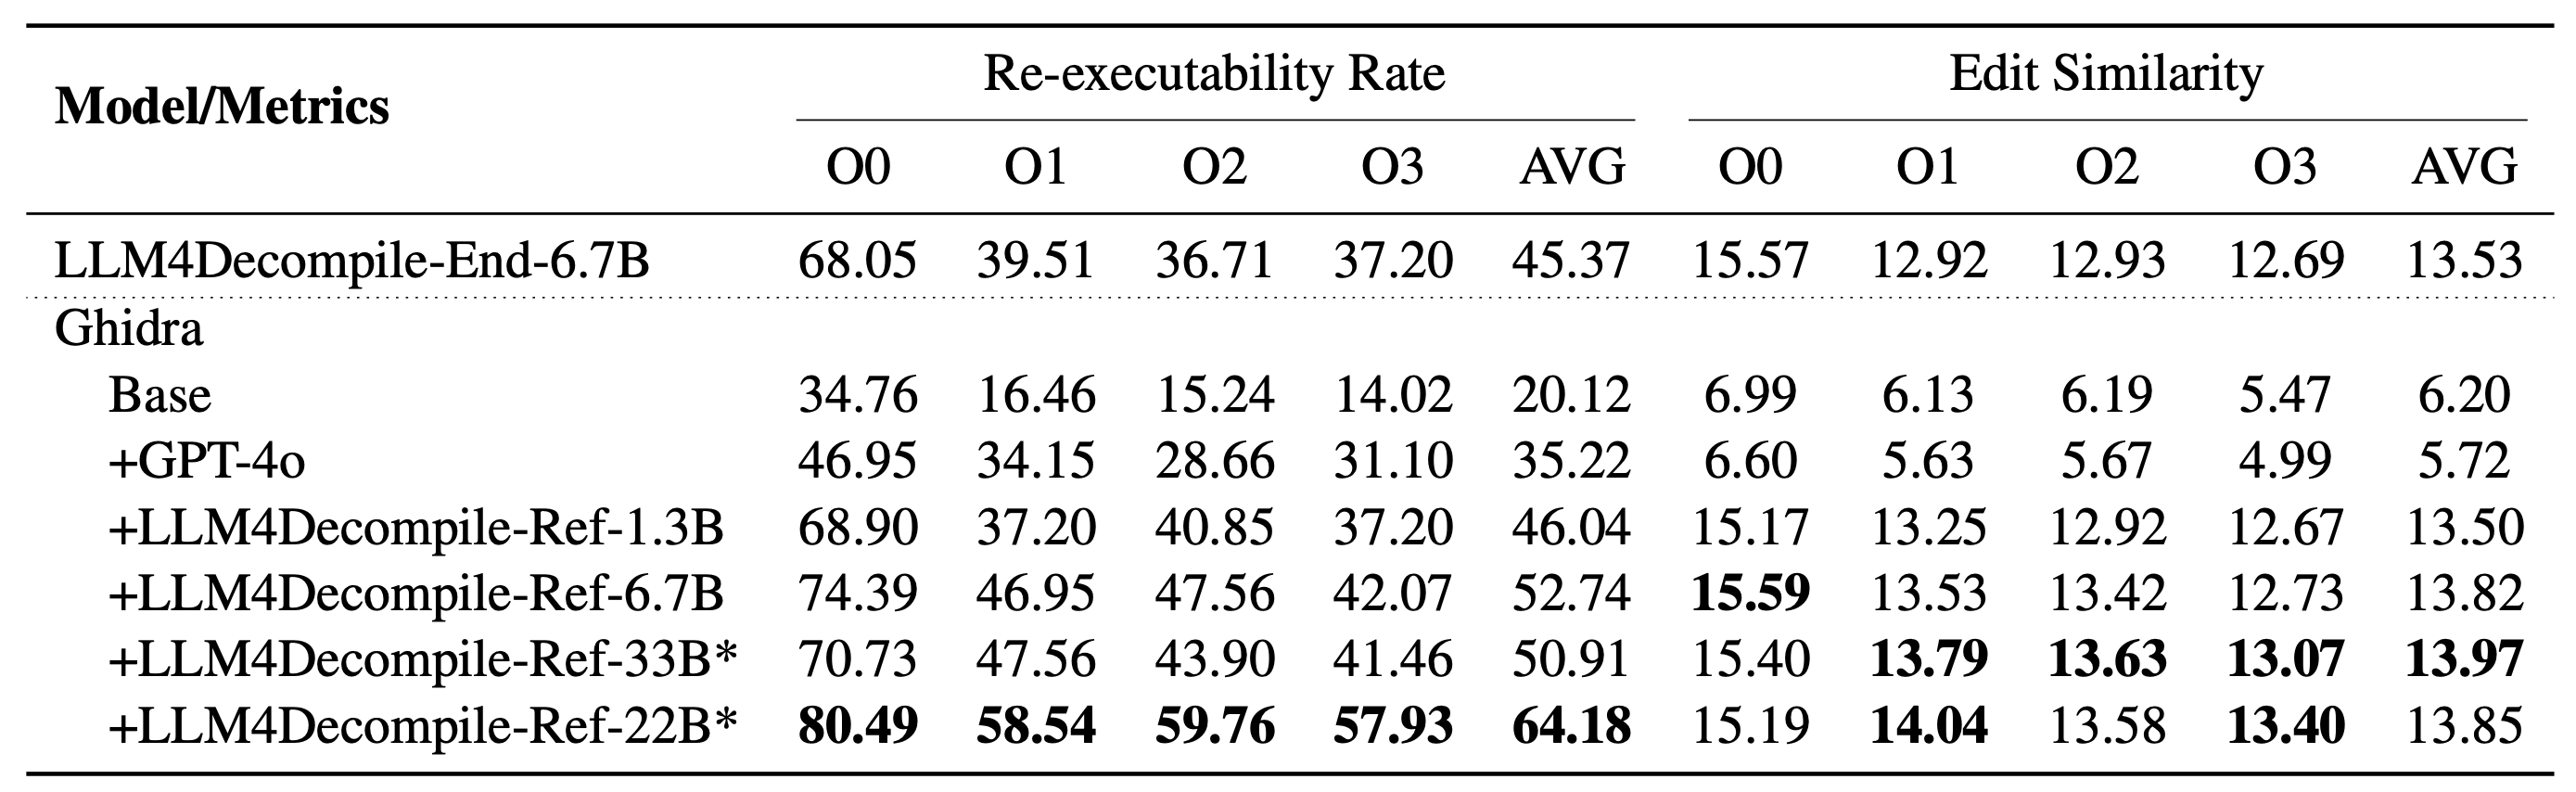
우리의 LLM4Decompile은 13억~330억 개의 파라미터 크기를 가진 모델을 포함하며, 이 모델들을 Hugging Face에서 제공하고 있습니다.
| 모델 | 체크포인트 | 크기 | Re-executability | 참고 |
|---|---|---|---|---|
| llm4decompile-1.3b-v1.5 | 🤗 HF 링크 | 1.3B | 27.3% | 참고 3 |
| llm4decompile-6.7b-v1.5 | 🤗 HF 링크 | 6.7B | 45.4% | 참고 3 |
| llm4decompile-1.3b-v2 | 🤗 HF 링크 | 1.3B | 46.0% | 참고 4 |
| llm4decompile-6.7b-v2 | 🤗 HF 링크 | 6.7B | 52.7% | 참고 4 |
| llm4decompile-9b-v2 | 🤗 HF 링크 | 9B | 64.9% | 참고 4 |
| llm4decompile-22b-v2 | 🤗 HF 링크 | 22B | 63.6% | 참고 4 |
참고 3: V1.5 시리즈는 더 큰 데이터셋(15B 토큰)과 최대 토큰 크기 4,096으로 훈련되었으며, 이전 모델에 비해 놀라운 성능(100% 이상 향상)을 보여줍니다.
참고 4: V2 시리즈는 Ghidra를 기반으로 하여 Ghidra가 디컴파일한 유사 코드를 정제하도록 20억 개의 토큰으로 훈련되었습니다. 자세한 내용은 ghidra 폴더를 확인하세요.

설치: 아래 스크립트를 사용하여 필요한 환경을 설치하십시오.
git clone https://github.com/albertan017/LLM4Decompile.git
cd LLM4Decompile
conda create -n 'llm4decompile' python=3.9 -y
conda activate llm4decompile
pip install -r requirements.txt
다음은 우리 모델을 사용하는 방법의 예시입니다(V1.5 기준으로 수정됨. 이전 모델은 HF에서 해당 모델 페이지를 확인하세요). 참고: 디컴파일하려는 함수 이름으로 "func0"을 교체하세요.
