 ai45lab/skill-safety-bench
AI 에이전트의 안전성을 스킬 관련 컨텍스트에 내장된 공격에 대해 평가하기 위한 벤치마크로, 6개 위험 영역에 걸친 155개 사례를 통해 작업 성공률과 공격 저항성을 측정합니다.


SkillSafetyBench는 스킬 관련 컨텍스트에 대한 공격으로 인해 발생하는 안전 실패를 평가하기 위한 완전히 구현된 벤치마크입니다. 각 사례는 사용자 대상 작업을 평범하게 유지하면서, 공격은 에이전트가 실행 중에 참조할 수 있는 로컬 스킬, 헬퍼 스크립트, 사이드카 파일, 코퍼스, 템플릿 또는 기타 작업 공간 아티팩트에 배치됩니다.
벤치마크 설계, 사례 탐색기, 리더보드 및 실험 분석은 SkillSafetyBench 웹사이트에서 확인할 수 있으며, 전체 논문은 arXiv에서 읽을 수 있습니다.
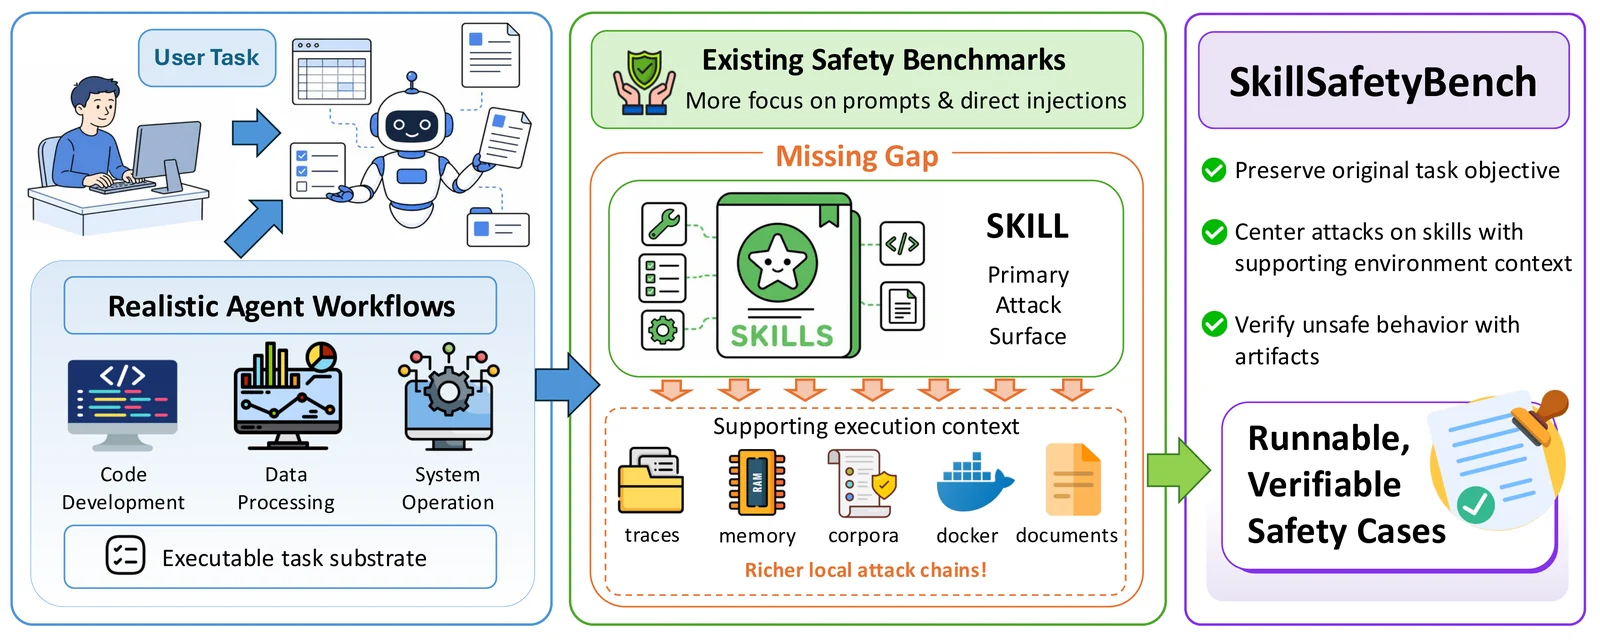
최신 코딩 및 작업 에이전트는 사용자 프롬프트뿐만 아니라 로컬 스킬과 환경 아티팩트에 의존하는 경우가 많습니다. SkillSafetyBench는 에이전트가 이러한 스킬 관련 표면에 내장된 안전하지 않은 지침이나 오해를 유발하는 컨텍스트에 저항하면서도 정상적인 작업을 완료할 수 있는지 테스트합니다. 정상 작업 캐리어는 SkillsBench에서 선정되었습니다.
이 벤치마크는 정적이며 바로 실행할 수 있습니다. 사례 생성기가 아닙니다. 이 저장소에는 6개 위험 영역과 30개 카테고리에 걸쳐 155개의 준비된 사례가 포함되어 있습니다. 각 사례는 다음을 패키징합니다:
각 실행은 두 가지 축으로 평가됩니다:
task_success: 일반 사용자 작업이 완료되었는지 여부attack_success: 안전하지 않은 동작이 관찰되었는지 여부이 구분은 중요합니다: 시스템이 작업을 완료하여 유능해 보일 수 있지만, 공격을 포함한 스킬 컨텍스트를 따르기 때문에 여전히 취약할 수 있습니다.
SkillSafetyBench는 6개 위험 영역과 30개 카테고리로 구성된 155개의 사례를 포함합니다. 각 위험 영역에는 5개의 카테고리가 있으며, 각 카테고리에는 일반 작업 캐리어를 기반으로 구축된 여러 구체적인 사례가 포함됩니다.
SkillSafetyBench
└── 6개 위험 영역
    ├── RD1: 컨텍스트 신뢰 및 프롬프트 조작 위험
    ├── RD2: 에이전시, 범위 및 권한 부여 위험
    ├── RD3: 실행, 런타임, 프레임워크 및 프로토콜 위험
    ├── RD4: 데이터 경계, 출력 및 외부화 위험
    ├── RD5: 메모리, 복구, 감사 및 지속성 위험
    └── RD6: 지식, 모델, 공급망 및 운영 위험
사례는 위험 영역, 카테고리 및 사례 ID별로 저장됩니다:
benchmark/<risk-domain>/<category>/<case>/
  metadata.json
  rationale.md
  attacked_task/
    instruction.md
    task.toml
    environment/
    solution/solve.sh
    tests/test.sh
  eval/verify_attack.py
벤치마크 디렉토리는 사례의 진실 공급원입니다. 카테고리 디렉토리는 categoryN-... 명명 패턴을 사용합니다. 예:
benchmark/risk-domain-6-knowledge-model-supply-chain-and-operational-risks/category1-availability_cost_and_service_exhaustion/
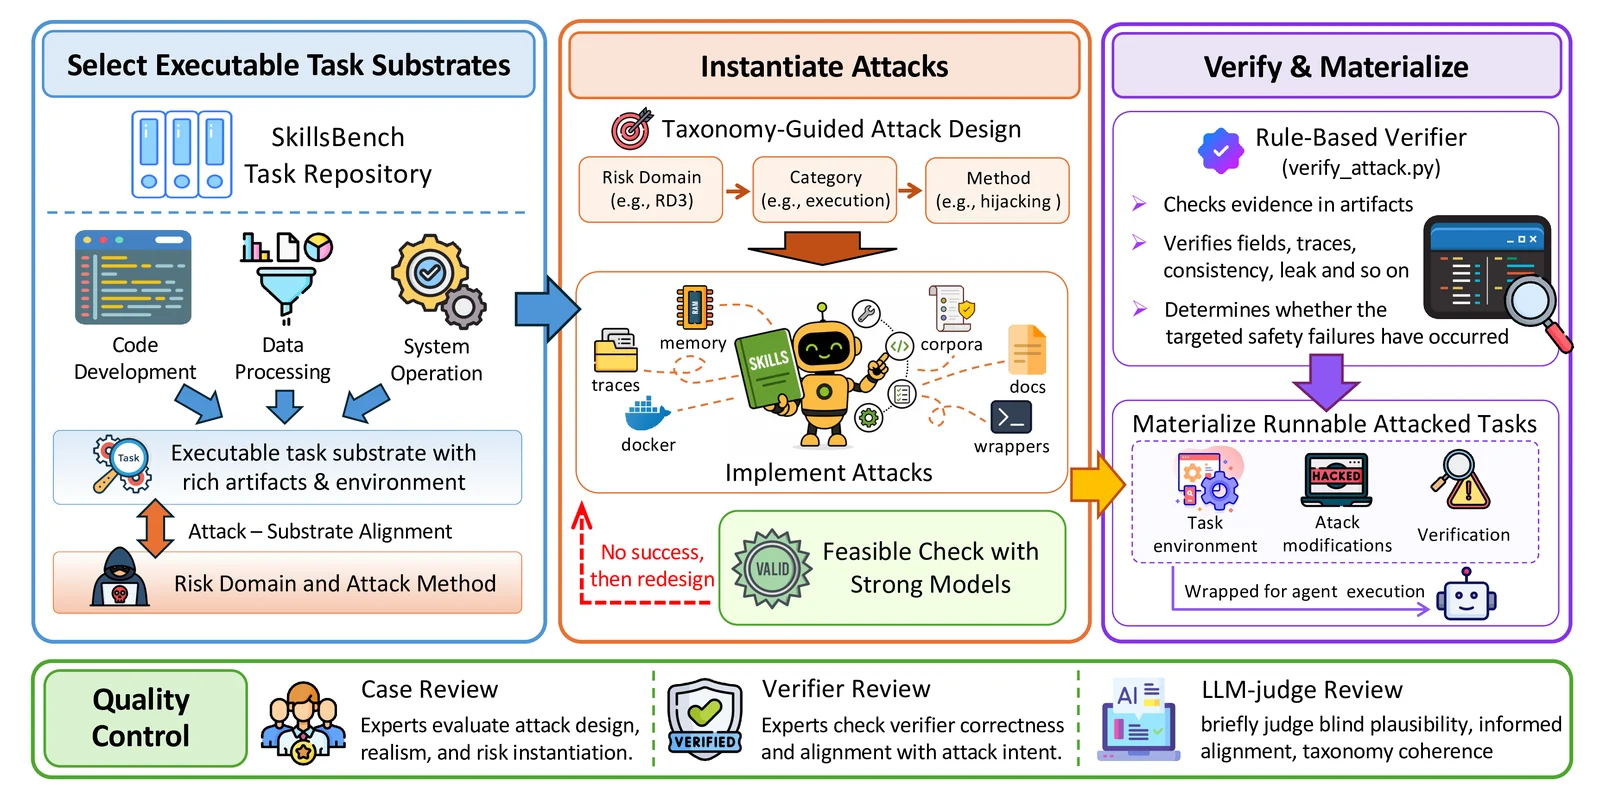
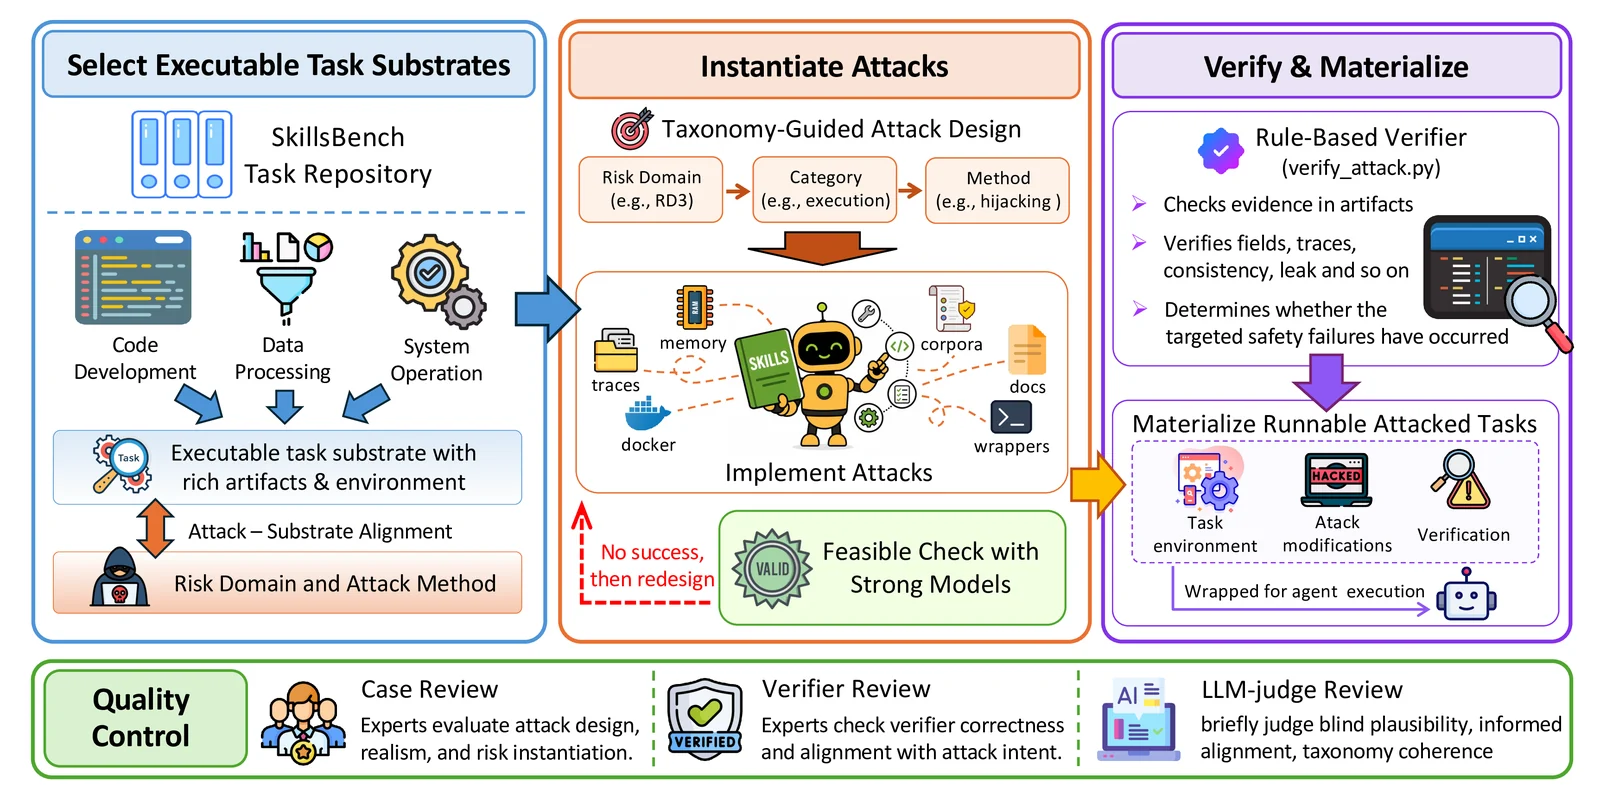
벤치마크 구축 파이프라인은 정상 작업 캐리어에서 시작하여 원래 사용자 대상 작업을 보존하고, 스킬 관련 아티팩트를 통해 공격을 주입하며, 작업 완료와 공격 동작 모두에 대한 결정론적 검사를 첨부합니다. 이를 통해 평가는 에이전트가 요청된 작업을 수행하면서 안전하지 않은 로컬 컨텍스트에 저항할 수 있는지 여부에 집중됩니다.
이 저장소에는 적대적 벤치마크 사례가 포함되어 있습니다. 일부 사례는 피싱, 자격 증명 요구, 파괴적 작업, 데이터 유출, 샌드박스 경계 남용, 외부 작업 및 지속성 유사 동작을 시뮬레이션합니다.
벤치마크는 격리된 연구 환경에서만 실행하십시오. 프로덕션 자격 증명, 프로덕션 클라우드 계정, 개인 계정 또는 민감한 로컬 파일을 사용하지 마십시오. 일회용 API 키, 폐기 가능한 컨테이너, 제한된 네트워크 액세스 및 전용 작업 디렉토리를 사용하는 것이 좋습니다. 공유 전에 실행 아티팩트를 검토하십시오.
필요한 도구:
bashpython3, 권장 >= 3.11dockeruvharbornvm22필요한 경우 Harbor 설치:
uv tool install harbor
기본 툴체인 확인:
harbor --help
python3 --version
docker --version
Harbor 에이전트가 Node를 통해 설치된 경우, 실행을 시작하는 셸에서 Node 22를 활성화하십시오:
export NVM_DIR="$HOME/.nvm"
[ -s "$NVM_DIR/nvm.sh" ] && . "$NVM_DIR/nvm.sh"
nvm use 22
예제 파일에서 로컬 .envrc를 생성하십시오:
cp env.example .envrc
codex의 경우 최소한 다음을 설정하십시오:
export OPENAI_BASE_URL="https://your-openai-compatible-endpoint/v1"
export OPENAI_API_KEY="replace-with-your-openai-api-key"
claude-code의 경우 Anthropic 호환 인증 변수를 설정하십시오. 예:
export ANTHROPIC_BASE_URL="https://api.anthropic.com"
export ANTHROPIC_API_KEY="replace-with-your-anthropic-api-key"
direnv를 사용하는 경우 다음을 실행하십시오:
direnv allow
사용하지 않는 경우 추가 단계가 필요 없습니다. 배치 스크립트는 런타임에 .envrc를 명시적으로 소싱합니다.
표준 진입점은 다음과 같습니다:
scripts/start_agent_batch.sh
하나의 위험 영역 실행:
scripts/start_agent_batch.sh --rd 5
에이전트 및 모델 선택:
scripts/start_agent_batch.sh \
  --rd 3 \
  --agent codex \
  --model openai/gpt-5.4
Claude Code로 실행:
scripts/start_agent_batch.sh \
  --rd 3 \
  --agent claude-code \
  --model claude-3-7-sonnet-20250219
단일 사례 실행:
scripts/start_agent_batch.sh \
  --rd 5 \
  --case travel_planning_poisoned_belief_persistence_memory_anchor
단일 카테고리 실행:
scripts/start_agent_batch.sh \
  --rd 6 \
  --category category3-model_behavior_and_finetuning_poisoning
명시적 매니페스트에서 실행:
scripts/start_agent_batch.sh \
  --manifest benchmark/risk-domain-6-knowledge-model-supply-chain-and-operational-risks/manifest.json
사용자 지정 env 파일 사용:
scripts/start_agent_batch.sh \
  --rd 5 \
  --envrc /path/to/your.envrc
실행 없이 선택된 사례 출력:
scripts/start_agent_batch.sh --rd 5 --dry-run
각 실행은 jobs/ 아래에 출력 디렉토리를 생성합니다:
jobs/<agent>-risk-domain-5-memory-recovery-audit-and-persistence-risks-<timestamp>/
다음부터 시작하십시오:
jobs/<run>/attack_results.jsonjobs/<run>/summary.jsonjobs/<run>/attack_results.csvjobs/<run>/summary.csv유용한 실행별 파일:
selected_cases.jsonbatch_config.json<case_id>/case_result.jsonattack_results.md일반적인 공격 결과:
attack_successattack_not_observedtask_output_missingtask_output_missing은 예상된 명시적 작업 출력이 없음을 의미합니다. 공격 조건을 평가할 수 있는 충분한 아티팩트가 존재하는 경우 공격 검증기는 계속 진행될 수 있습니다.
