
gitgalaxy — Updated!
AST 없는 휴리스틱 지식 그래프 엔진으로, 심층 저장소 인텔리전스와 제로 트러스트 보안 스캐닝을 제공합니다. GitLab CI/CD 컴포넌트로 통합되어 악성 코드를 차단하고 SARIF 텔레메트리를 GitLab 보안 대시보드로 내보냅니다.
GitGalaxy
컴파일 없이 저장소 규모의 구조적 인텔리전스.
Docs · Visualizer · Language Crucible · Keyword Rosetta · Raw Output
1회 스캔 · 97개 구조적 신호 · 50개 이상 언어 · 컴파일 없음 · 17개 위험 노출 카테고리 · 6개 출력
요약
GitGalaxy는 소스 텍스트로부터 직접 저장소 전체의 언어 독립적 구조 그래프를 구축합니다 — 빌드도, 언어별 툴체인도 필요하지 않습니다.
이는 다국어(polyglot)이거나, 부분적으로 손상되었거나, 레거시이거나, 벤더 코드가 많거나, 그 밖에 빌드 우선 워크플로로 분석하기 어려운 저장소를 위해 설계되었습니다:``` text Go + C++ + Python + Java + Bash + YAML
- generated code + vendored code + legacy code
- half-migrated modules + broken dependencies
언어별로 별도의 파서를 두는 대신, GitGalaxy는 **구조적 시그니처** — 함수, 클래스, 인자, 제어 흐름, 상태 변경, I/O, API, 의존성 — 라는 공통 어휘를 추출하고, 이를 하나의 결정론적 저장소 모델로 정규화하여 아키텍처 분석, 위험 노출 우선순위 지정, SBOM 생성, 리팩터링 및 소유권 분석, AI 지향 코드베이스 컨텍스트, CI/CD 게이트에 공급합니다.

> **핵심 명제:** 저장소 규모에서 매우 유용한 구조 정보를 복원하는 데 항상 완전한 언어 파싱이 필요한 것은 아닙니다.

이 명제가 어떻게 검증되는지 — Tree-sitter와 Ctags를 대상으로, 심어 놓은 대조 코퍼스를 대상으로, 그리고 다음으로 Git 이력을 대상으로 — 는 아래의 [정확도, 측정됨](#accuracy-measured)에 요약되어 있으며 [검증 프로그램](https://gitlab.com/squid-protocol1/gitgalaxy/-/blob/main/docs/validation.md)에 전체가 설명되어 있습니다.

------------------------------------------------------------------------

## 스캔으로 얻는 것

명령 하나:``` bash
pip install gitgalaxy
galaxyscope path/to/repo
동일한 결정론적 스캔에 대한 여섯 개의 조정된 뷰:
| 출력 | 목적 |
|---|---|
| LLM 아키텍처 브리프 | 압축된 기계/에이전트 지향 컨텍스트 (아래) |
| SARIF | CI/보안 대시보드 통합 |
| CycloneDX SBOM | 의존성 인벤토리/컴플라이언스 |
| SQLite | 쿼리 가능한 저장소 지식 그래프 |
| JSON 감사 데이터 | 포렌식/자동화 워크플로 |
| 3D 시각화 데이터 | 대화형 저장소 토폴로지 |
아키텍처 브리프
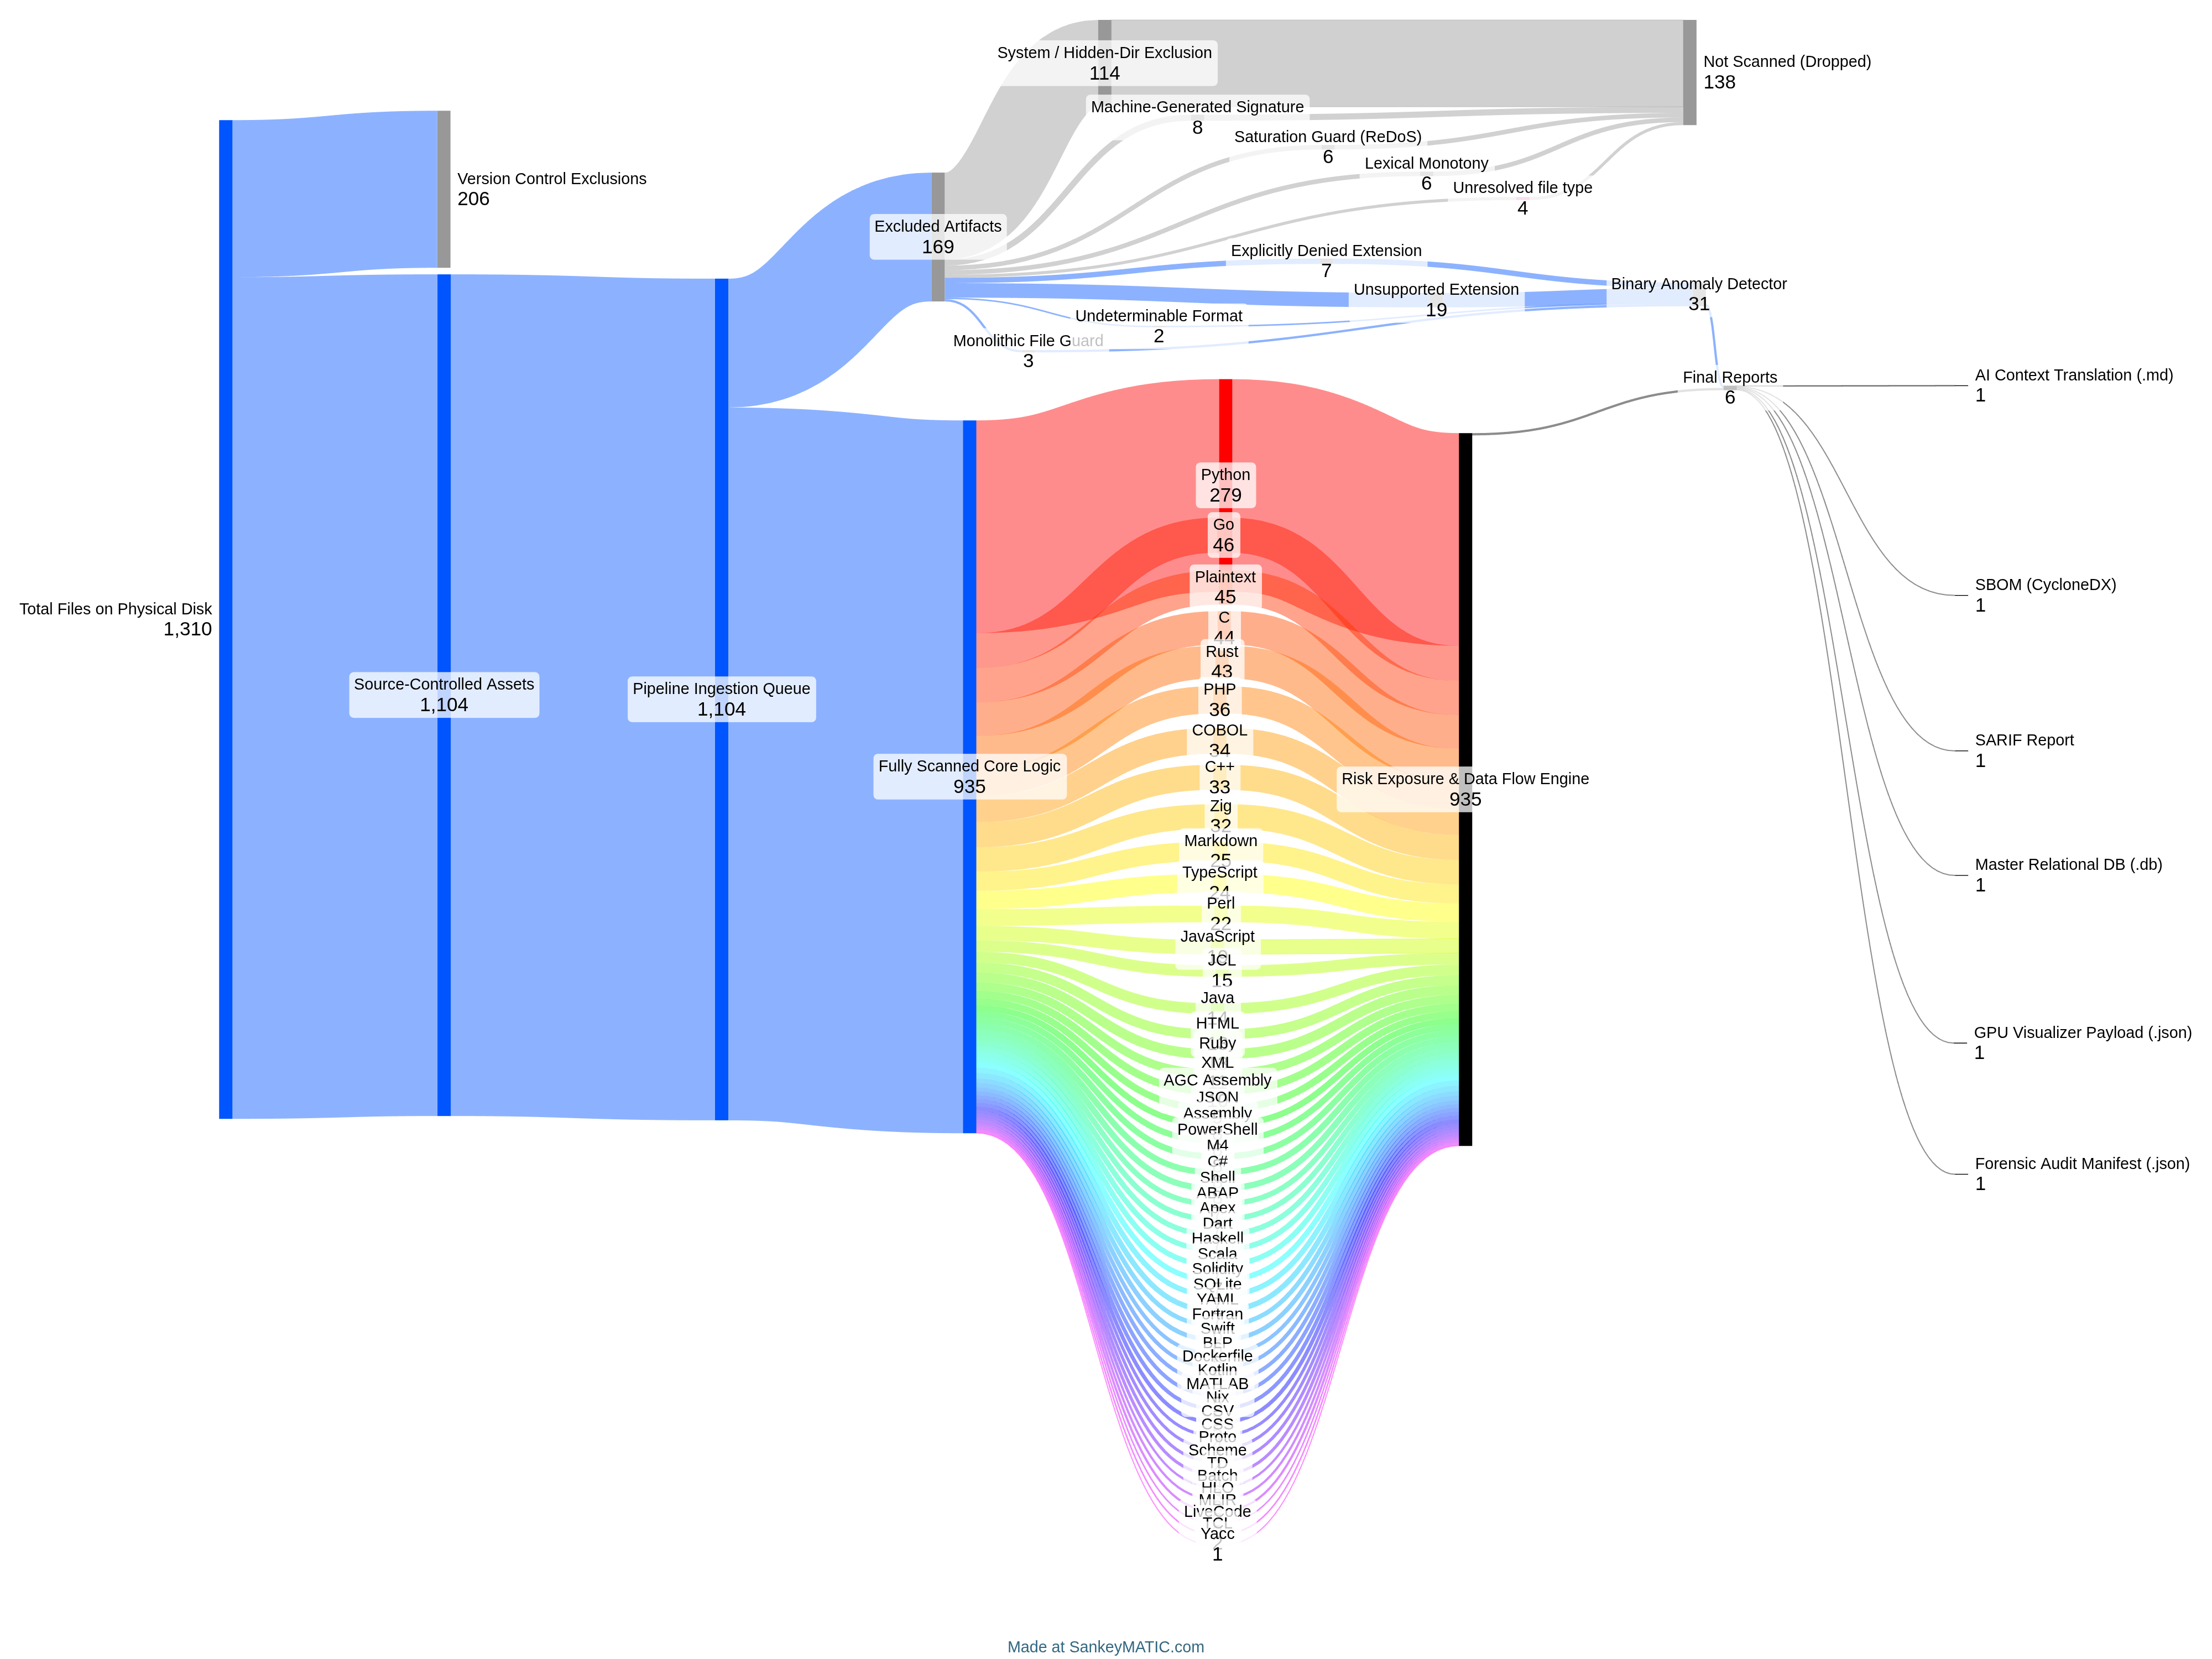
플래그십 보고서는 엔지니어 — 또는 AI 에이전트 — 에게 한 번도 본 적 없는 저장소에 대한 실질적인 멘탈 모델을 넘겨주기 위해 만들어진 단일 Markdown 브리프입니다. 이는 자체 완결형 패키지입니다: 위험 방정식이 보고서 자체에 인쇄되어 있고, 내장된 해석 프롬프트를 통해 어떤 LLM이든 숫자가 의미하는 바를 환각 없이 서술할 수 있습니다. 섹션은 매크로 상태와 언어 구성, 네트워크 토폴로지(모듈성, 단절점, 순환 밀도), 의존성 병목 지점, 가장 무거운 함수와 파일, PageRank 블라스트 반경이 포함된 파일별 구조적 시그니처, 표적 및 누적 위험 히트리스트, 공급망 감사, 그리고 변동성과 작성 집중도로 순위가 매겨진 리팩터링 대상 — 에 더해 스캔을 거부한 모든 파일의 항목별 목록과 그 이유를 다룹니다.
현재 엔진으로 2026-08-31에 스캔한 두 가지 예시입니다. 두 저장소 모두
공개되어 있습니다 — 어느 것이든 클론하고 galaxyscope --llm-only <path>를
실행하면 전체 브리프를 재현할 수 있습니다:
curl — 4,250개 아티팩트, 696개 스캔, C, Perl, Python, Shell, M4 및
Makefile에 걸쳐 112,653 LOC. 브리프는 src/tool_setup.h를 최상위 구조적
기둥(80개의 인바운드 연결)으로 순위를 매기고, Perl 함수 —
tests/ftpserver.pl의 APPEND_imap, Impact 2135, 1,672 LOC — 를 C 코드와
동일한 순위의 저장소 전체 함수 히트리스트 최상위에 올립니다. 이 교차 언어
그래프가 바로 이 제품입니다: 저장소의 모든 언어에 걸친 하나의 비교 가능한
신호 집합. 같은 브리프에 있는 솔직한 단서: 아티팩트의 16.4%만 스캔되었습니다
— 수집 필터가 바이너리, 생성된 코드 및 테스트 데이터를 공격적으로 제거하며,
브리프의 §5는 확장자와 이유별로 모든 제외 항목을 항목화합니다.
cics-genapp (IBM의 CICS COBOL/DB2 샘플) — 92.1% 스캔: 44개의 COBOL
프로그램, 29개의 JCL 작업. 누적 구조적 표면 히트리스트는
base/src/lgupdb01.cbl(변이 표면 ~100%, 복잡도 부하 92%)로 시작하며,
저장소에서 가장 무거운 단락은 UPDATE-POLICY-DB2-INFO — SELECT FOR UPDATE
행 잠금 로직으로, 이는 해당 프로그램의 유지보수자가 가장 먼저 살펴보고
싶어할 바로 그 지점입니다. 같은 브리프는 또한 한계를 명확히 보여줍니다:
실제 임포트 그래프가 없는 평평한 아키텍처에서는 "구조적 기둥" 목록이
제로 연결 파일로 퇴화하며, 보고서는 이를 신뢰하기 전에 연결 수를 확인하라고
말합니다.
독립적으로 선별된 저장소에 대한 수백 개의 편집되지 않은 브리프가
gitgalaxy-raw-output에
커밋되어 있습니다; 이 저장소 자체의 항상 최신인 자체 스캔 브리프는
docs/gitgalaxy_architecture_brief.md에
있습니다.
하나의 그래프, 많은 소비자
| 소비자 | 질문 |
|---|---|
| 아키텍처 | 이 저장소는 무엇으로 구성되어 있는가? |
| 구조적 분석 | 함수, 클래스, API, 의존성 및 제어 구조는 어디에 있는가? |
| 구조적 표면 프로파일 (이전의 위험 노출) | 주어진 구조적/내용 패턴이 어디에 집중되어 있는가? |
| 리팩터링 | 어떤 파일이 복잡하거나, 변경이 잦거나, 부하를 지탱하는가? |
| 공급망 | 디스크에 물리적으로 존재하는 의존성은 무엇인가? |
| AI 컨텍스트 | 에이전트가 알아야 할 아키텍처와 관계는 무엇인가? |
| 레거시 마이그레이션 | 변환해야 할 구조적 단위는 어디에 있는가? |
| 이력 분석 | 저장소가 진화함에 따라 측정된 노출은 어떻게 변하는가? |
정확도, 측정된 것
위의 주장을 뒷받침하는 두 가지 상시 측정 프로그램이 있습니다. 전체 서술 — 방법론, 판정, 한계, 그리고 다음 단계 — 은 검증 프로그램에 있습니다; 이것은 요약입니다.
구조적 검증: GitGalaxy vs Tree-sitter vs Ctags
GitGalaxy는 고정된 Language Crucible 코퍼스에서 Tree-sitter 및 Universal Ctags와 벤치마크됩니다 — 45개 언어 중 24개가 세 도구 모두로, 13개가 두 도구로 처리되며, 모든 불일치는 실제 소스와 대조하여 조사되고 판정과 함께 기록됩니다(201개의 기록된 불일치 형태 중 200개 검증됨). 해당 코퍼스에서 GitGalaxy의 검증된 함수 정밀도는 tree-sitter와 비교 가능한 31개 언어 전체에서 100%이며, 검증된 클래스 또는 인수 불일치에서 잘못된 것으로 판명된 도구가 결코 아닙니다. 한계: 세 가지 구조적 대상, 하나의 고정 코퍼스 — 일반적으로 "AST만큼 정확하게 파싱한다"는 것이 아닙니다.

교차 언어 일관성: Keyword Rosetta 대조 코퍼스
더 새로운 프로그램은 반대 질문을 던집니다: GitGalaxy가 모든 언어에서
동일한 의도를 동일하게 측정하는가?
keyword-rosetta 코퍼스는
동일한 12-프로브 프로그램을 정확히 알려진 신호 수와 함께 지원되는 50개
언어 모두에 심습니다 — 따라서 어떤 차이든 구조적으로 측정된 언어 편향입니다.
차트는 각 편차를 크기가 아닌 원인별로 색칠합니다: 빨강은 열린 엔진 결함
(잘못된 구문에 일치하는 규칙, 또는 카운트 내부에 있는 스코어링 가중치);
회색은 원장이 검증한 문서화된 변이 — 언어가 구문을 표현할 수 없음, 의도적인
스코어링 선택, 또는 다른 행의 에코입니다. 현재 답변: 평균적으로 94%의
언어가 게이트된 메트릭당 교차 언어 중앙값의 ±25% 이내에 위치하며(56개의
차트화 가능한 메트릭, 54개가 ≥80% 유지), 열린 결함 비율은 0.0%입니다
(59개의 게이트된 메트릭에 걸쳐 2,844개의 비교 가능한 셀 중 1개) — 새로
심어진 bms(CICS Basic Mapping Support) 코퍼스의 classes_found라는 단
하나의 설명되지 않은 셀; 다른 모든 대역 밖 셀은 원장이 검증한 변이(엄격성
계층, 언어가 표현할 수 없는 구문, 다른 행의 에코, 또는 의도적인 스코어링
선택)이며, 열린 엔진 결함이 아닙니다. 가장 약한 메트릭은 숨기지 않고
명명됩니다 — cog_raw는 언어의 74%를 대역 내에 유지하고, raw_arch_api는
78%, avg_func_args는 80% — 그러나 그 하위 대역 셀은 결함이 아니라
문서화되어 있습니다. 이 주장은 확장에서도 살아남습니다: 코퍼스가 첫 번째
보안 렌즈 프로브 — 모든 언어에 동일한 하드코딩된 시크릿 하나 — 를 심었을
때, credential_material(이전의 risk_secrets_risk; risk_* 이름은 여전히
DB 컬럼 — docs/vectors.md 참조)은 50개 언어 전체에서
균일한 점수(컬럼당 동일한 25.000)를 읽었습니다. 렌즈가 원래 건너뛰었던
두 가지 불활성 형식 예외와 공식의 측정된 길이 의존성은 같은 날 원장에
기록되고 이슈로 제출되었습니다
(#2978,
#2979). #2978은
종료되었습니다: 이제 렌즈는 다섯 가지 불활성 형식(plaintext/markdown/json/
yaml/csv) 모두에서 실행되며, 커버리지를 위해 너무 많은 문서/설정 노이즈를
감수하는 저장소를 위한 SECURITY_SCAN_INERT_FORMATS 설정 옵트아웃이
있습니다. 그리고 병합된 수정에 대한 keyword-rosetta의 코퍼스 재검증은 이제
전부 대역 내에 들어옵니다(원장의 secrets-lens-inert-formats 항목). 모든
편차는 검증된 원장에 기록되고, 작업은
계약 로드맵 아래 원인 계열별로 추적되며, 이런
방식으로 발견된 결함 클래스는
GitGalaxy 이슈로 제출됩니다.
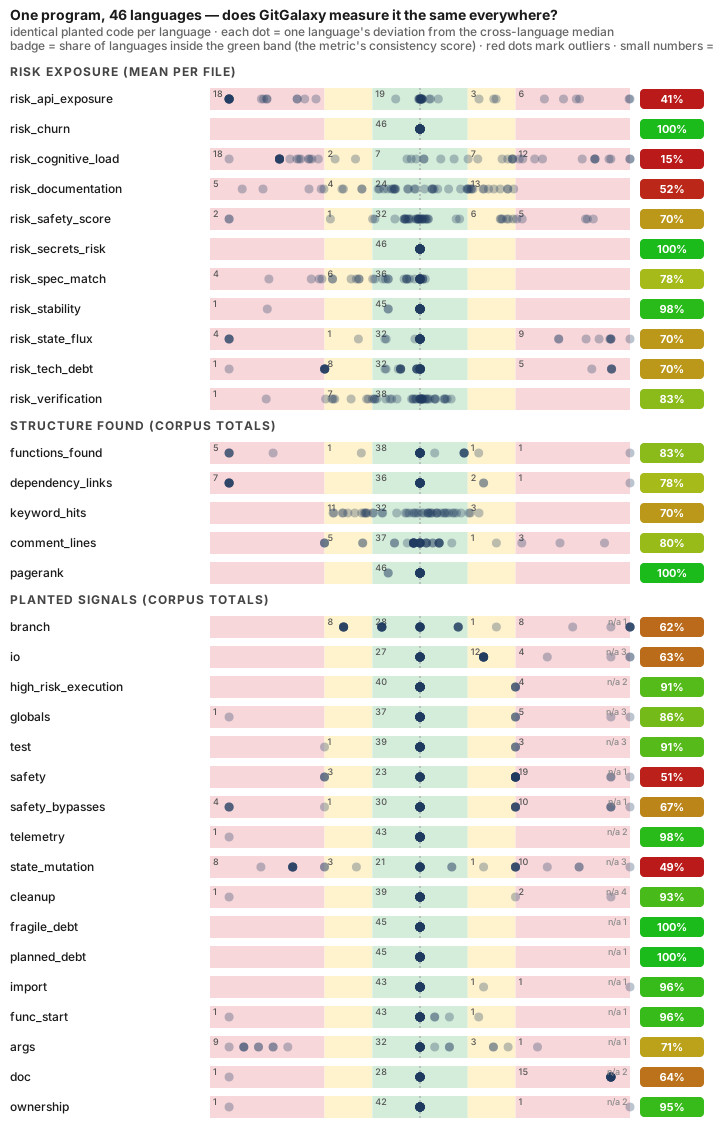
대조 코퍼스는 동일한 의도에 대한 측정 불평등을 증명합니다; 실제 코드에서의 정확도에 대해서는 아무것도 말하지 않습니다(위의 삼중 비교의 역할) — 그리고 파일별 상수 편향은 여전히 한 언어 내에서의 순위를 보존합니다. 발생 보고서는 각 확인된 형태를 실제 라이선스 코드에 대해 측정합니다.
실제 규모
예시: Kubernetes — Go, YAML, JSON, Shell 및 Proto에 걸쳐 약 139만 줄.
엔드투엔드 스캔: 50.83초. 스캔 시간은 적합된 2-영역 모델을 따릅니다
(약 4.3K LOC 아래에서는 평평한 ~0.11초, 그 다음
time(s) ≈ 3.36e-05 × LOC^0.969, 599개 저장소에 걸쳐 R²=0.88) — 따라서
몇 개의 2천만+ LOC 이상치들은 여전히 몇 분이 걸리며, 빠른 스캔은 처리량을
증명할 뿐 통찰 품질을 증명하지 않습니다; 정확도 문제는 아래에서 별도로
다룹니다.

편집되지 않은 아티팩트는 raw output repository를 참조하세요.