
darts v0.47.0
시계열 데이터에 대한 사용자 친화적인 예측 및 이상 탐지를 위한 Python 라이브러리입니다.
Python에서 시계열을 손쉽게 다루기




Darts는 시계열에 대한 사용자 친화적인 예측 및 이상 탐지를 위한 Python 라이브러리입니다. ARIMA와 같은 고전적인 모델부터 심층 신경망에 이르기까지 다양한 모델을 포함하고 있습니다. 예측 모델은 모두 scikit-learn과 유사하게 fit() 및 predict() 함수를 사용하여 동일한 방식으로 사용할 수 있습니다.
이 라이브러리는 또한 모델을 백테스트하고, 여러 모델의 예측을 결합하며, 외부 데이터를 고려하는 것을 쉽게 만들어 줍니다.
Darts는 단변량 및 다변량 시계열과 모델을 모두 지원합니다.
ML 기반 모델은 여러 시계열을 포함하는 잠재적으로 큰 데이터셋에서 훈련될 수 있으며, 일부 모델은 확률적 예측에 대한 풍부한 지원을 제공합니다.
Darts는 또한 광범위한 이상 탐지 기능을 제공합니다. 예를 들어, 시계열에 PyOD 모델을 적용하여 이상 점수를 얻거나, Darts 예측 또는 필터링 모델을 래핑하여 완전한 이상 탐지 모델을 얻는 것은 간단합니다.
문서
고급 소개
선택된 주제에 관한 글
빠른 설치
먼저 선호하는 도구(conda, venv, virtualenv와 virtualenvwrapper 사용 여부에 관계없이)를 사용하여 Python 3.11+로 프로젝트를 위한 깨끗한 Python 환경을 설정하는 것을 권장합니다.
환경이 설정되면 pip를 사용하여 darts를 설치할 수 있습니다:
pip install darts
자세한 내용은 설치 지침을 참조하십시오.
사용 예시
예측
Pandas DataFrame에서 TimeSeries 객체를 생성하고, 이를 훈련/검증 시리즈로 분할합니다:
import pandas as pd
from darts import TimeSeries

# Read a pandas DataFrame
df = pd.read_csv("AirPassengers.csv", delimiter=",")

# Create a TimeSeries, specifying the time and value columns
series = TimeSeries.from_dataframe(df, "Month", "#Passengers")

# Set aside the last 36 months as a validation series
train, val = series[:-36], series[-36:]
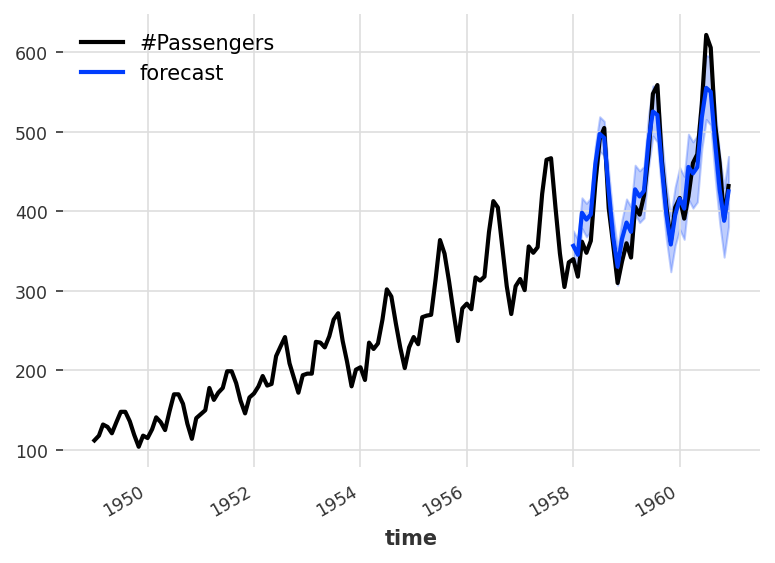
지수 평활 모델을 적합하고, 검증 시리즈의 기간에 대해 (확률적) 예측을 수행합니다:
from darts.models import ExponentialSmoothing

model = ExponentialSmoothing()
model.fit(train)
prediction = model.predict(len(val), num_samples=1000)
중앙값, 5번째 및 95번째 백분위수를 플롯합니다:
import matplotlib.pyplot as plt

series.plot()
prediction.plot(label="forecast", low_quantile=0.05, high_quantile=0.95)
plt.legend()
이상 탐지
다변량 시계열을 로드하고, 다듬은 뒤, 2개의 구성 요소를 유지하고, 학습 및 검증 세트로 분할합니다:
from darts.datasets import ETTh2Dataset

series = ETTh2Dataset().load()[:10000][["MUFL", "LULL"]]
train, val = series.split_before(0.6)
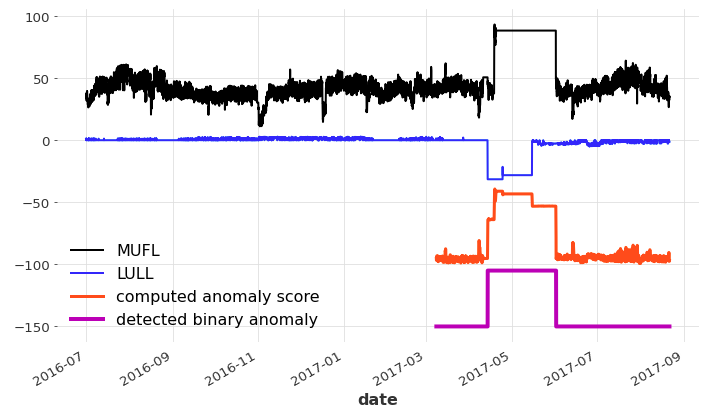
k-means 이상 탐지 스코어러를 구축하고, 훈련 세트로 학습시킨 뒤 검증 세트에 사용하여 이상 점수를 얻습니다:
from darts.ad import KMeansScorer

scorer = KMeansScorer(k=2, window=5)
scorer.fit(train)
anom_score = scorer.score(val)
이진 이상 탐지기를 구축하고 train 점수로 학습시킨 후, validation 점수에 적용하여 이진 이상 분류를 수행합니다:
from darts.ad import QuantileDetector

detector = QuantileDetector(high_quantile=0.99)
detector.fit(scorer.score(train))
binary_anom = detector.detect(anom_score)
일부 시리즈를 이동 및 스케일링하여 모든 것이 같은 그림에 나타나도록 플롯합니다:
import matplotlib.pyplot as plt

series.plot()
(anom_score / 2. - 100).plot(label="computed anomaly score", c="orangered", lw=3)
(binary_anom * 45 - 150).plot(label="detected binary anomaly", lw=4)
Features
-
Forecasting Models: 회귀 및 분류 작업을 위한 대규모 예측 모델 컬렉션으로, 통계 모델(예: ARIMA)부터 딥러닝 모델(예: N-BEATS)까지 포함합니다. 아래의 forecasting models를 참조하세요.
-
Anomaly Detection
darts.ad모듈에는 이상 점수 산출기(anomaly scorer), 탐지기(detector), 집계기(aggregator) 컬렉션이 포함되어 있으며, 이들을 모두 결합하여 시계열의 이상을 탐지할 수 있습니다. Darts의 예측 또는 필터링 모델을 감싸서 예측값과 실제값을 비교하는 완전한 이상 탐지 모델을 쉽게 구축할 수 있습니다.PyODScorer를 사용하면 시계열에 PyOD 탐지기를 손쉽게 적용할 수 있습니다. -
Multivariate Support:
TimeSeries는 다변량일 수 있습니다. 즉, 단일 스칼라 값 대신 여러 시간에 따라 변하는 차원/열을 포함할 수 있습니다. 많은 모델이 다변량 시계열을 입력으로 받아 출력할 수 있습니다. -
Multiple Series Training (Global Models): 모든 머신러닝 기반 모델(모든 신경망 포함)은 여러 (잠재적으로 다변량인) 시계열에 대해 학습하는 것을 지원합니다. 이는 대규모 데이터셋으로도 확장할 수 있습니다.
-
Probabilistic Support:
TimeSeries객체는 (선택적으로) 확률적 시계열을 나타낼 수 있습니다. 예를 들어 신뢰 구간을 얻는 데 사용할 수 있으며, 많은 모델이 다양한 방식의 확률적 예측(예: 모수적 분포 또는 분위수 추정)을 지원합니다. 일부 이상 탐지 점수 산출기는 이러한 예측 분포를 활용할 수도 있습니다. -
Conformal Prediction Support: 당사의 conformal prediction 모델을 사용하면 사전 학습된 모든 전역 예측 모델에 대해 보정된 분위수 구간을 갖는 확률적 예측을 생성할 수 있습니다.
-
Past and Future Covariates Support: Darts의 많은 모델은 예측을 생성하기 위한 입력으로 과거에 관측된 및/또는 미래에 알려진 공변량(외부 데이터) 시계열을 지원합니다.
-
Static Covariates Support: 시간 의존적 데이터 외에도,
TimeSeries는 각 차원에 대한 정적 데이터를 포함할 수 있으며, 일부 모델에서 이를 활용할 수 있습니다. -
Hierarchical Reconciliation: Darts는 조정(reconciliation)을 수행하는 변환기를 제공합니다. 이를 통해 기본 계층 구조를 존중하는 방식으로 예측값이 합산되도록 할 수 있습니다.
-
Regression Models: 대상 시계열과 공변량의 지연값(lagged value)의 함수로 예측값을 얻기 위해 모든 scikit-learn 호환 모델을 플러그인할 수 있습니다.
-
Training with Sample Weights: 모든 전역 모델은 샘플 가중치를 사용한 학습을 지원합니다. 이는 각 관측치, 예측 시간 단계 및 대상 열에 적용할 수 있습니다.
-
Forecast Start Shifting: 모든 전역 모델은 이동된 출력 윈도우에 대한 학습 및 예측을 지원합니다. 이는 예를 들어 일일 사전 시장(Day-Ahead Market) 예측이나, 공변량(또는 대상 시계열)이 지연되어 보고되는 경우에 유용합니다.
-
Explainability: Darts는 SHAP 값을 사용하여 일부 예측 모델을 설명할 수 있는 기능을 갖추고 있습니다.
-
Data Processing: 시계열 데이터에 일반적인 변환(스케일링, 결측값 채우기, 차분, boxcox 등)을 쉽게 적용(및 되돌리기)할 수 있는 도구입니다.
-
Metrics: 시계열의 적합도(goodness of fit)를 평가하기 위한 다양한 지표로, R2-score부터 Mean Absolute Scaled Error까지 포함합니다.
-
Backtesting: 이동 시간 윈도우를 사용하여 과거 예측을 시뮬레이션하기 위한 유틸리티입니다.