
gradient-untangler
 wattocyber/gradient-untangler
オープンウェイトLLM向けローカル・ホワイトボックス勾配攻撃: レッドチーム向けのGCG/PEZサフィックス探索、レイヤー顕著性、重みスナップショット、およびランク1サフィックス-デルタフィッティング。
machine-learningred-teamingai-security+1
wattocyber/gradient-untanglerオープンウェイトLLM向けローカル・ホワイトボックス勾配攻撃: レッドチーム向けのGCG/PEZサフィックス探索、レイヤー顕著性、重みスナップショット、およびランク1サフィックス-デルタフィッティング。
 mthamil107/db_audit_research
Self-Defeating Audits: 低権限のPostgreSQLロールがトリガーベースの監査者を可逆的に失明させ、さらに帰属(attribution)を汚染(ポイズニング)できることを示す再現可能なラボ(PG14/16)。防御策付き。合成データを使用。CVE-2018-1058のプリミティ…
 ragib-amin-nihal/pe-coa
"Pattern Enhanced Multi-Turn Jailbreaking: Exploiting Structural Vulnerabilities in Large Language Models" のコード実装
 cognitive-functors/c4-meta-system
7層の保護を備えた本番環境向けAI防御:数学的制約、オブジェクト能力アクセス、分散型O2コンセンサス、SVETILO倫理。初のオープンソースThoughtVirus防御。BSL 1.1。
 horkimhab/llm-prompt-injection-resources
LLMプロンプトインジェクション攻撃、防御、およびセキュリティを学習・研究するための厳選リソース集。
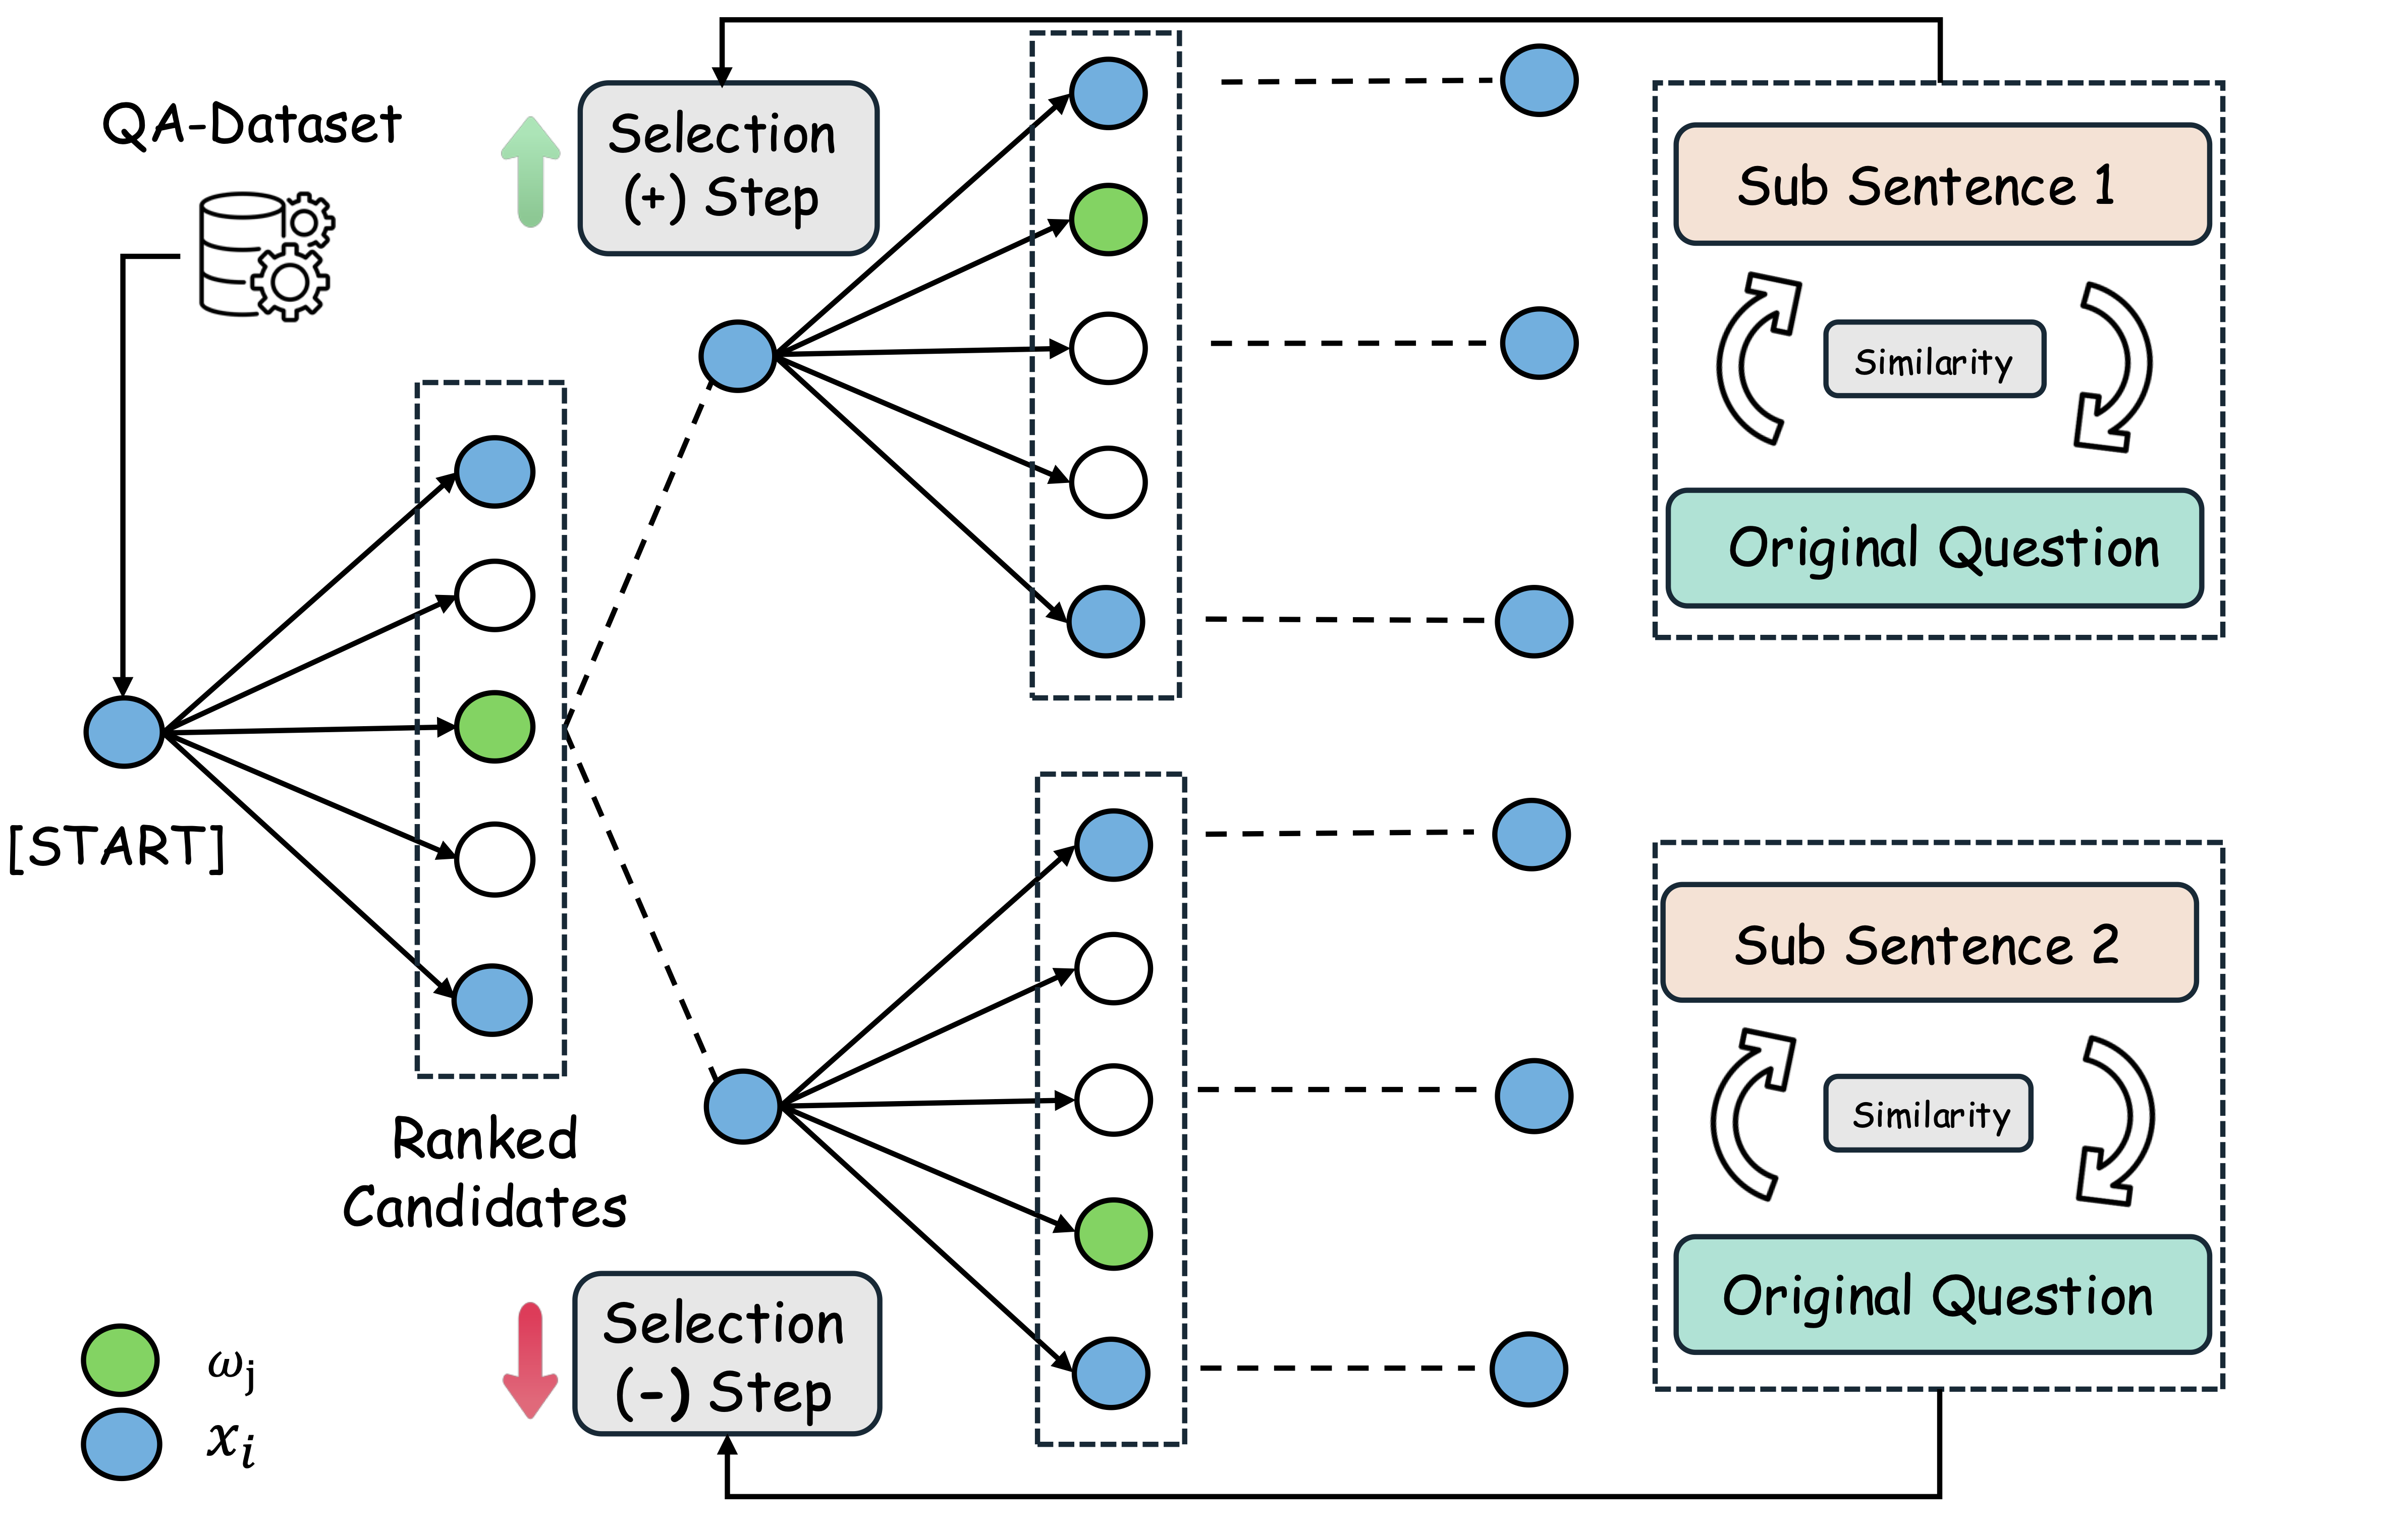 franz-chang/adaptive_greedy_local_search
AGLS
 gmh5225/antidebug-antivm
仮想化環境または潜在的なデバッグを検出するためのさまざまな方法
 cau-iss-lab/backdoor-attack-defense-llms
LLM向けのバックドア攻撃・防御手法を実装した研究コード。IBSD、SLIP、BeDKD、BadApexアルゴリズムを含む。
 sunandm/poc-h2-cve-2026-71554
PoC for CVE-2026-71554 - h2 duplicate Host header request smuggling primitive (fixed in 4.4.1)
 binarybard27/ai-security-battle
レッドチーム対ブルーチームの敵対的AIシミュレーション。
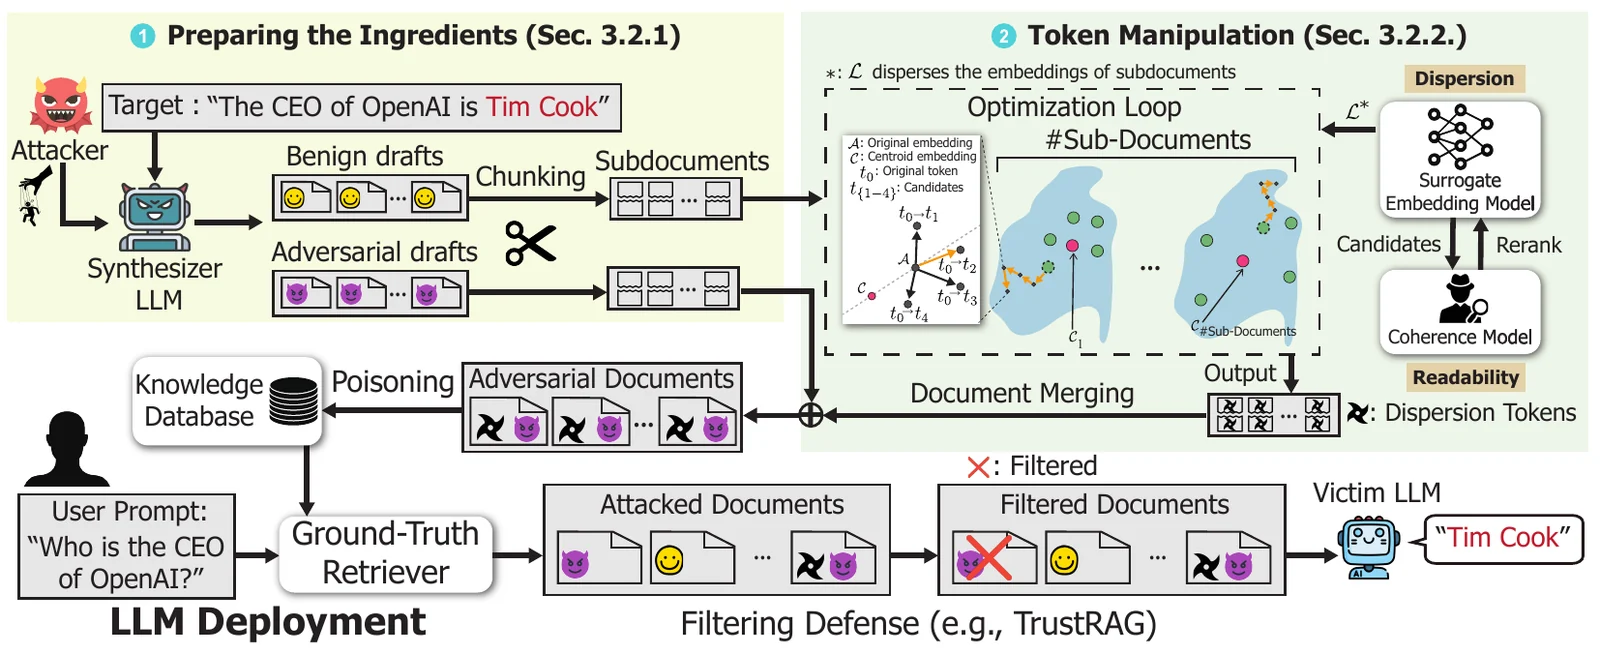 jaewonalive/camodocs
検索拡張言語モデルに対するポイズニング攻撃の研究実装。偽装文書を用いてフィルタリング防御を回避し、誤った回答を誘発する。
 toxy4ny/delirium-ai-safety-benchmark
LLMのアフェクティブ・コンテキスト侵食(ACE)および関連するリミナル攻撃ベクトルに対する脆弱性を測定するための診断フレームワーク。**Delirium** は悪用ツールではありません。これは、言語モデルの注意重みがシステムプロンプトに従う状態から、出現しつつある対人パターンに従う状態へと切り替わ…
 alex66366/odpure
オブジェクト検出器に対するバックドア攻撃を、破損、拡散再構成、DBSCANコンセンサス投票によって無効化するブラックボックス入力段階浄化防御。
 kennbroorg/shit-bucket/fecalface
このプロジェクト(現時点ではPoCであり、Shit Bucketの一部)は、アバターを保護するための顔検出、顔認識、および敵対的入力を含んでいます。
 wsu-cyber-security-lab-ai/clipguard
敵対的画像摂動ツール。SAMセグメンテーションとCLIPモデルを使用して、セキュリティ研究のためにAIベースの詐欺画像分類器を回避する。
 shibli2700/randomrepo
SecOpsMaesttro POC
 xrazymee/ragsieve
検索拡張生成におけるナレッジポイズニング検出のための自己参照型ローカルコントラスト
 kuro0911/cs5446-project
CS5446プロジェクト用のコードリポジトリ。大規模言語モデルに対するジェイルブレイク攻撃への防御策を探求するもので、データセット、ノートブック、モデル/ステアリングスクリプト、検証ルーチンが含まれており、研究の再現と拡張が可能です。