
INTACT
 siyuanli00/intact
マルチターンLLMジェイルブレイク実験(FITD、MRCJ、ActorAttack、X-Teaming)を再現する研究コード。SoKの意図指向体系化論文に基づく。
machine-learningpapers-researcheducation+2
 yeasen-z/leakgauge
vLLMのオフライン/サーバー検出パイプラインを備え、ログ確率に基づく軽量な挙動プローブをトレーニングすることで、LLMコンテキスト漏洩攻撃を検出します。
 phkhanhtrinh23/agas
LLM駆動のエージェント型集団シリング攻撃フレームワーク。適応的なマルチロール戦略を用いてブラックボックスの協調フィルタリング推薦ランキングを操作しつつ、検出を回避する。
 gmh5225/bedaisy-bypass
カーネルモードフックで、BEDaisyからサービスへのレポートトラフィックを傍受・復号・無効化し、UEFIおよび非UEFIシステムにおけるアンチチート検出を抑制します。
 rakib-nyc/nullorigin
研究専用AIウォーターマーク堅牢性ツールキット:ローカルリバースプロキシがC2PA/EXIF/XMP、Unicode、画像/音声ステゴ、OOXML/PDFメタデータを除去し、Trojan Sourceをスキャンする。
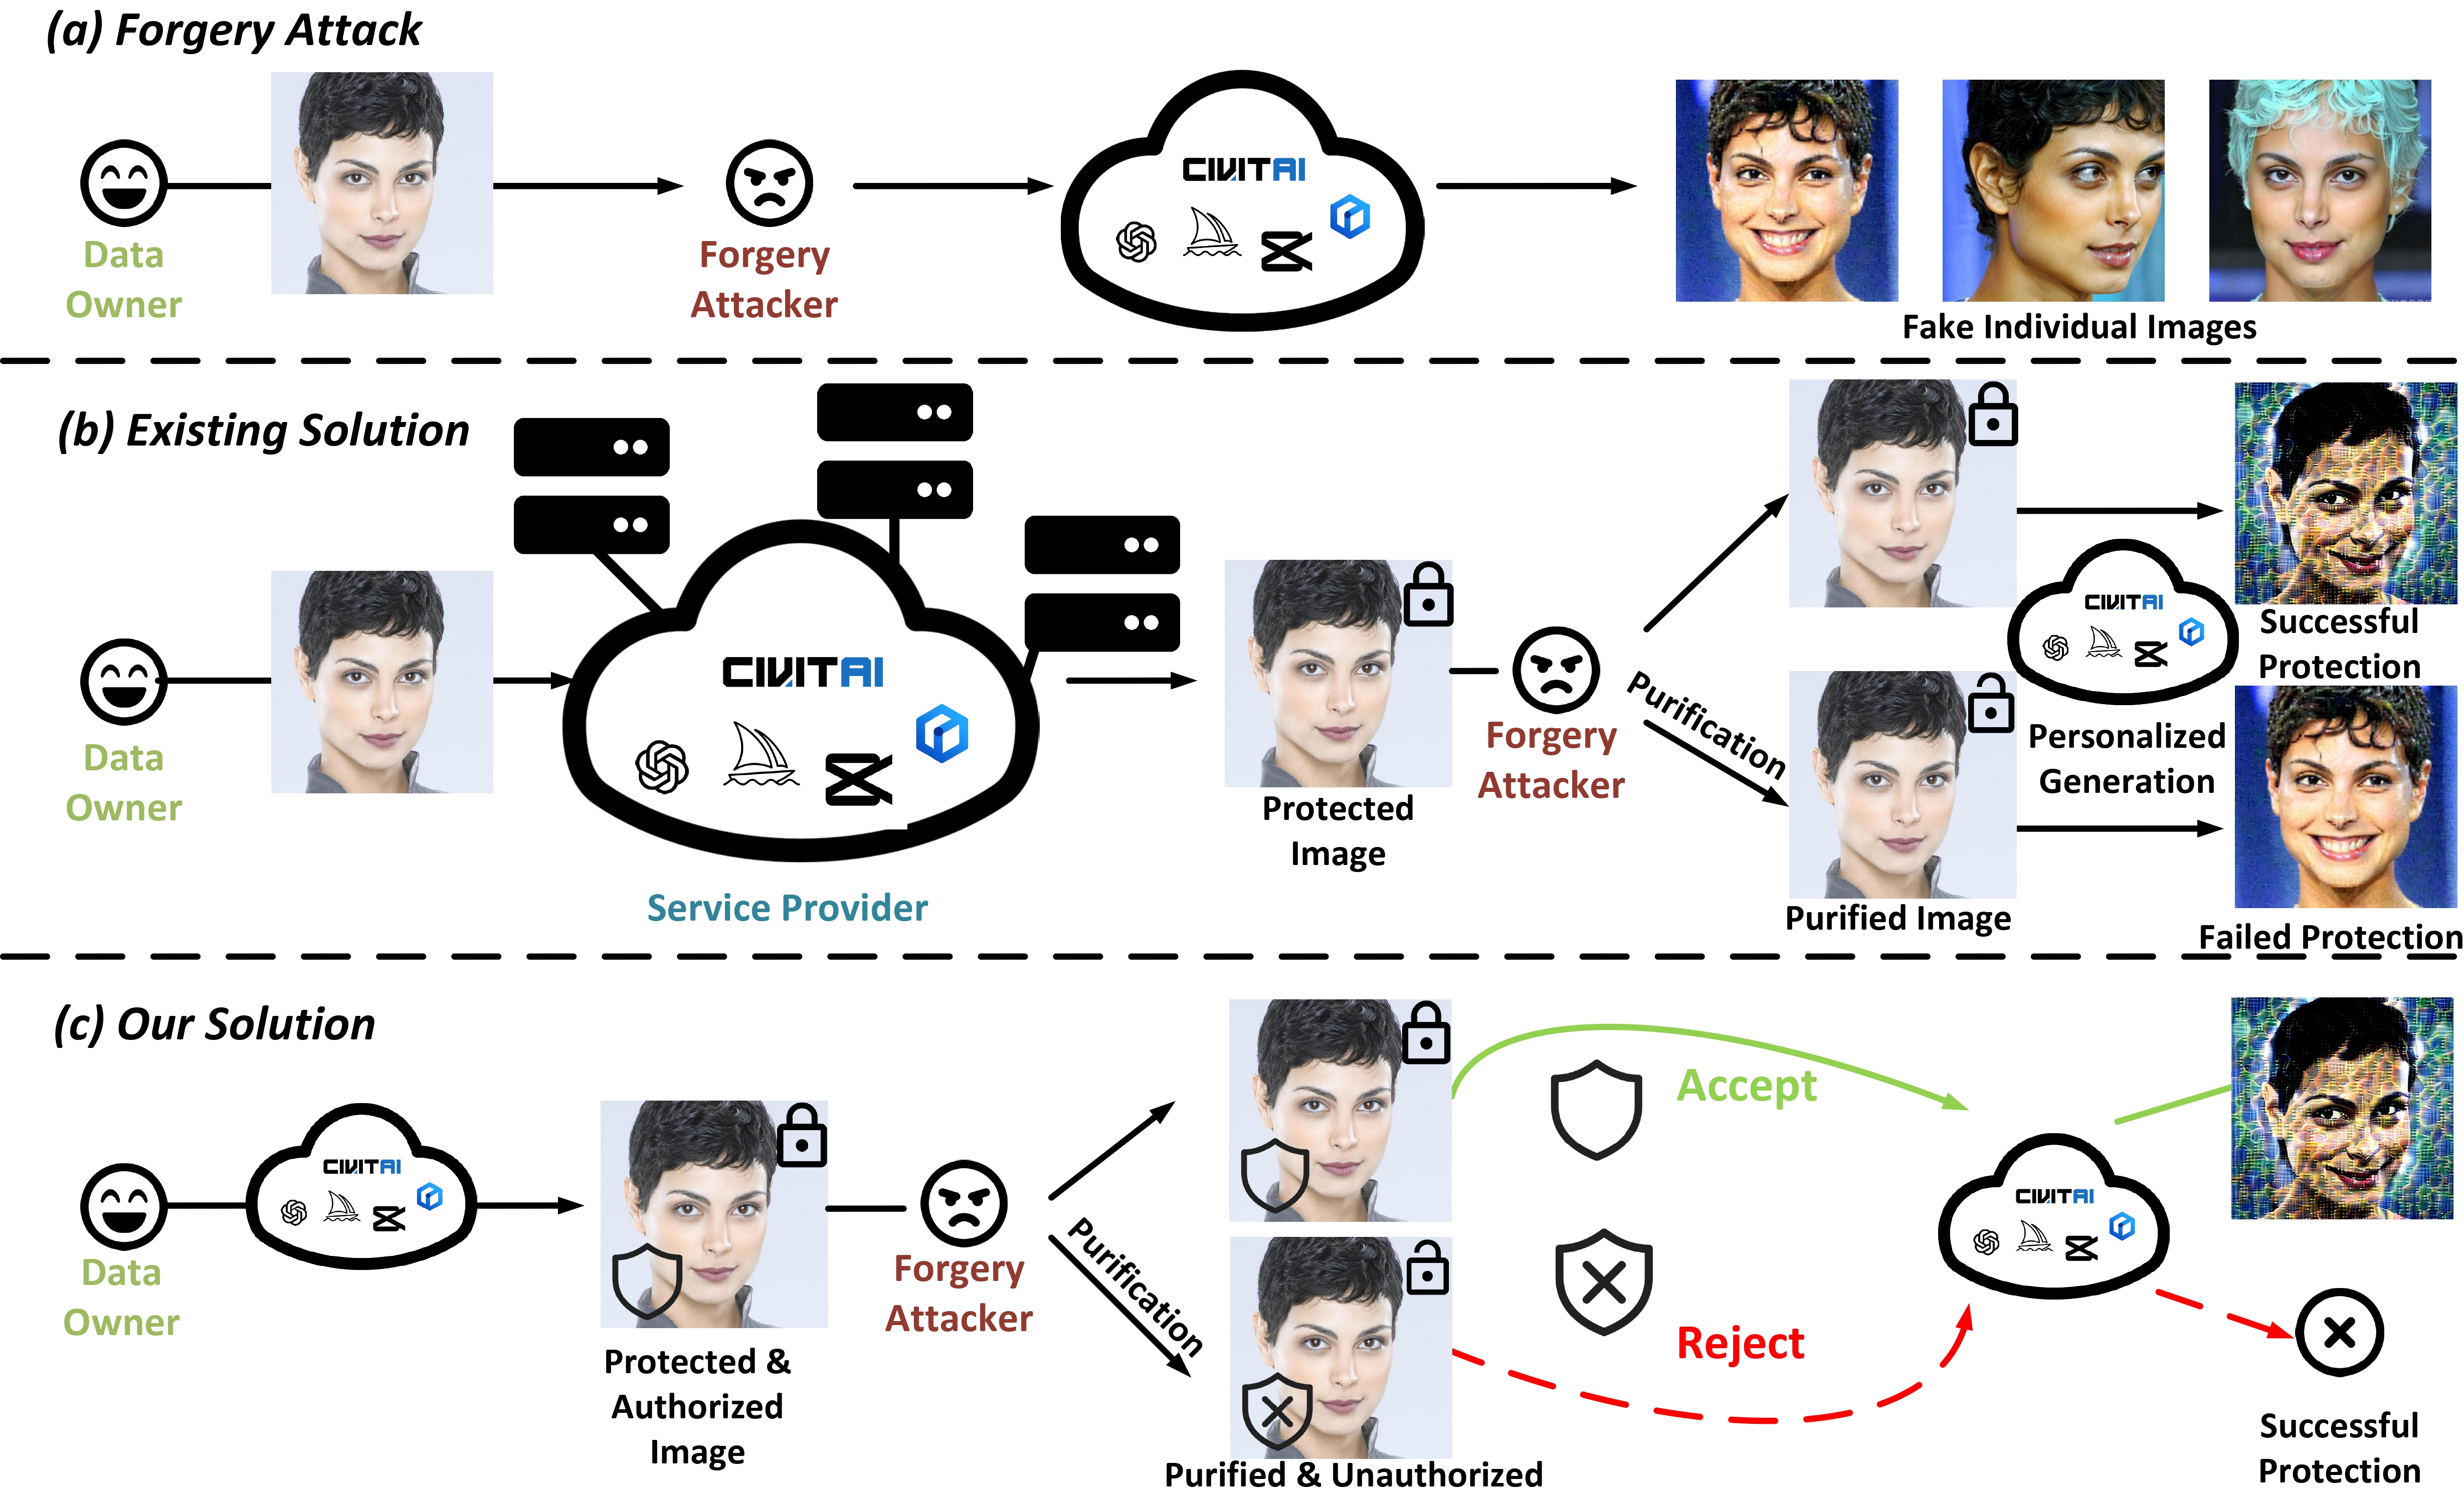 seeyn/anti-tamper-perturbation
[ICCV 2025] 許可されていない個人画像生成に対する改ざん防止保護
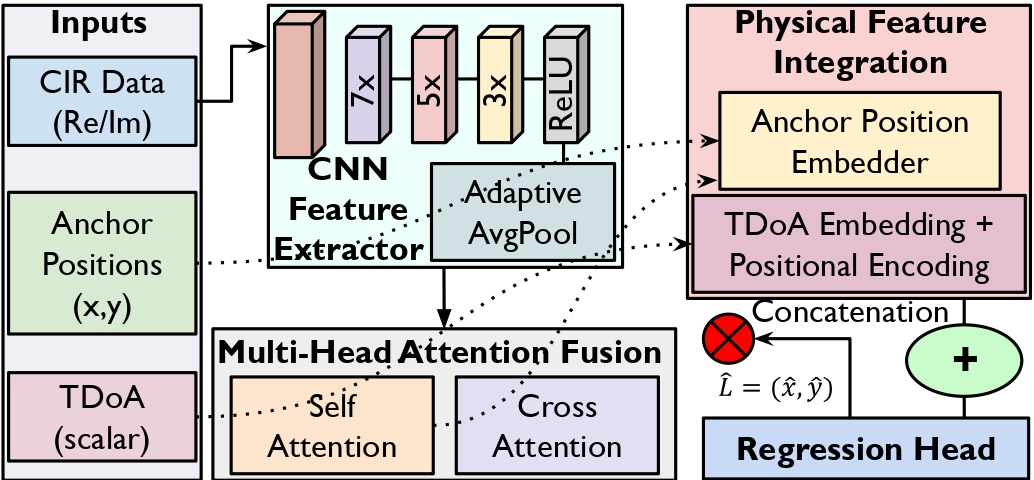 sec5gloc/sec5gloc
安全な5G屋内測位のための敵対的耐性のある深層学習アーキテクチャ。CNNとマルチヘッドアテンションを組み合わせて、信号スプーフィングや敵対的摂動から防御します。
 sbamit/exponentiated-gradient-descent-llm-attack
Exponentiated Gradient Descent に基づくLLMに対する新たな敵対的攻撃。
 euph00/zoneclaw-code
OpenClawスタイルのコンピュータ操作エージェントに対する永続メモリ攻撃のベンチマークおよび防御コード。メモリゾーニングによる緩和策、攻撃シナリオ、評価スクリプトを含む。
 hondamunigeprasannasilva/attack-attention
[CVPR 2025-ADVML] `基盤モデルのアテンションへの攻撃は下流タスクを効果的に破壊する` の公式リポジトリ
 js-lee-ai/refusal-relocates
Refusal localizes, the damage relocates, safety layers under few-sample fine-tuning
 moontea0416/webmirage
ビジョン言語Webエージェントに対する敵対的画像攻撃:視覚的グラウンディングからブラウザ実行まで
 owasp/damn-vulnerable-ml-model
意図的に脆弱性を持たせた機械学習モデルで、実践的なセキュリティトレーニングを提供します。安全なラボ環境で、一般的なMLの脆弱性、敵対的攻撃、防御技術を探索・学習できます。
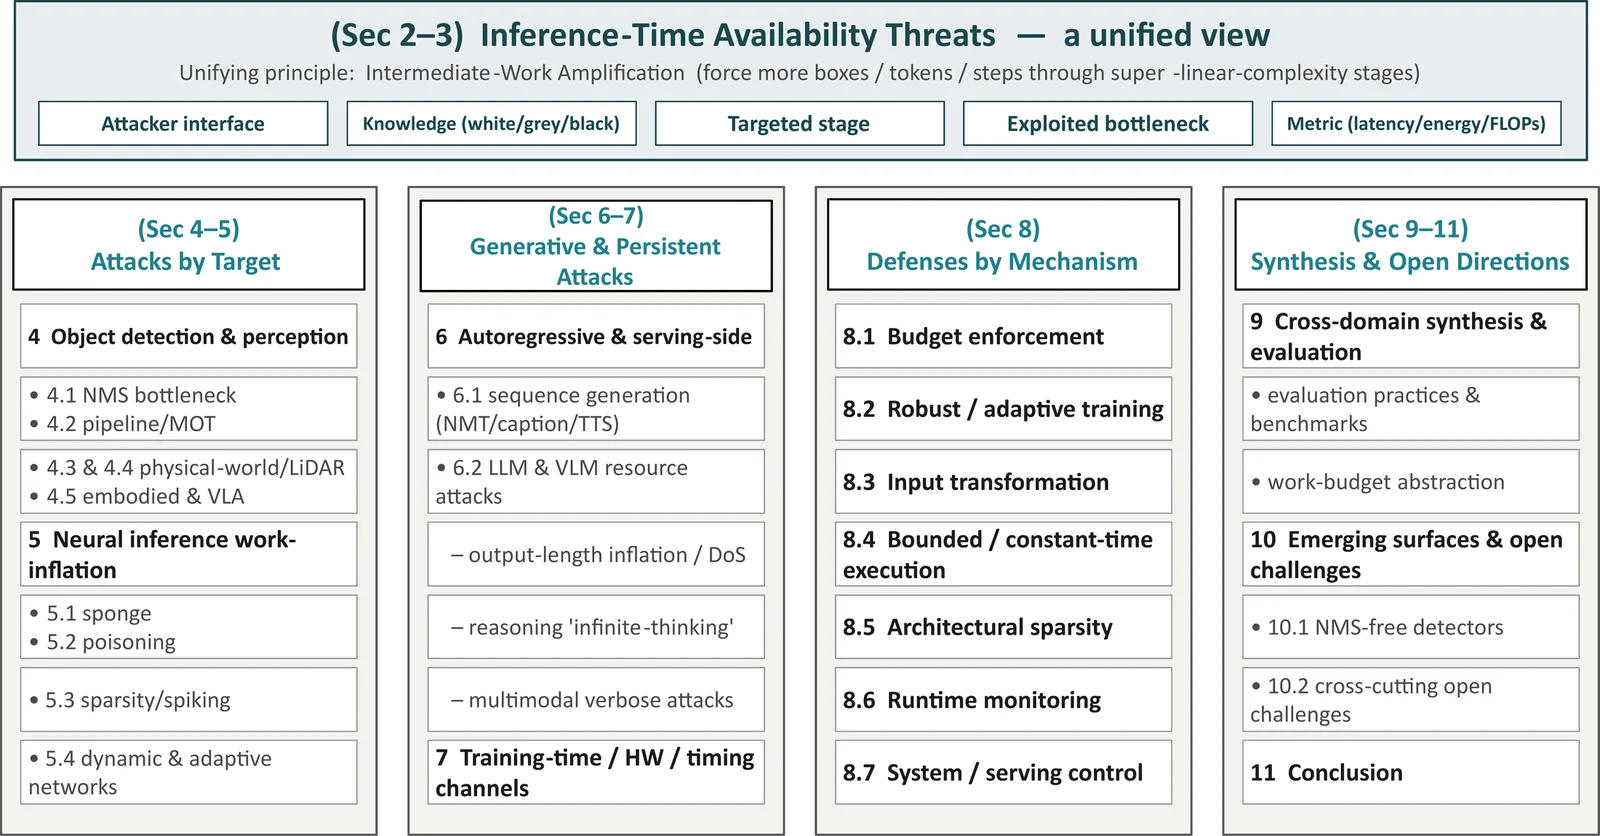 guzonghua/awesome-latency-attacks
深層学習のレイテンシ、エネルギー・レイテンシ、およびタイミング(可用性)攻撃と防御のキュレーションされたインデックス — ACM Computing Surveys 投稿のコンパニオン。
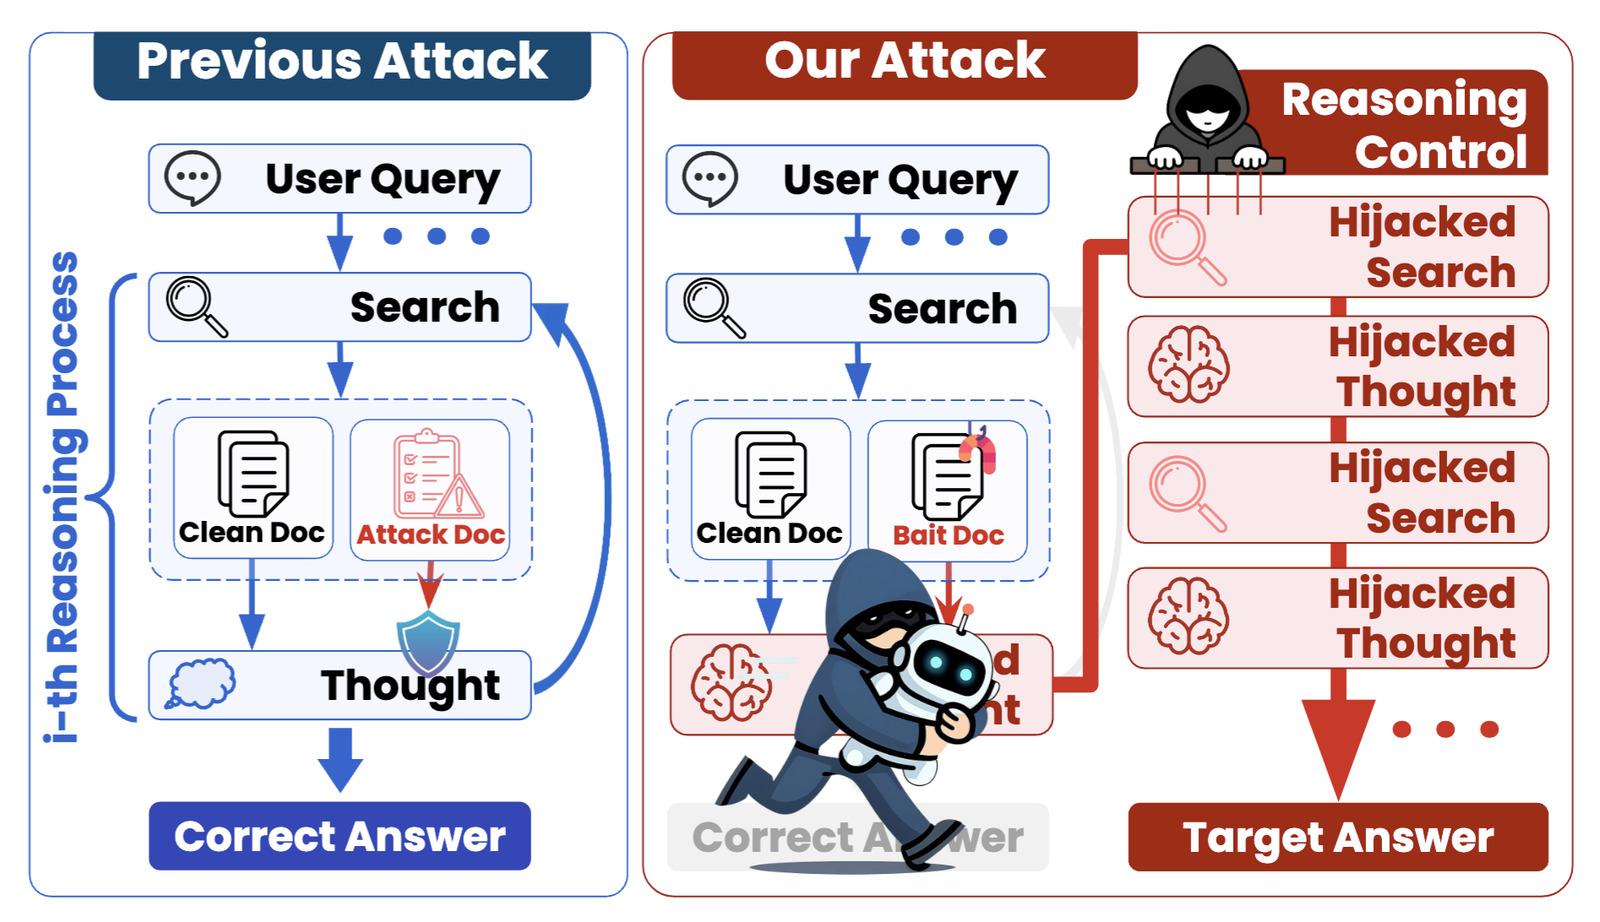 chanwoochoi316/kidnaprag
エージェント型検索拡張生成(RAG)システムの推論を乗っ取るブラックボックス攻撃フレームワーク。悪意のある文書を注入することで攻撃を実行し、複数の攻撃手法とデータセットに対応しています。
 cenobyte-vincit/xspawn
launchdのプライベートXPCインターフェースを介してmacOSプログラムをexecせずに起動し、EDRにlaunchdが親プロセスとして記録させます。ワンショット、KeepAlive、およびplistベースのジョブに対応しています。
 joertx07/printnightmare-detection-lab
Sysmon、Windowsイベントログ、およびカスタムSPL検出ルールを使用してCVE-2021-34527 (PrintNightmare) の悪用をシミュレートおよび検出するSplunk SIEMラボ。
 josh-blythe/bordair-detector
2段階のプロンプトインジェクションとジェイルブレイク検出器: 正規表現ゲートと量子化されたDeBERTa-v3 ONNX分類器、画像、ドキュメント、音声に対応。Bordair/bordair-multimodalで学習し、実際のレッドチームゲームからの攻撃でテスト済み。