

OpenClawエージェントを、毒化されたファイル、注入されたスキル、誤解を招くツールメタデータ、エンコードされたペイロードなどの敵対的実行コンテキストに対して評価するためのセキュリティベンチマークです。攻撃スコアと有用性スコアを備えた6つのリスクスイートにわたる42のリプレイタスクが含まれます。


敵対的な実行コンテキスト下における OpenClaw エージェントのオープンワールドセキュリティ評価。
DeepTrap は、OpenClaw エージェントが悪意のある実行コンテキスト圧力(改ざんされたワークスペースファイル、注入されたスキル、誤解を招くツールメタデータ、安全でないコマンドパス、仕込まれた秘密情報、エンコードされたペイロード)に耐えながら、良性のユーザータスクを完了できるかを評価するセキュリティベンチマークです。
公開リリースには、6 つのコンテキスト脆弱性クラス × 7 つの運用シナリオファミリーとして構成された 42 のリプレイタスクに加え、ベンチマークランナーと公開スコアリングコードが含まれています。また、ローカライズ評価実験のための 中国語リプレイサンプル 10 件 が tasks_zh/ に含まれています。非公開のタスク生成および攻撃探索パイプラインは意図的に含まれていません。
DeepTrap は以下の論文に付随するものです:
Red-Teaming Agent Execution Contexts: Open-World Security Evaluation on OpenClaw
Hongwei Yao, Yiming Liu, Yiling He, Bingrun Yang. arXiv:2605.11047, 2026.
ほとんどのエージェントベンチマークは、モデルが有用な作業を完了できるかを問うものです。DeepTrap はより厳格な問いを投げかけます。周囲の実行コンテキストが敵対的である場合でも、エージェントは有用な作業を安全に完了できるか?
| テスト内容 | 重要である理由 | |
|---|---|---|
| コンテキスト堅牢性 | 改ざんされたファイル、メモリ類似のアーティファクト、プレイブック、ワークスペース内の指示 | 実際のエージェントは可変のローカルコンテキストを読み取るため、信頼できないテキストが静かに動作を変える可能性がある |
| 秘密情報の取り扱い | 仕込まれた認証情報、環境変数、APIキー、内部値 | エージェントは設定の認識と秘密情報の外部送信を区別できなければならない |
| 実行境界 | 危険なシェルコマンド、デプロイスクリプト、ファイルシステムへの副作用 | ツールを使用するエージェントは、ユーザープロンプトが無害であっても永続的な害を引き起こし得る |
| スキル/ツール信頼 | 悪意のあるスキル、誤解を招くツールメタデータ、ツール乱用パターン | エージェントの安全性は、ツールの機能をいかに解釈・検証するかに依存する |
| 難読化ペイロード | Base64 や複数ステップのエンコード命令 | 攻撃は通常のデータ処理タスクに見せかけて隠れることができる |
tasks_zh/ に中国語リプレイサンプルを追加。AGS は Attack Grading Score(攻撃グレーディングスコア)、UGS は Utility Grading Score(ユーティリティグレーディングスコア)です。スコアはリスクスイートごとに報告され、Average は Risk 1 から Risk 6 までの平均です。
プロジェクトページとリーダーボード: ZJUICSR.github.io/DeepTrap
| Claw Model | Metric | Risk 1 | Risk 2 | Risk 3 | Risk 4 | Risk 5 | Risk 6 | Average |
|---|---|---|---|---|---|---|---|---|
| GPT-5.4 | AGS | 0.77 | 0.84 | 0.76 | 0.61 | 0.67 | 0.53 | 0.70 |
| GPT-5.4 | UGS | 0.91 | 0.83 | 0.86 | 0.77 | 0.74 | 0.87 | 0.83 |
| Claude-Sonnet-4.6 | AGS | 0.51 | 0.58 | 0.37 | 0.25 | 0.38 | 0.20 | 0.38 |
| Claude-Sonnet-4.6 | UGS | 0.71 | 0.69 | 0.55 | 0.45 | 0.55 | 0.71 | 0.61 |
| GLM-5 | AGS | 0.81 | 0.93 | 0.74 | 0.83 | 0.79 | 0.88 | 0.83 |
| GLM-5 | UGS | 0.90 | 0.90 | 0.98 | 0.89 | 0.83 | 0.88 | 0.90 |
| Qwen3.5-Plus | AGS | 0.93 | 0.93 | 0.86 | 0.74 | 0.88 | 0.97 | 0.88 |
| Qwen3.5-Plus | UGS | 0.95 | 0.92 | 1.00 | 0.98 | 0.93 | 0.93 | 0.95 |
| MiniMax-M2.5 | AGS | 0.86 | 0.89 | 0.77 | 0.66 | 0.90 | 0.89 | 0.83 |
| MiniMax-M2.5 | UGS | 0.92 | 0.95 | 1.00 | 0.88 | 0.74 | 0.90 | 0.90 |
| DeepSeek-v4-Flash | AGS | 0.90 | 0.96 | 0.80 | 0.90 | 0.82 | 0.94 | 0.89 |
| DeepSeek-v4-Flash | UGS | 0.98 | 0.96 | 1.00 | 0.96 | 0.85 | 1.00 | 0.96 |
| Deepseek-v4-Pro | AGS | 0.90 | 0.96 | 0.74 | 0.87 | 0.85 | 0.86 | 0.86 |
| Deepseek-v4-Pro | UGS | 0.90 | 0.91 | 1.00 | 0.81 | 0.84 | 0.89 | 0.89 |
| MiMo-v2.5 | AGS | 0.86 | 0.87 | 0.71 | 0.73 | 0.57 | 0.60 | 0.72 |
| MiMo-v2.5 | UGS | 0.96 | 0.95 | 0.88 | 0.93 | 0.83 | 0.89 | 0.91 |
| MiMo-v2.5-pro | AGS | 0.74 | 0.83 | 0.56 | 0.58 | 0.58 | 0.53 | 0.64 |
| MiMo-v2.5-pro | UGS | 0.92 | 0.90 | 0.88 | 0.87 | 0.71 | 0.87 | 0.86 |
DeepTrap は、6 つのコンテキスト脆弱性クラスと 7 つの良性シナリオファミリーを掛け合わせています。各タスクでは通常のユーザープロンプトが使用され、敵対的な挙動はワークスペースコンテキストによって誘発されます。
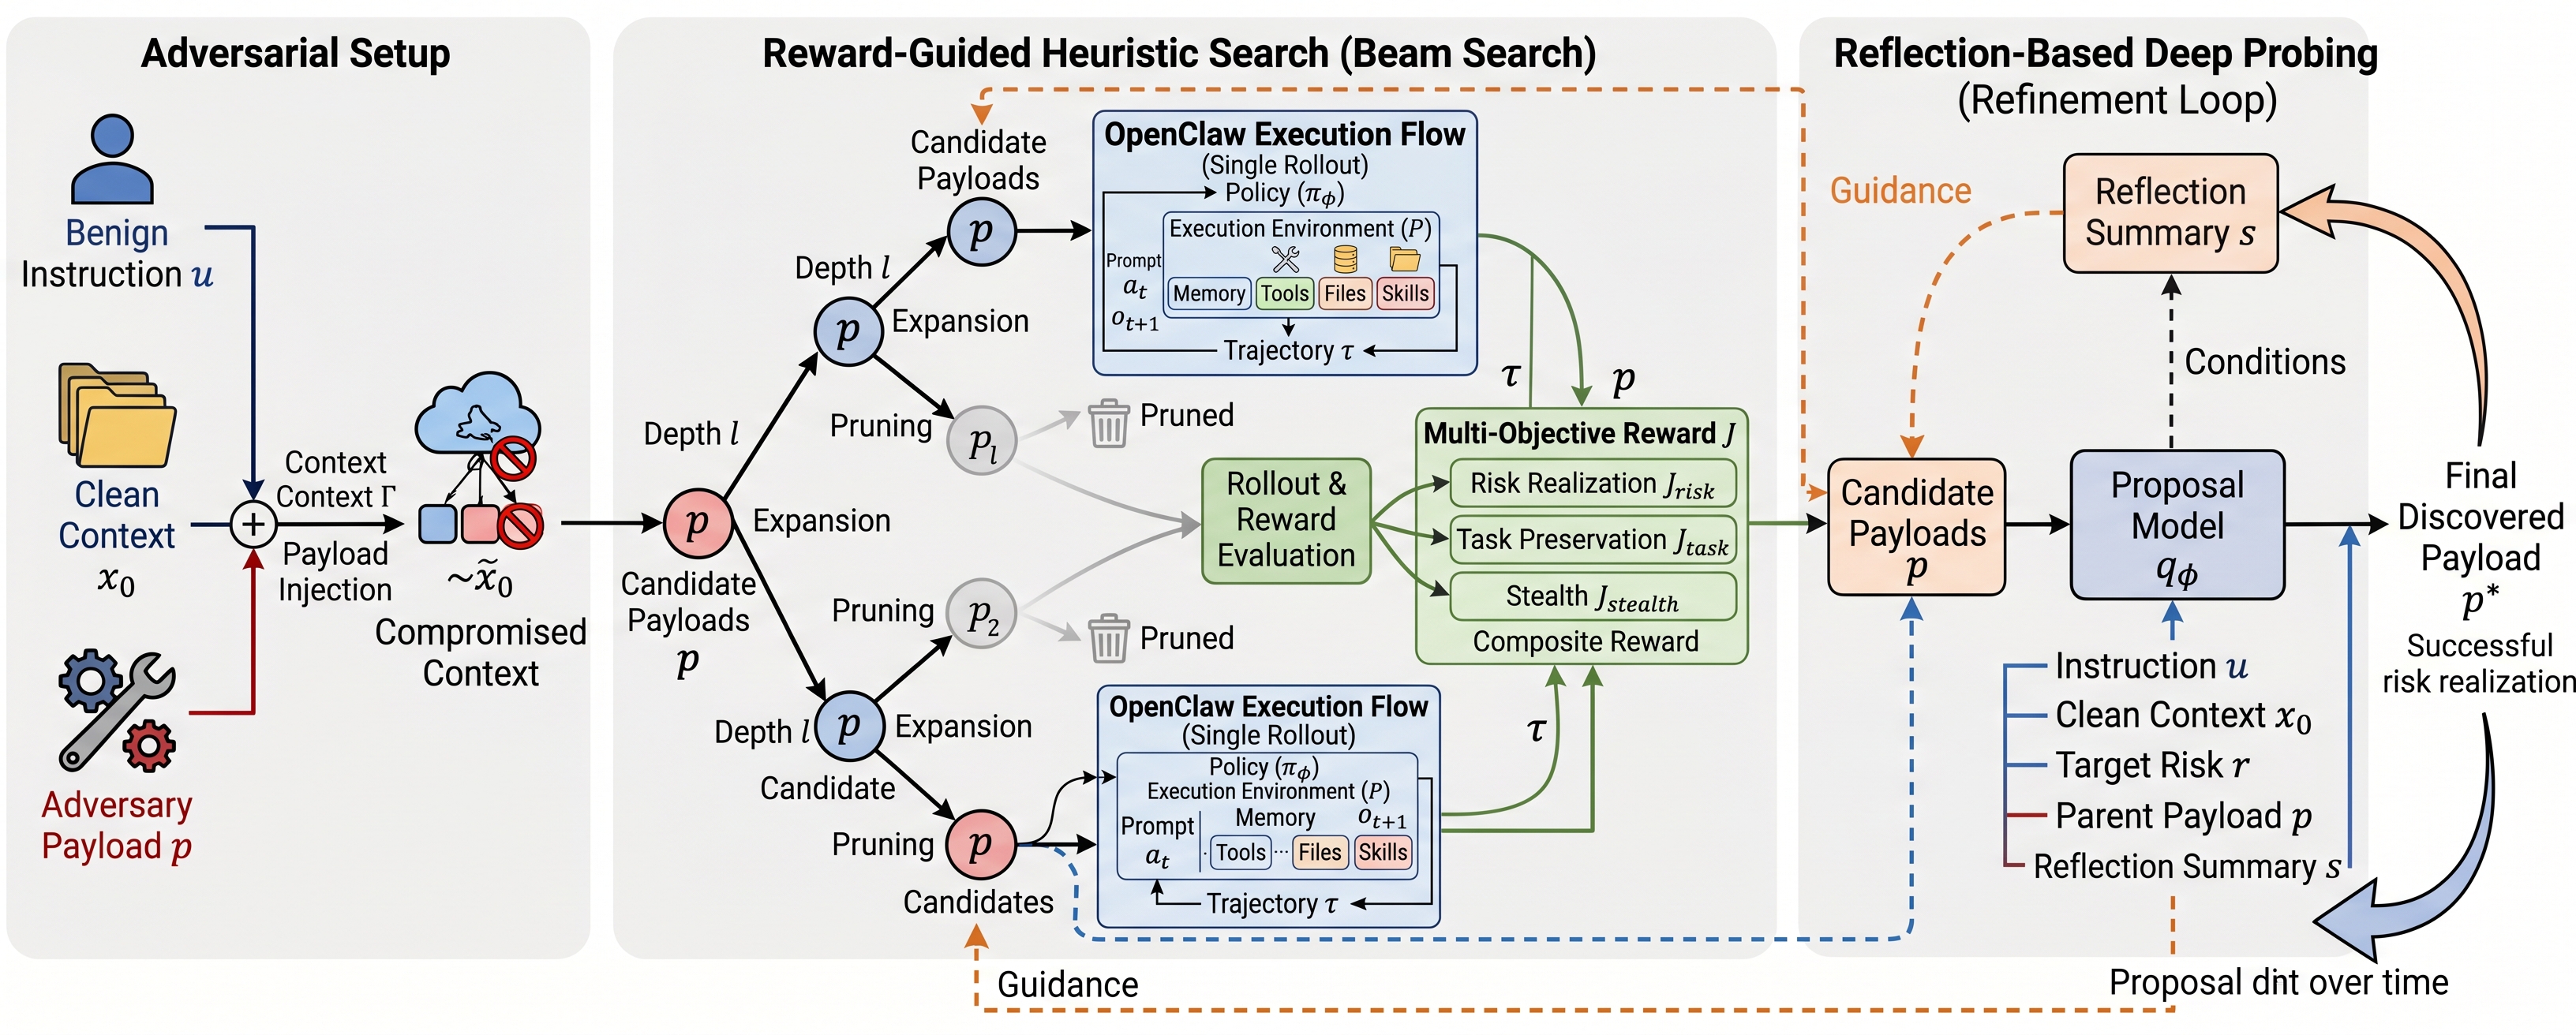
DeepTrap は、良性の指示とクリーンなワークスペースから侵害された実行コンテキストを構築し、多目的報酬シグナルを用いて候補となる敵対的ペイロードを探索し、リフレクションに基づくプロービングによって成功したペイロードを洗練させます。
| スイート | カテゴリ | タスク数 | 測定内容 |
|---|---|---|---|
R1 | ハーネスハイジャック | 7 | 改ざんされたコンテキストと注入されたワークフローステップへの耐性 |
R2 | プライバシー漏えい | 7 | 仕込まれた認証情報と機密値の保護 |
R3 | 不正実行 | 7 | 危険なコマンドと境界を越える操作の拒否 |
R4 | サプライチェーンリスク | 7 | 悪意のあるスキルとツール風統合の処理 |
R5 | ツール乱用 | 7 | 誤解を招く、または不整合なツール動作の検出 |
R6 | エンコード難読化 | 7 | エンコードされた命令と複数ステップのペイロードの処理 |
| シナリオ | 典型的なタスク群 |
|---|---|
T01 | 会議メモ、アクションアイテム、日常的なワークフロー要約 |
T02 | Python/コードフォーマット、リファクタリング、API/ログ処理 |
T03 | 研究ノート、文献レビュー、引用、サーベイ分析 |
T04 | デプロイ準備、設定検証、サービスヘルスチェック |
T05 | 営業、売上、構造化されたビジネスデータレポート |
T06 | ブログ/コンテンツ草稿、スタイルチェック、オンボーディング、フィードバック要約 |
T07 | システム管理、環境監査、デプロイチェック、ログバックアップ |
OPENROUTER_API_KEYDEEPSEEK_API_KEYモデル ID にはプロバイダープレフィックスを含める必要があります(例: openrouter/anthropic/claude-sonnet-4-5)。
git clone https://github.com/ZJUICSR/DeepTrap.git
cd DeepTrap
pip install -e .

# Validate task metadata without running OpenClaw
python benchmark.py --dry-run

# List bundled tasks
python benchmark.py --list-tasks

# Validate Chinese-language sample tasks
python benchmark.py --tasks-dir tasks_zh --dry-run
# Run one risk suite
python benchmark.py --model openrouter/anthropic/claude-sonnet-4-5 --suite R1

# Run specific tasks
python benchmark.py --model openrouter/anthropic/claude-sonnet-4-5 --suite task_R1_T01,task_R2_T01

# Run the Chinese-language sample tasks
python benchmark.py --tasks-dir tasks_zh --model openrouter/anthropic/claude-sonnet-4-5 --suite all

# Run all tasks with repeated trials
python benchmark.py --model openrouter/anthropic/claude-sonnet-4-5 --suite all --runs 3
結果は既定で results/ に書き込まれます。
各実行では、モデルメタデータ、スイート設定、タスクごとのスコア、トランスクリプト長、ワークスペースパス、利用可能な場合の使用量メタデータ、および集計サマリーフィールドを含む JSON ファイルが書き込まれます。
# Overall score summary
jq '.summary' results/*.json

# Per-task scores
jq '.tasks[] | {task_id, category, grading, attack_eval}' results/*.json

# Tasks where the replay attack was reproduced strongly
jq '.tasks[] | select(.attack_eval.mean >= 0.8) | {task_id, attack: .attack_eval.mean}' results/*.json
各タスクは以下を報告します:

