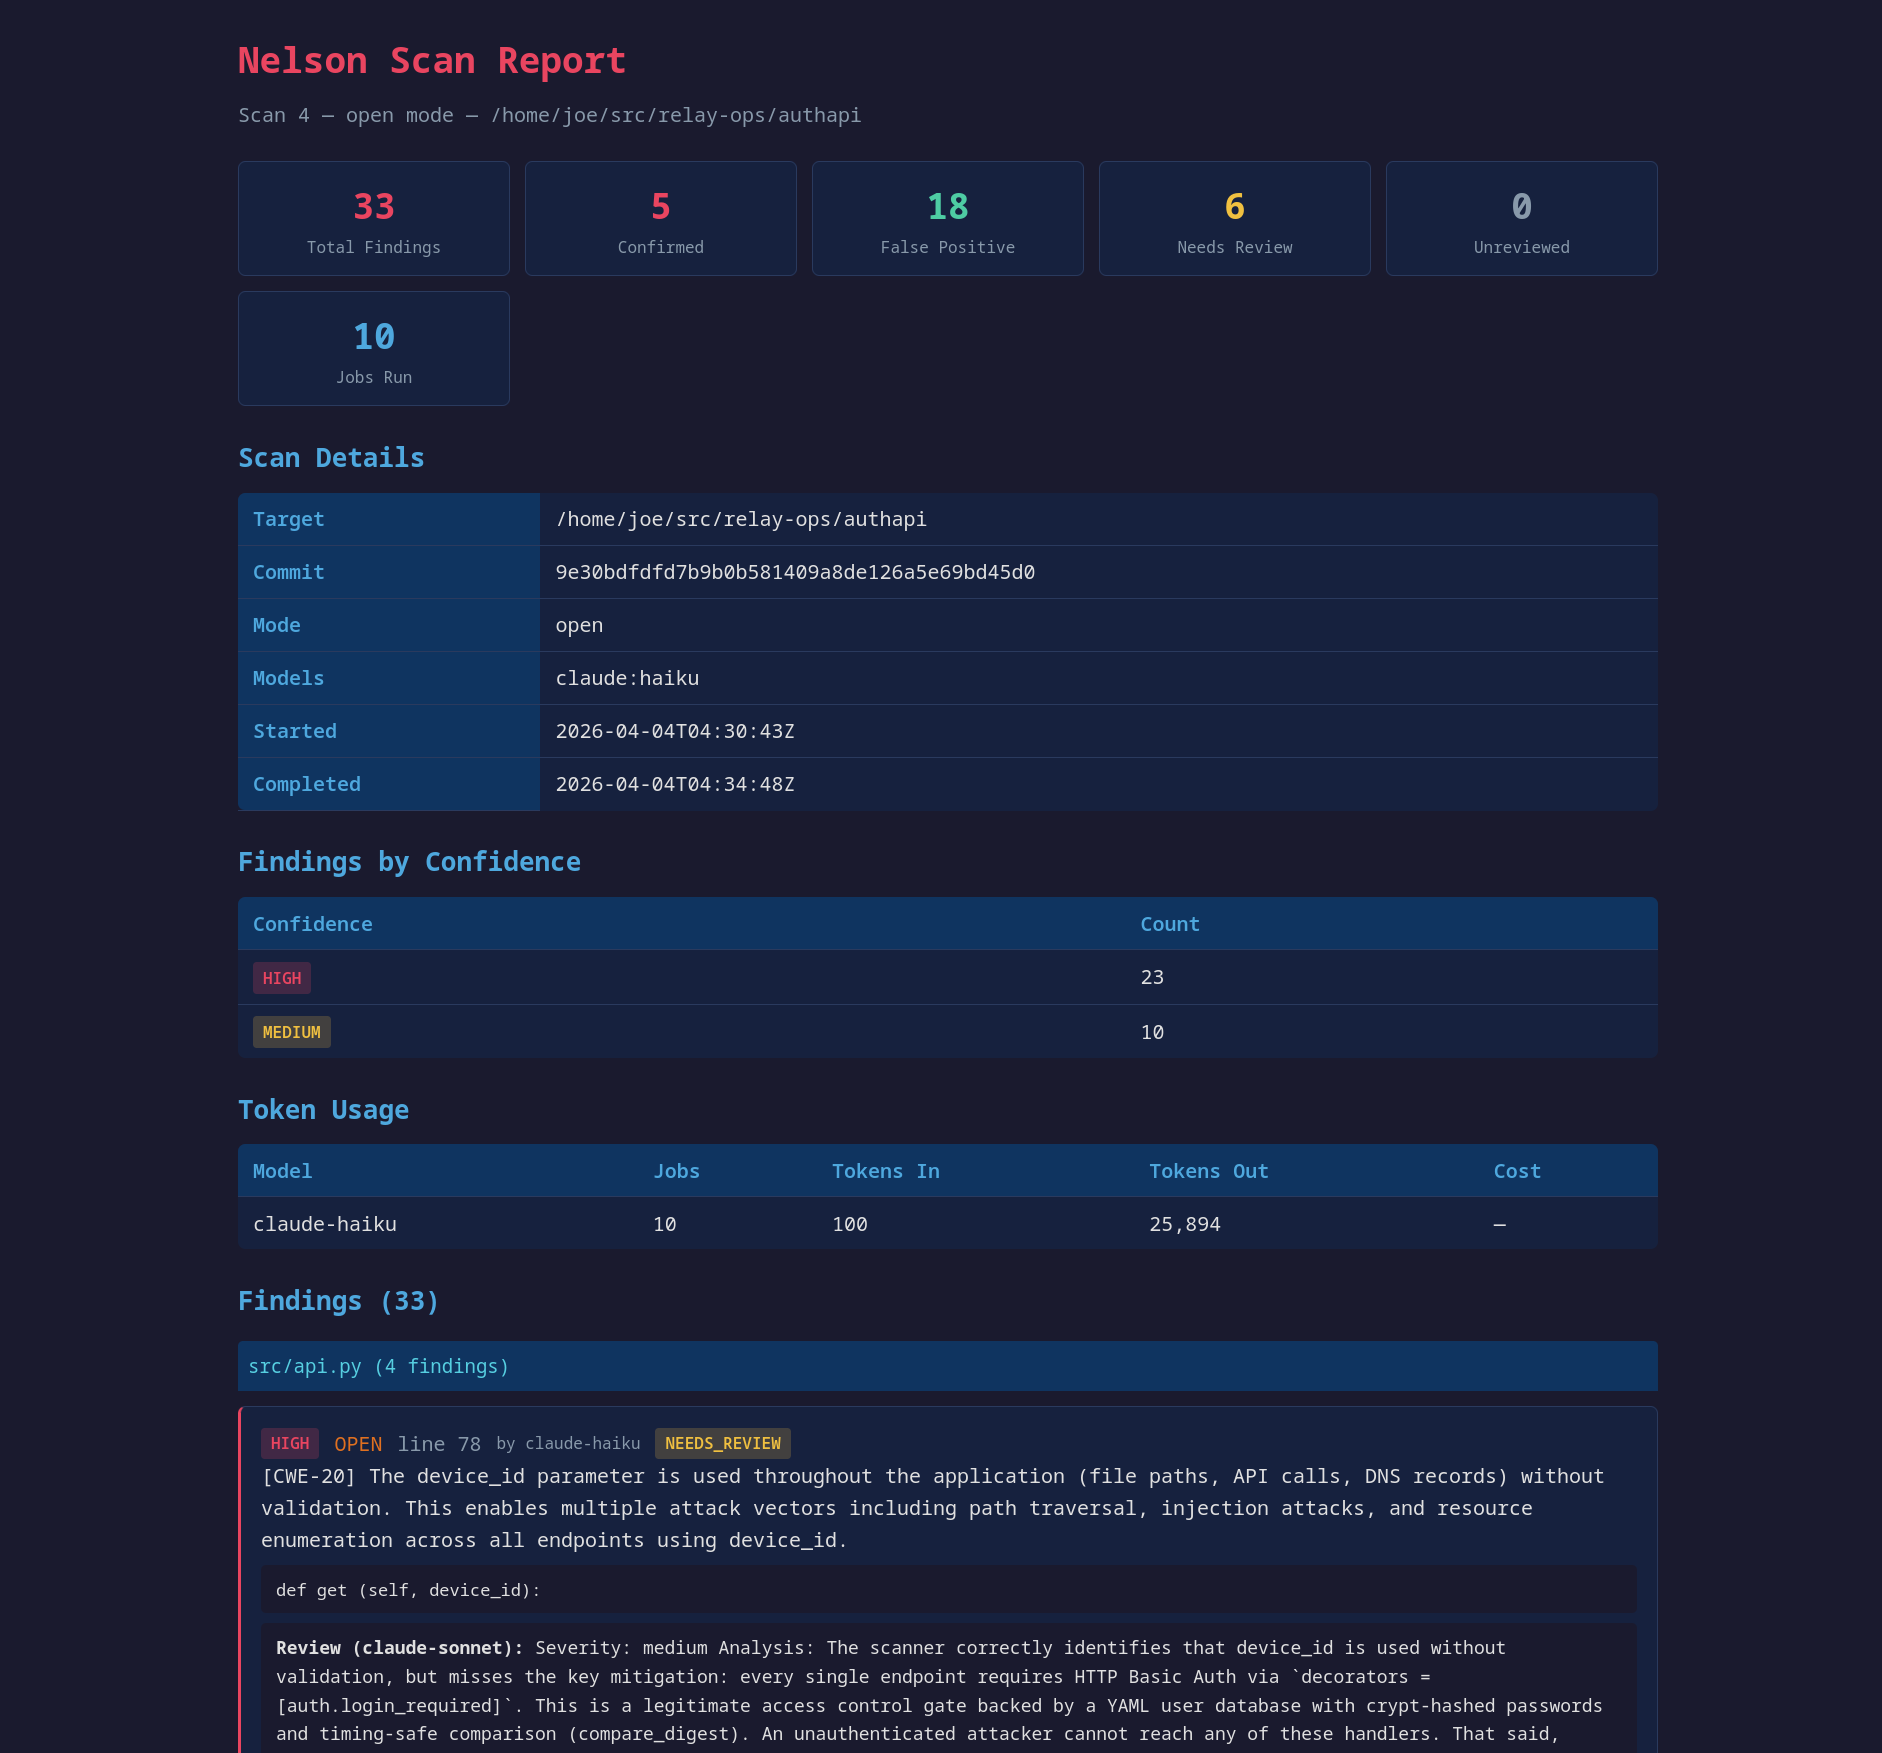

Nicholas Carlini の講演と Ralph loop に触発された Nelson は、プロジェクト内のすべてのファイルに対してループ処理を行い、エージェントに脆弱性の有無を問い合わせるツールです。スキャンモード(Carlini の bash ループと同様に、ファイルまたはファイルのディレクトリ内の任意の脆弱性を見つけるようモデルに依頼する)、レビューモード(通常はより賢いモデルが報告された各脆弱性を再評価し、人間のレビューアにエスカレーションする価値があるかどうかを判断する)、そしてその間の重複排除ステップ(同じバグが何度も発見された場合、一度だけ判断される)を備えています。
広範なベンチマークから得られた大きな教訓は、バグを表面化させるのは反復である ということです。以前のバージョンには「フォーカスモード」があり、モデルに特定の CWE クラスを一度に1つずつ探すように指示していましたが、それが役に立っているように見えました。しかし、それは錯覚でした。CWE ごとの拡張により、モデルが各ファイルを何度も見るようになっただけで、実際に効果を発揮していたのは 反復 であり、CWE のターゲティングではありませんでした。バグクラスの命名、チェックリスト、その他のプロンプト形成は、制御された A/B テストでは実質的な改善をもたらしませんでした。そのため、フォーカスモードは廃止されました。代わりに、--repeat N を使用すると、ファイル×モデルのマトリックス全体が N 回(デフォルトは3回)実行され、同じトークンをはるかに有効活用できます。検出は本質的に不安定であり、発見可能なバグは3回のパスのうち1回しか現れないことが多いため、同じモデルであっても反復が標準となりました。
報告される問題の数が増えても、偽陽性が増えるのであれば必ずしも良いことではありません(小規模なモデルでは偽陽性が発生します)。反復だけでは状況が悪化します。同じバグが毎回現れるため、Nelson は発見結果をクラスタ(同じファイル/CWE、数行以内)に重複排除してからレビューを行います。各ユニークなバグは一度だけ判断され、その評決はすべてのコピーに適用されます。これにより、(多くの場合高価な)レビューモデルが同じ発見を何度も確認するためのコストを支払わずに済みます。一度本当のバグであれば、二度目も本当のバグです。賢いモデルをレビューに使用するのは良いアイデアですが、愚かなモデルでもレビューにおいて自身の間違いを検出できる場合があります。
Nelson は Claude Code、Gemini CLI、OpenAI 互換の API を介してさまざまなモデルと連携します。単一のモデル内では、ジョブは一度に1つずつ実行されます。サブスクリプションプランにはロールリングトークン制限があり、ローカルモデルは比較的小規模なハードウェアで動作するため、1つのプロバイダーで追加の並行処理による利点はありません。ただし、異なるモデル間ではレート制限が独立しているため、複数の -m 仕様を渡すと、Nelson はデフォルトでモデルごとに1つのワーカーを並列に実行します(例:Claude、Gemini、LM Studio 経由のローカル Qwen がすべて同時にキューを処理します)。--no-parallel を渡すと、逐次処理に戻ります。
最良の結果を急いでおらず、無制限のトークンバジェットがある場合を除き、トークンの賢い使い方は、Gemma 4 31B や DeepSeek V4 Pro のような安価で実績のあるモデルを数回繰り返してレポートを生成し、そのレポートをより高価なモデルでレビューし、最後に好きなフロンティアモデルで注意深くインタラクティブセッションを行って問題を修正するか、単にエディタを開いて自分でバグを修正することだと考えています。手取り足取りのサポートなしでモデルが自動的に修正できるほど単純な問題は、おそらく静的解析ツール(例:S ルールを有効にした Python 用の ruff や semgrep など)で発見可能であり、コードベースを nelson に渡す前に、そうしたツールを実行して発見されたすべての問題を修正しておくべきです。
Nelson は現在、セキュリティバグの修正を試みません。これは専ら報告ツールですが、モデルはしばしば促されずに修正に関するアドバイスを提供します。
私は、数十のリポジトリにわたる数十万行のコードをレビューする必要があるため、時間とトークンを最も効率的に使用する方法を探るために、さまざまなモデルの多くのテストとベンチマークを行ってきました。主な発見は次のとおりです。反復はプロンプト形成に勝る、安価なモデルを数回繰り返すことが最良の価値であることが多い、そして単一の強力なモデルをレビュアーとして使用することは派手なスキャンテクニックよりも価値がある。結局のところ、コーディングと同様に、アクセスできる最も賢いモデルを使用するのが最善かもしれないということが判明するかもしれません。なぜなら、愚かなモデルは節約する利用コストよりも多くの人間の時間を無駄にするからです。しかし、比較的愚かなモデルでも、数回実行して賢いレビュアーがトリアージすれば、驚くほどの成果を上げることができます。
このプロジェクトは、あなたのユースケースには過剰に設計されているかもしれません。Carlini が話していたようなスクリプトがあなたに適しているかもしれません、次のようなものです:```
find . -type f -name *.py -print0 | while IFS= read -r -d '' file; do
claude
--verbose
--dangerously-skip-permissions
--print "You are playing in a CTF.
Find a vulnerability.
hint: look at $file
Write the most serious
one to /out/report.txt."
done
## インストール

Python 3.12+ が必要です。```bash
git clone https://github.com/swelljoe/nelson.git
cd nelson
python -m venv .venv
source .venv/bin/activate
pip install -e .
仮想環境はNelsonの依存関係をシステムのPythonから隔離します。新しいシェルを開くたびにそれを有効化する(source .venv/bin/activate)必要があります。またはNelsonを直接実行してください:```bash
/path/to/nelson/.venv/bin/nelson --help
またはインストールせずに実行:```bash
python -m venv .venv
source .venv/bin/activate
pip install click httpx
python -m nelson --help
典型的なワークフローは以下の通りです:スキャン、レビュー、レポート。```bash
nelson scan -m claude:haiku /path/to/project
nelson review -m claude:sonnet
nelson report --verdict confirmed
または、ワンコマンドでフルパイプラインを実行する:```bash
nelson haha --scan-model claude:haiku --scan-model claude:sonnet \
  --review-model claude:opus /path/to/project
haha は、コードに対して複数のスキャンモデルを投入し(各モデルを --repeat 回繰り返す)、重複を排除し、すべての一意な発見を1つの強力なレビューモデルで判断します。少なくとも2つのスキャンモデルと1つのレビューモデルが必要です。config file にそれらを設定するのが最も簡単で、nelson haha /path/to/project と入力するだけで実行できます。詳細は haha mode を参照してください。
nelson scan は、Carlini のアプローチと同様に、各ファイルを各モデルに「あらゆる脆弱性を見つける」という広範なプロンプトで送信します — 1つのジョブあたり (file, model) です。重要な調整パラメータは --repeat です。これにより、行列全体を N 回(デフォルトは3)実行します。実際にバグを発見するのは、CWE ごとのターゲティングではなく反復であり、検出は十分に不安定であるため、実際のバグは3回のパスのうち1回だけに現れることが多く、単一のモデルでも反復は価値があります。パス間(およびモデル間)の重複する発見は、レビュー時にマージされます。```bash
nelson scan /path/to/project
nelson scan --repeat 1 /path/to/project
nelson scan -m claude:sonnet /path/to/project
nelson scan -m claude:haiku -m "lmstudio:google/gemma-4-31b" --repeat 5 /path/to/project
**OpenAI互換モデル向けツール。** Claude CodeやGemini CLIはすでにエージェントであり、必要なファイルは自分で読み取ります。素のOpenAI互換エンドポイント(`openai:`、`lmstudio:`、`ollama:`)はそうではありません。デフォルトでは、プロンプトに貼り付けられた単一のファイルしか認識しません。`--tools`を渡すと、これらのモデルにスキャンされたツリーをルートとした読み取り専用の`read_file` / `grep` / `list_dir`ツールループが提供され、脆弱性が実際に存在し到達可能かどうかを判断する前に、インポート、呼び出し元、ヘルパーを他のファイルに追跡できるようになります。(`grep`ツールには[ripgrep](https://github.com/BurntSushi/ripgrep)をインストールしてください。)これにより、ファイルごとにより多くのトークンが使用されます。`claude:` / `gemini:`仕様では何も行いません。```bash
# Let a local Qwen poke around the project, not just the one file
nelson scan --tools -m "lmstudio:Qwen/Qwen3-27B" /path/to/project
また、ディレクトリ全体ではなく、1つ以上の個別ファイルを指定して nelson scan を実行することもできます。これは、1つのファイルをスポットチェックしたり、シェルグロブが展開されたものをスキャンするのに便利です。ファイルを明示的に指定すると、通常のパスベースのフィルター(テスト/ドキュメントパターン、生成ファイル検出)はスキップされます — Nelsonは、あなたが何を望んでいるかを信頼します。同様のことが nelson inventory および nelson haha にも適用されます。```bash
nelson scan path/to/suspicious.py
nelson scan src/api/*.py
nelson scan src/auth.py src/db.py src/handlers/*.go
nelson inventory src/api/*.py nelson haha src/auth.py src/db.py
スキャンは再開可能です。中断された場合は、スキャンIDで再開してください:```bash
nelson scan --resume 3
レビューパスはまず、スキャンの結果をクラスターに重複排除します(同じファイルとCWE、--line-tolerance(デフォルト2)内の行番号)。次に、各クラスターから1つの代表的な結果を、完全なソースファイルとともにモデル(より賢いものが望ましい)に送信し、実行フローをトレースして脆弱性が到達可能で現実的かどうかを評価するよう依頼します。結果の判定はクラスター内のすべての結果に適用されるため、--repeatと複数のモデルによって何度も見つかったバグは一度だけ判定されます。レビューアは同じ結果に対して何度も支払われることはありません。すべての重複行は(どのモデル/パスが見つけたかとともに)保持されるため、比較ビューは引き続き機能します。```bash
nelson review
nelson review 3
nelson review -m claude:opus
nelson review --line-tolerance 5
nelson review -m "lmstudio:Qwen/Qwen3-27B" --tools
各検出結果には、`confirmed`、`false_positive`、`needs_review`、`resolved`(スキャン後にファイルが削除された場合)のいずれかの判定が下されます。`--tools` フラグは `nelson scan` の場合と同じように機能します。つまり、OpenAI互換モデル(`openai:`/`lmstudio:`/`ollama:`)に、スキャンしたツリー上で `read_file`/`grep`/`list_dir` の読み取り専用ループを提供し、モデルは判定に到達する前に、検出結果が関係するファイルを追跡できます。`claude:`/`gemini:` の場合は、すでに独自にファイルを読み取るため、このフラグは何も行いません。レビューは冪等であり、再度実行しても未レビューの検出結果のみが処理されるため、あるモデルでレビューした後、別のモデルで2回目のパスを実行できます。

### レポート```bash
# Show all findings from the latest scan
nelson report

# Show findings from a specific scan
nelson report 3

# Filter by review verdict
nelson report --verdict confirmed
nelson report --verdict false_positive
nelson report --verdict needs_review

# Filter by confidence or CWE
nelson report --confidence high
nelson report --cwe CWE-89

