 sims718718/unifiedthreathunting
セキュリティチーム向けに、トリガー、SMART仮説、実現可能性ゲート、スコープ設定、ハント計画、結果報告を網羅する、構造化された反復可能な脅威ハンティング手法を文書化します。

リード脅威ハンターとして、私は脅威ハンティングプログラムをゼロから構築する任務を負いました。これには、脅威ハンティングとは実際何なのか、そしてそれを有意義な成果へとどう変換するかについて、多くの考察が伴いました。脅威ハンティング、検知エンジニアリング、サイバー脅威インテリジェンス(CTI)、フォレンジックに関するさまざまな方法論を読み、さらには米国空軍での経験まで、多くの時間を費やしました。しかし、プログラムを構築する中で、私は一つのプロセス、すなわち統合脅威ハンティングプロセスが必要だと気づきました。私はこのプロセスを、ハンティングを構造化され明確に定義された方法で行い、最終的に組織にとって有意義な成果を提供するために開発しました。
graph LR
    Z[Step 0: Environment Context] --> A[Triggering Event]
    A --> B[Hypothesis Development]
    B --> C[Initial Assessment]
    C --> D[Feasibility Assessment]
    D --> E[Define Scope & Objectives]
    E --> F[Formalize Hunt Plan]
    F --> G[Execute Hunt]
    G --> H[Document Outcomes]
    H --> I[Report & Iterate]
    I --> A
脅威ハンティングとは、防御コントロールを回避した脅威を能動的に探し出すことです。その定義はすでに固まっていますが、それをプログラムとしてどう運用するかは固まっていません。このプロセスは統合であり、以下の表はそれを正直に整理したものです:
| 出典 | ここへの貢献 |
|---|---|
| Sqrrl / Hunting Maturity Model (Bianco) | Maturity & Metrics で使用されている中核ループと成熟度ラダー |
| TaHiTI | 真の出発点としてのトリガー、およびクローズ時の隣接プロセスへの引き継ぎ |
| PEAK | ハントの類型化(仮説 / ベースライン / モデル支援)と、成果に焦点を当てた「知識をもって行動する」クローズ |
| AIMOD2 | **侵害前提(assumed breach)**の前提と、類型化された成果カテゴリ |
| OTHF | ハントを反復可能なチーム機能として運用するための運用フレーミング |
| 本プロセスが追加 | ステップ0 環境コンテキスト · 厳格な実現可能性 GO / NO-GO / CONDITIONAL ゲート · 型付き成果を伴うJira Epic/Story/Task · ルーブリックでゲートされた仮説と、規定された検知ハンドオフ |
差別化要素は最後の行です。それ以外はすべて他者の成果の上に立っており、References に引用しています。
ハント運用の実施方法としては、構造化、非構造化、TTPフォーカス、インテリジェンスフォーカス、データ駆動など、さまざまな手法が記述されています。このUnified Threat Hunting Processは構造化されているように見えるかもしれませんが、だからといって仮説を非構造化な方法でデータから導き出せないわけではありません。本プロセスは、さまざまな種類の脅威ハンティングを取り込み、モジュール式のアプローチを可能にすることを目的としています。仮説を徹底的に検証するために、これらすべての手法を用いることになります。
目標は、万能の解が存在しない、モジュール式の脅威ハンティングアプローチです。利用可能なすべての手法を使いましょう。
実際には、選択するハントの種類は、DAIKIチェーン(Data → Information → Knowledge → Insight)のどこから始めるかによって決まります:
| ハントの種類 | 出発点 | 特徴 |
|---|---|---|
| Exploratory (EDA) | 生データ | ベースライン化、データ形状の理解、事前仮説なし |
| Hypothesis-Based (HBO) | 状況認識 | チームの知識に基づく信頼性の高い攻撃シナリオの検証 |
| Threat-Informed (TIO) | 実用的なCTI | インテリジェンス駆動、既知のアクターまたはTTPに焦点 |
| Purple Operations (DPO) | レッドチームの知見 | 攻撃側/防御側の共同検証 |
データサイエンスの原則に従い、ハントの種類にかかわらず、ハントに関連するデータソースを探索し理解することを目指すべきです。このリポジトリの /Data_Analysis フォルダには、その探索フェーズを支援する手法とノートブックが含まれています。
さらに、脅威インテリジェンスは、それが出発点であるかどうかにかかわらず、運用を推進するためにプロセス全体に織り込まれています。Threat Intelligence
注: 通常は行動やTTPに焦点を当てたいところですが、IoCも、真に実用的でタイムリーであれば価値があります。環境全体でIoCをハンティングすることは厳密には脅威ハンティングではありませんが、それでも有用な情報と別の出発点を提供できます。それらはハントサイクルの一部にはなり得ますが、ハントそのもの全体にはなりません。
ハントを開始する前に、環境を記録しておくことで、下流のあらゆる成果物(クエリ、フィールド名、スコープ決定)が、一般的に書かれたものではなく、実際に自分が働く環境に合わせて調整されます。私がこれを明示的なステップとして追加したのは、誰も持っていないデータソースを参照するハント計画や、まったく間違った方言で書かれたクエリを何度も見てきたからです。ここで数分費やすことで、後で何時間も節約できます。
最低限、以下を文書化します:
| コンテキスト | なぜ重要か |
|---|---|
| SIEM / データプラットフォーム | Splunk SPL、KQL、Elastic DSL、Chronicleはそれぞれ、書くすべてのクエリの形を決める |
| EDRプラットフォーム | CrowdStrike、SentinelOne、Defender for Endpointはそれぞれ異なるテレメトリフィールド名を使用する |
| 環境タイプ | オンプレミス、クラウドネイティブ(AWS/Azure/GCP)、またはハイブリッドかで、そもそも存在するログが変わる |
| 業種 | どの脅威アクターが現実的に関連するかを左右する |
| ログ保持期間 | どの時間範囲が実際にクエリ可能かを決める |
| ハント成熟度レベル | 初めてのハンターには足場が必要であり、経験豊富なチームは骨組みを求める |
これをEpicの冒頭に Environment Profile ブロックとして文書化します。急いでいる場合、絶対的な最低限は SIEMプラットフォーム と 環境タイプ です。それ以下ではクエリが一般的なものになってしまいます。
複数の組織にまたがってハンティングしますか?(MSSP/MDR、連合子会社、または共有SIEMプラットフォーム。)テナントごとに1つのプロファイルを
tenants/<id>/profile.yamlレジストリに保持し、各Epicはプロファイルを埋め込む代わりにtenant: <id>を参照するようにします。実現可能性の前に、認可を確認してください: RoE/契約の適用範囲がないテナント、またはそのallowed_actionsの範囲外の計画されたアクションは NOT AUTHORIZED であり、そこで停止します。単一組織のチームはこれを省略できます。Multi-Tenant Operation を参照してください。
TaHiTIフレームワークから借用すると、脅威ハンティングはトリガーとなるイベントから始まります。これらのイベントがハントの開始を正当化します。TaHiTIによれば、トリガーには以下が含まれます:
私たちの組織では、これらに加えて、ステークホルダーからの直接的な要件や環境に影響を与える脆弱性の開示など、いくつかの追加トリガーを使用しています。
一部のフレームワークは、最初の仮説(ここではステップ2)から脅威ハントを始めますが、私は問いかけます: そもそもどうやってその仮説に至るのでしょうか?
最初の仮説につながるトリガーとなるイベントが存在するはずです。ちょうどアイザック・ニュートンが、どのような力がそれを引き下ろすのかと疑問に思う前にリンゴが落ちるのを見たように、そのリンゴは重力に関する仮説につながるトリガーとなるイベントでした。 同様に、仮説に至る前にトリガーがあるべきです。
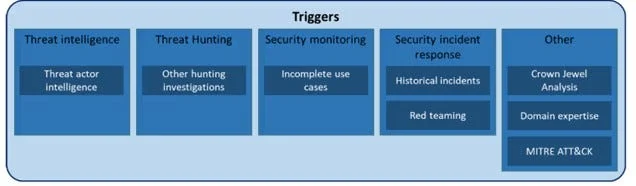
ハンティングトリガー (出典: Targeted Hunting Integrating Threat Intelligence (TaHiTI))
次に、そしておそらく最も重要なステップが、ハント仮説の構築です。このステップは重要である一方で、最も曖昧でもあります。あなたの仮説は、金鉱に導くこともあれば、終わりのないウサギの穴に落とし込むこともあります。
データサイエンスの原則から言えば、仮説とは分析を導くための検証可能な命題を作成することです。それだけでなく、仮説をSMARTにすることを目指すべきです:
有用なテンプレート:
[脅威アクター / 手法 / 行動] が、[データソース] における [観測可能な指標] によって証拠づけられる形で、私たちの環境に存在する可能性があると仮説を立てる。これは [時間枠] 内に [検証方法] によって検証できる。
例1(CTI駆動、TIO):
Kerberos事前認証が無効化されたアカウントに対するAS-REP Roasting(T1558.004)を使用する攻撃者が、私たちの環境に存在する可能性があると仮説を立てる。これは、Splunk Windows Securityログにおいて、ドメインコントローラー以外のソースからの事前認証タイプ0を伴うイベントID 4768によって証拠づけられる。これは、過去30日分の認証イベントをクエリし、サービスアカウントインベントリと照合することによって、スプリント終了までに検証できる。
例2(行動駆動、HBO):
特権アカウントによる業務時間外の異常な対話型ログオンが、資格情報の悪用を示している可能性があると仮説を立てる。これは、Domain Adminsグループのアカウントに対するCrowdStrikeテレメトリにおけるイベントID 4624(タイプ2または10)および4672によって証拠づけられる。これは、60日分のログオン履歴をベースライン化し、2標準偏差を超える逸脱をフラグ付けすることによって、2週間以内に検証できる。
仮説を構築する際には、実際には多数の競合する仮説を展開することになるかもしれません。これについて読む価値のある本は、CIAのCenter for the Study of Intelligenceが出版した、Richards J. Heuer著の Psychology of Intelligence Analysis です。Heuerは競合仮説(Competing Hypotheses)について述べており、これはハント活動に有益です。
このプロセスは、複数の仮説を定義し、その中で最も妥当なものを決定することを含み、仮説構築フェーズに厳密さをもたらし、ハントの基盤を定義するのに役立ちます。7ステップのプロセスは以下の通りです:
次の2つのフェーズは、仮説に基づいてハントを実行すべきか否かを定義するために、このプロセスに依拠しています。
さらに、AIMOD2フレームワークの重要な概念は、**侵害前提(assumed breach)**という根底にある仮説です。私たちは、敵対者がすでに私たちのコントロールを回避しているという前提の下で、未知のものを特定することに焦点を当てています。
初期評価フェーズでは、仮説を支持するデータを収集し調査します。これには内部ソースと外部ソースの両方が含まれます。
ここでのサブステップは、ビジネスまたは技術オーナーを特定し、必要に応じてインタビューすることです。ハントによっては、より深い理解のためにSMEを関与させる必要があるかもしれません。これは常に必要なわけではなく、経験や過去のハントからシステム、ログ、アプリケーションをすでに知っている場合もあります。
目標は、システムの専門家になることではなく、環境について十分な理解を深めることです。
ハント活動を計画する前に、実現可能性を評価する必要があります。これには以下が含まれます:
本質的に、私たちは問いかけます: 「手間をかける価値はあるか?」
テレメトリが利用できない場合は、問いかけます: 利用可能にできるか? そのためにどのような労力が必要か?
各実現可能性評価は、明確な決定を生み出すべきです:
| 決定 | 意味 |
|---|---|
| ✅ GO | すべての基準を満たしている、計画に進む |
| ❌ NO-GO | 重大な阻害要因が存在する、是正計画とともにバックログに入れる |
| ⚠️ CONDITIONAL | 軽微なギャップがある、前提を文書化して注意事項付きで進める |
上記のAS-REP Roasting仮説を用いて:
