
 seclog-open/seclog
再現可能なDocker攻撃シナリオからマルチソースのセキュリティログを収集し、攻撃チェーンを構築するとともに、LLMの攻撃段階推論を評価するためのSecLog-Bench-216ベンチマークを提供します。

SecLogは、複数のソースから得られるセキュリティログを用いた攻撃段階推論の研究を支援します。再現可能なDockerによる攻撃シナリオおよび通常活動シナリオからログを収集し、その証拠を攻撃チェーンとして整理し、ラベル付きデータセットを構築し、モデルの予測を評価するためのツールを提供します。
このリリースにはSecLog-Bench-216が含まれています。これは、レビュー済みの段階ラベルと参照推論チェーンを備えた216個の証拠ウィンドウからなる、すぐに利用可能なベンチマークです。研究者は提供されたベンチマークを直接利用することも、構築パイプラインを実行して新しいデータを生成することもできます。
論文: SecLog-Bench: A Scalable Benchmark for Cybersecurity Log Reasoning with Scaffolded Evidence。
Zenodo上の構築リソース: Dockerイメージ、生ログとアラインメントインデックス、構築済み攻撃チェーン。
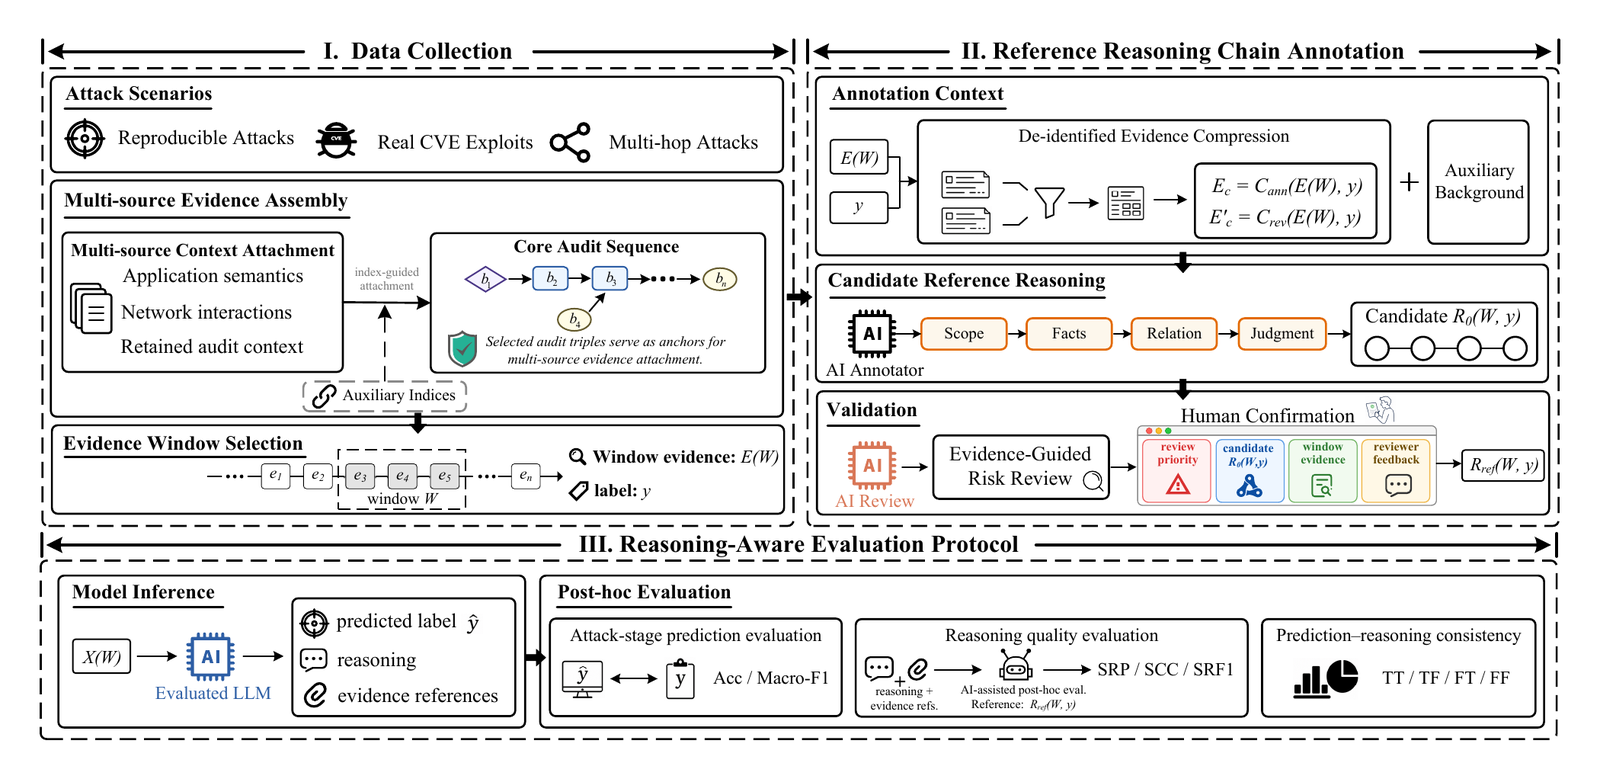
図1. SecLogの概要。Part Iはステージ01〜04に、Part IIは05のアノテーションおよびレビューワークフローに、Part IIIはSecLog-Bench-216を用いた05の評価ワークフローに対応します。
| 目的 | 開始点 | 環境 |
|---|---|---|
| 提供されたデータセットを読む、または再利用する | SecLog-Bench-216 と データ例 | 任意のJSONLリーダー。バリデータにはPython 3.11 |
| 提供されたベンチマークでモデルを評価する | クイックスタート | Python 3.11。同梱の推論ランナー用のAPIエンドポイントとキー |
| 新しいログを収集し、データセットまたはベンチマークを構築する | データ構築 | Ubuntu Linux、Python 3.11、Poetry、Docker、キャプチャツール |
詳細なシステムパッケージ、オプションコンポーネント、依存関係のバージョンはENVIRONMENT_DEPENDENCIES.mdに記載されています。
以下のコマンドはBashを使用し、プロジェクトルートから実行します。まず、分離されたPython 3.11環境を用意します:
python3.11 -m venv ../seclog-env
source ../seclog-env/bin/activate
以下のコマンドはPython標準ライブラリを使用しています。ログ収集、アノテーション、レビューUI、および追加の分析については、 環境ガイドを参照してください。
python 05_benchmark_annotation_review_evaluation/scripts/validate_public_benchmark.py
バリデータは、サンプル数、ID、ラベル分布、エビデンス参照、マニフェストハッシュをチェックします。検証に成功すると、JSON出力に validation_passed: true と sample_count: 216 が報告されます。
your-model-name を、お使いのプロバイダーがサポートするモデル識別子に置き換えてください:
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl
このコマンドは mode: preflight_no_api とプロンプト数を報告します。プロバイダーに接続したり、レスポンスファイルを作成したりすることはなく、プロバイダーが選択したモデルをサポートしているかどうかの検証も行いません。
シェル環境で OPENAI_API_KEY を設定し、以下のプレースホルダーをプロバイダーのキーに置き換えてから、API 呼び出しを明示的に有効化します:
export OPENAI_API_KEY="YOUR_API_KEY"
python 05_benchmark_annotation_review_evaluation/evaluation/run_benchmark_inference.py \
  --prompt-pack SecLog-Bench-216/data/prompt_pack.jsonl \
  --model your-model-name \
  --output ../seclog-runs/example/raw_responses.jsonl \
  --call-api
ランナーはOpenAI互換のチャットエンドポイントを使用します。デフォルトのベースURLは
https://api.openai.com/v1 です。別のエンドポイントには --base-url を、別のキー変数名には
--api-key-env を渡してください。この例のように、出力ディレクトリはリリースツリーの外に
保ってください。実行ごとに新しい出力パスを使用するか、既存のレスポンスファイルを継続するには
--resume を追加してください。
temperature、max_tokens、またはJSONモードを拒否するモデルを含む独自の推論システムを
使用するには、SecLog-Bench-216/data/prompt_pack.jsonl と
予測フォーマットを使用し、その後
生の出力を以下のノーマライザーに渡してください。
python 05_benchmark_annotation_review_evaluation/evaluation/normalize_stage_reasoning_predictions.py \
  --input ../seclog-runs/example/raw_responses.jsonl \
  --output ../seclog-runs/example/predictions.jsonl

python 05_benchmark_annotation_review_evaluation/evaluation/evaluate_stage_reasoning_predictions.py \
  --gold SecLog-Bench-216/data/gold_labels.jsonl \
  --reference-chains SecLog-Bench-216/data/reference_reasoning_chains.jsonl \
  --model-input SecLog-Bench-216/data/evidence_windows.jsonl \
  --sample-index SecLog-Bench-216/data/sample_index.jsonl \
  --predictions ../seclog-runs/example/predictions.jsonl \
  --output-dir ../seclog-runs/example/evaluation
結果には以下が含まれます:
| 出力 | 内容 |
|---|---|
predictions.jsonl | 正規化されたモデル予測 |
invalid_outputs.jsonl | 正規化に成功しなかった応答 |
evaluation/metrics_summary.json | 集計された評価指標 |
evaluation/per_sample_results.jsonl | サンプルごとの結果 |
evaluation/confusion_matrix.csv | ステージ予測の混同行列 |
evaluation/per_stage_metrics.csv | ステージ別の指標 |
evaluation/error_cases.jsonl | エラー分析用に保持されたケース |
この評価器における参照/証拠の重複は診断的なものです。正式な 推論品質スコアリングには、 事後推論品質 にある追加のチェックリストとアシスタントレビューのワークフローが必要です。
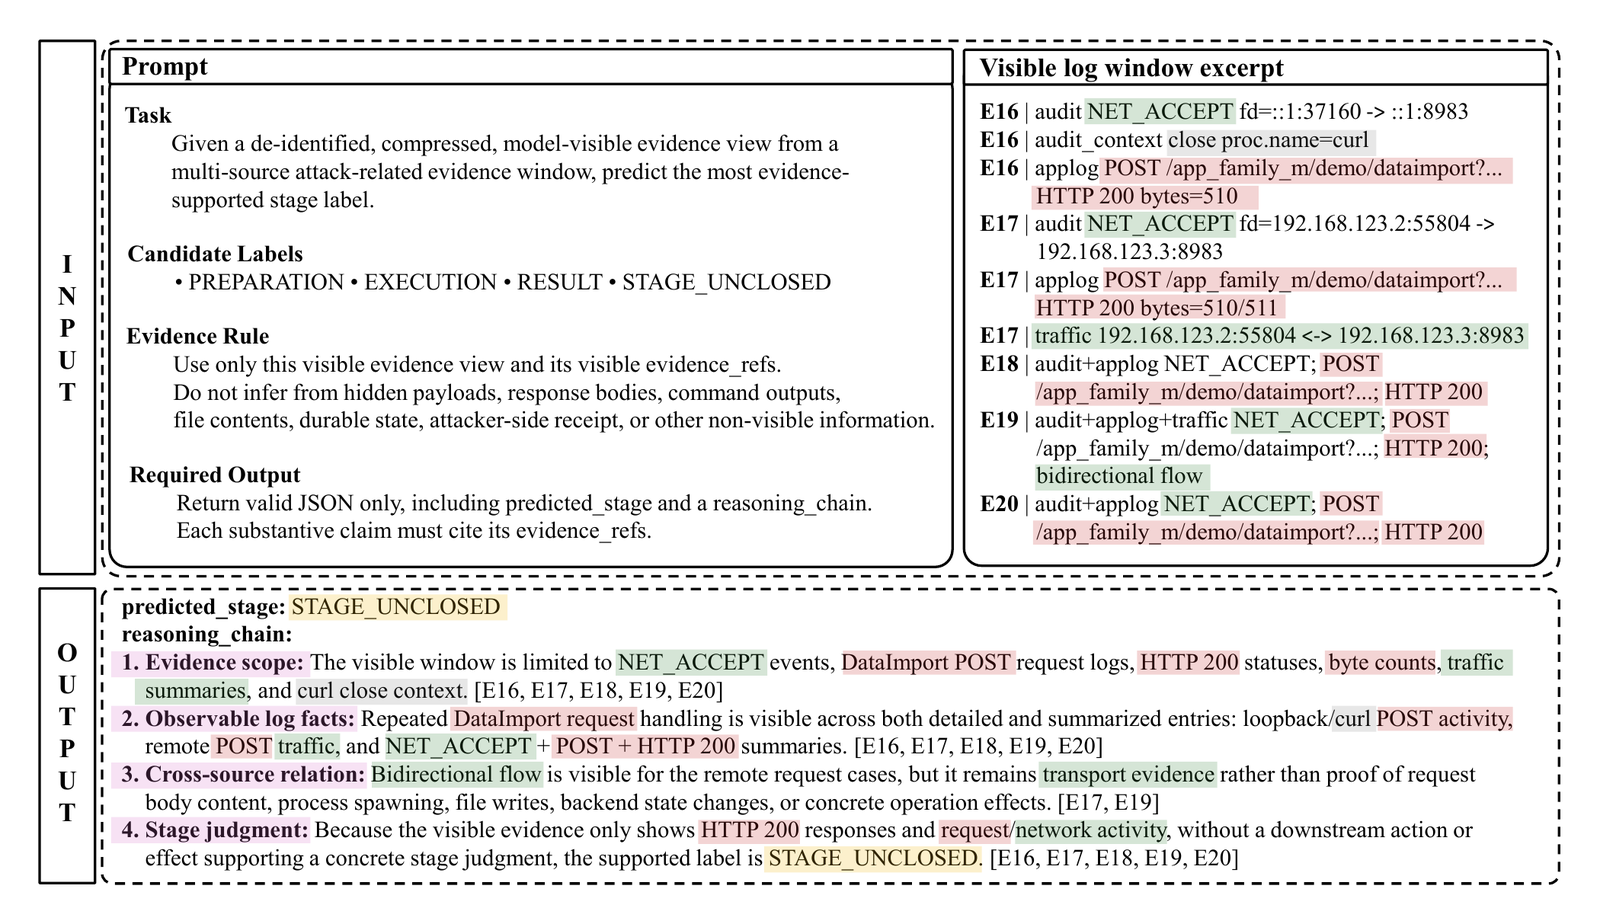
図2. 例示的な例。公開ファイルでは、ステージラベルは小文字(例:stage_unclosed)であり、証拠参照はサンプルローカルのedge_id値を使用します。
ベンチマークはJSONLを使用します。各行は1つのJSONオブジェクトであり、
sample_idによってファイル間で結合されます。
SecLog-Bench-216/data/ 配下のファイル | 役割 |
|---|---|
evidence_windows.jsonl | 選択されたチェーンと付随するコンテキストを含む、モデルに可視の証拠 |
prompt_pack.jsonl | モデル推論用に準備されたメッセージ |
gold_labels.jsonl | 評価に使用されるレビュー済みラベル |
reference_reasoning_chains.jsonl | レビュー済みの参照主張と証拠参照 |
sample_index.jsonl | サンプルの順序とウィンドウのメタデータ |
dataset_manifest.json | データセットのメタデータ |
例えば、これはsample_000001の証拠からの省略された抜粋です。
他のエッジ、コンテキスト、メタデータはここでは省略されています。
推論には完全なレコードまたは準備済みプロンプトを使用してください。
{
  "sample_id": "sample_000001",
  "window": {
    "start_seq": 10,
    "end_seq": 14
  },
  "selected_spine": [
    {
      "seq": 10,
      "edge_id": "sample_000001_edge_000001",
      "subject": "proc_m",
      "relation": "PROCESS_FORK",
      "object": "proc_m"
    }
  ]
}
対応する実際のゴールドラベルレコードは次のとおりです:
{
  "sample_id": "sample_000001",
  "gold_stage": "preparation",
  "supportability_tier": "strong",
  "window": {
    "start_seq": 10,
    "end_seq": 14
  }
}
モデルは predicted_stage と、証拠を参照した reasoning_chain を
出力形式に従って返します。上記の正解ラベルは
参照用の回答であり、測定されたモデル予測ではありません。ラベルと参照推論は
テスト対象モデルのプロンプトに含めないでください。
4つのラベルにはそれぞれ 54 サンプル があります:
| ラベル | 意味 |
|---|---|
preparation | 可視の証拠が、具体的な攻撃操作の前の調査、確認、または位置取りを裏付けている |
execution | 可視の証拠が、攻撃に関連する具体的な操作を裏付けている |
result | 可視の証拠が、攻撃活動の下流の影響を裏付けている |
stage_unclosed | 証拠は攻撃に関連しているが、3つの段階のいずれかを安全に確定できない |
stage_unclosed は無害なラベルではありません。完全な定義は
ラベルスキーマにあります。
構築ワークフローは Python 3.11 を備えた Ubuntu Linux を対象としています。 構築環境の手順を使用して、 Docker Engine/Compose、Sysdig、Tshark/tcpdump、conntrack、nsenter、および必要な sudo/root キャプチャ権限を準備してください。
これらの前提条件とシナリオイメージを準備した後、stage-01 の Python 依存関係を インストールし、同梱のシーン入力を検証します:
