 jonathansalwan/vmprotect-devirtualization
VMProtect ソフトウェア保護をいじる。シンボリック実行と LLVM を使用した純粋関数の自動難読化解除。

VMProtect 3.x によって保護された純粋関数を脱仮想化するための 実験的な 動的アプローチ
VMProtect によって保護された純粋関数を脱仮想化する動的アプローチに関するメモを共有します。 このアプローチは、仮想化された関数が単一の基本ブロックのみを含む場合に非常に良い結果を示します (サイズに関係ありません)。これは、バイナリが算術演算を保護するときによくあるシナリオです。ただし、 対象の関数が複数の基本ブロックを含む場合、このアプローチはもう少し実験的です。 それでも、2つの基本ブロックを含むサンプルからバイナリコードを脱仮想化して再構築することに成功しました。 これは、小さな関数を動的に完全に脱仮想化することが可能であることを示唆しています。
VMProtect は、非標準アーキテクチャの仮想マシンを介してコードを実行することでコードを保護するソフトウェアプロテクションです。このプロテクションは、アセンブリ愛好家にとって素晴らしい遊び場です [0, 1, 2, 3, 4, 5, 6, 11]。また、このプロテクションを攻撃するツールはすでに多数存在します [7, 8, 9, 12, 13]。 2016年、私たちは Tigress ソフトウェア プロテクションソリューションを調査し、シンボリック実行とLLVMを使用してその仮想化を打破することに成功しました。このアプローチはDIMVA 2018 [10] で発表され、私はそれをVMProtectでテストしたいと考えました。すべてのバイナリで機能する魔法の解決策は存在しないことに注意してください。ターゲットと目的に応じて常にトレードオフがあります。 このささやかな貢献は、VMProtectによって仮想化された 純粋関数 に対する動的攻撃の一例を提供することを目的としています。動的攻撃の主な利点は、設計上、自己改変コード、キーやオペランドの暗号化など、VMProtectのいくつかの静的プロテクションを無効化できることです。
純粋関数とは、有限数の経路を持ち、副作用を持たない関数と見なします。入力は複数あっても、出力は1つだけです。以下は純粋関数の例です:```cpp int secret(int x, int y) { int r = x ^ y; return r; }
# アプローチ

我々は、難読化されたトレース T'(難読化されたコード P' からのもの)が、元のコード P の元の命令(元のコード内の T' に対応するトレース T)と、仮想マシン VM の命令を組み合わせたものであり、T' = T + VM(T) となるという重要な直感に依存しています。これらの命令の部分列 T と VM(T) を区別できれば、トレース T' から元のプログラム P の1つのパスを再構築できます。この操作を繰り返して仮想化されたプログラムのすべてのパスを網羅することで、元のプログラム P を再構築できます。私たちの実用的な例では、元のコードは有限数の実行可能パスを持ちます。これは、知的財産保護を伴う多くの状況に当てはまります。そのために、以下の手順を実行します。

1. 仮想化された関数とその引数を特定する
2. ターゲットのVMProtectトレースを生成する
3. VMPトレースをリプレイし、シンボリック式を構築して入力と出力の関係を取得する
4. シンボリック式に最適化を適用して、VMからの命令を可能な限り回避する
5. シンボリック表現をLLVM-IRにリフトして、ターゲットの新しい保護されていないバージョンを構築する

## 例1: 単純なビット演算

最初の例として、次の関数を取り上げます。2つの入力を受け取り、VMProtectによって保護された `x ^ y` を返します。```cpp
int secret(int x, int y) {
  VMProtectBegin("secret");
  int r = x ^ y;
  VMProtectEnd();
  return r;
}
まず、どの関数がVMProtectを使用しているか、そしてそれらの関数がいくつの引数を持つかを特定します。この例では、以下のようなものがあるかもしれません。
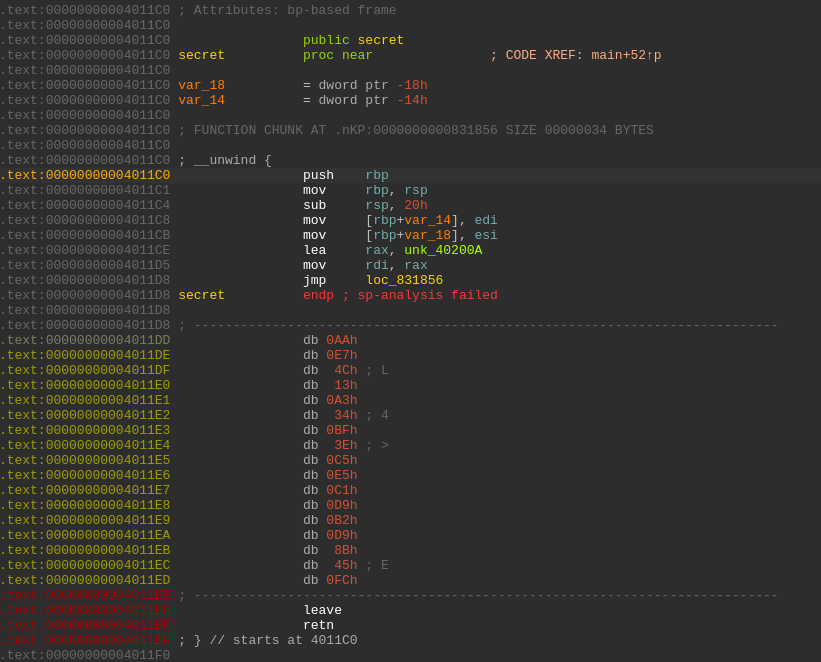
コードを読むだけで、関数がアドレス 0x4011c0 で始まり、32ビットの引数を2つ(edi と esi)持ち、
0x4011ef で戻ることがわかります。これで必要なリバースエンジニアリングはすべて完了です。次の部分は自動化されます。次に、
この仮想化された関数のトレース実行を生成する必要があります。そのために、Pintool を使用します。
これには、計測の範囲を表す start アドレスと end アドレス(この例では 0x4011c0 と 0x4011ef)だけが必要です。
どのような種類のDBIやエミュレータでもこの作業を行うことができることに注意してください。```
$ ./pin/pin -t ./pin/source/tools/VMP_Trace/obj-intel64/VMP_Trace.so -start 4198848 -end 4198895 -- ./vmp_binaries/binaries/sample2.vmp.bin 1 2 &> ./vmp_traces/sample2.vmp.trace
結果は[ここ](https://github.com/jonathansalwan/vmprotect-devirtualization/blob/main/vmp_traces/sample2.vmp.trace)で確認できます。トレース形式は、`mr`、`r`、`i` の3種類の操作を使用します。`mr` は命令 `i` によって行われるメモリ読み取りアクセスであり、`r` は CPU レジスタです。例えば:```
mr:0x7ffda459d718:8:0x227db4f8
r:0x40200a:0x0:0x7ffda459f571:0x2:0x40200a:0x0:0x0:0x7ffda459d688:0x0:0x0:0x7feee9b80ac0:0x7feee9b8000f:0xad1c3e:0x0:0x0:0x0
i:0x89173e:8:488BB42490000000
アドレス 0x7ffda459d718 から 8 バイトの定数 0x227db4f8 を読み込むメモリリードがあります。
命令はアドレス 0x89173e で実行され、その8バイト長のオペコードは 488BB42490000000 であり、
mov rsi, qword ptr [rsp + 0x90] です。
実行前のレジスタ状態は次のとおりです。```python
(1) RAX = 0x40200a (9) R8 = 0
(2) RBX = 0 (10) R9 = 0
(3) RCX = 0x7ffda459f571 (11) R10 = 0x7feee9b80ac0
(4) RDX = 0x2 (12) R11 = 0x7feee9b8000f
(5) RDI = 0x40200a (13) R12 = 0xad1c3e
(6) RSI = 0 (14) R13 = 0
(7) RBP = 0 (15) R14 = 0
(8) RSP = 0x7ffda459d688 (16) R15 = 0
VMPトレースが生成されたら、[attack_vmp.py](https://github.com/jonathansalwan/vmprotect-devirtualization/blob/main/attack_vmp.py) スクリプトを使用してそれをリプレイします。このスクリプトは
[Triton](https://github.com/jonathansalwan/Triton) を使用して、トレースの経路述語(path predicate)を構築します。シンボリック変数(関数の入力)を含むすべての式はシンボリックなまま保持され、入力に関係しない式はすべて具体化(concretized)されることに注意してください。言い換えれば、私たちのシンボリック式には、仮想マシンに関連する操作(マシン機構自体はユーザーに依存しない)は一切含まれず、元のプログラムに関連する操作のみが含まれます。

たとえば、以下は具体化の例です。左側には、シンボリック変数を含まない部分式(`1 + 2` と `6 ^ 3`)を含むASTがあります。したがって、これらの分岐は具体化され、定数 `3` と `5` に置き換えられ、右側のASTになります。**これがコードをデバーチャライズする方法です。**

<p align="center">
  <img src="https://assets.kitploit.com/production/public/readmes/8096/857ed50cfe9cb2347f816ece1d8dc4c13174c971dcb65ebc5621be14269a5ca8.png">
</p>

**式レベルの後方スライシングに関する注記**: シンボリック実行では一般的であるように、シンボリック表現はまず経路に沿って前方方向に計算され、その後、最終結果にも辿った経路にも影響を与えないすべての論理演算と定義がシンボリック式から削除されます(式スライシング、別名フォーミュラプルーニング)。これは、プログラム出力からの後方スライシングコード解析と同等の処理を式に対して実行することになります。したがって、`secret` 関数の戻り時点では、VMProtectの命令を含まない、入力と出力の関係式が得られます。

`./attack_vmp.py` スクリプトは、パラメータとしてトレースファイルとシンボリック変数のサイズを受け取ります。`edi` と `esi` でしたので、これらは4バイト長です。スクリプトの結果は次のとおりです。```
$ ./attack_vmp.py --trace1 ./vmp_traces/sample2.vmp.trace --symsize 4
[+] Replaying the VMP trace
[+] Symbolize inputs
[+] Instruction executed: 12462
[+] Emulation done
[+] Return value: 0x3
[+] Devirt expr: (bvor (bvnot (bvor (bvnot (bvnot x)) (bvnot y))) (bvnot (bvor (bvnot x) (bvnot (bvand (bvnot y) (bvnot y))))))
[+] Synth expr: (bvxor x y)

[+] LLVM IR ==============================

; ModuleID = 'tritonModule'
source_filename = "tritonModule"

define i32 @__triton(i32 %SymVar_0, i32 %SymVar_1) {
entry:
  %0 = xor i32 %SymVar_0, %SymVar_1
  ret i32 %0
}

[+] EOF LLVM IR ==============================
見てわかるように、secret 関数によって返される脱仮想化された式は非常に簡潔で、仮想マシンからの命令を
含んでいません。```smt
(bvor
(bvnot (bvor
(bvnot (bvnot x))
(bvnot y)
)
)
(bvnot (bvor
(bvnot x)
(bvnot (bvand
(bvnot y)
(bvnot y)
)
)
)
)
)
しかし、単純な `XOR` 演算である元の式を復元することはできませんでした。`XOR` はビット演算に
変換されたようです。幸いなことに、最近 Triton プロジェクトで新しい機能をリリースしました。それは
[synthesizer](https://github.com/JonathanSalwan/Triton/issues/1074) と [LLVM-IR](https://github.com/JonathanSalwan/Triton/issues/1078) へのリフターです。
これにより、式を合成すると、次の式が得られます
`(bvxor x y)`。これは大きな成果です。さらに、この式を LLVM-IR にリフトして、新しい非仮想化
バイナリコードをコンパイルできます。

## 例2: 保護された MBA 演算
