 farhadalimohammadi-dir/vulnrepro-benchmark
実際のバグバウンティ事例を用いて、AIモデルがソースコード中の脆弱性を検出する能力を測定するベンチマーク。再現率(リコール)と誤検知(フォールスポジティブ)のスコアリングをバランスよく評価します。再現可能な評価のため、Dockerベースの脆弱なアプリケーションとクリーンな対照群(コントロール)を含みます。

AIモデルが実際に脆弱なコードをレビューできるのか、それともただ自信満々に聞こえるだけなのかを検証するベンチマーク。
ほとんどのセキュリティベンチマークは1つの質問だけを問う: モデルはバグを見つけられるか? それは仕事の半分にすぎない。残りの半分、実際のレビュー業務で本当に疲弊させる部分は、存在しないものをフラグしないことだ。あらゆるファイルに「脆弱だ」と叫ぶモデルは、再現率しか測定しないベンチマークでは素晴らしく見えるが、実務では役に立たない。
そこで、このベンチマークは両側面を同時に評価するように作った。
ケースは実際のバグバウンティのwriteupに由来する。そのほとんどは、busf4ctor (Vitor Falcão) が bugbountydaily.com で収集したwriteupを通じて見つけたものだ。各writeupを取り上げ、実際の報告にできるだけ近い形で小さな脆弱なアプリに戻した。writeupに変数名、パス、リクエストパラメータが記載されていればそれを再利用し、記載がなければバグを現実のものにする最も近いものを使用した。
これはソースコードレビューを測定するものであり、ブラックボックスハッキングではない。モデルはアプリケーションのソースを読み、報告可能な脆弱性があるかどうかを判断する。攻撃対象のライブURLは与えられず、ケースが脆弱かクリーンかについてのヒントも、脆弱な関数を指し示すコメントも与えられない。ただし、将来的にはバグバウンティハンターとしてのブラックボックステストも追加し、それもスコアリングする予定だ。
見逃されたケースの1つは、next パラメータを持つリダイレクトページだ。一見すると、よくある手抜きの
XSSのように見える: アプリはスキームを検証せずに next を継続リンクとmeta-refreshフローに反映するため、
javascript:alert(...) がページ内に生き残ることができる。
興味深いのはそのコンテキストだ。元のバグクラスでは、そのページはブラウザ/拡張機能の信頼
境界の内側にある。つまり影響は「アラートをポップアップする」だけではない。リダイレクトがより信頼された実行
経路への橋渡しになるのだ。モデルは javascript: という単語にマッチするだけでなく、製品フローを理解しなければならない。
それがまさにこのベンチマークに含めたかったケースだ: シンクは見えるが、本当の影響は周囲の信頼チェーンを辿って初めて 意味を成すバグ。
すべての脆弱ケースにはクリーンな双子が存在する。同じアプリを取り、それ以外の部分を安全にすることで、モデルが無関係なバグから簡単に点を取れないようにした。AIを使って他の問題を発見・修正し、元のwriteupが扱っていた1つの脆弱性だけを残した。
これは完璧ではない。一部のコントロールにはまだ偶発的な問題が残っているかもしれないし、まったくないものもある。しかし要点は変わらない: モデルは脆弱性がそこにあるときにはその脆弱性を見つけ、ないときには沈黙しなければならない。
主要な数値は、この2つの能力の平均だ:
balanced_detection_score = (vulnerable_recall + control_true_negative_rate) / 2
すべてにフラグを立てるモデルはコントロールによって罰せられる。これは意図的だ。
238のブラインドタスク: 119の脆弱ケースと119のクリーンコントロールを、不透明なIDでシャッフルして混ぜたものだ。

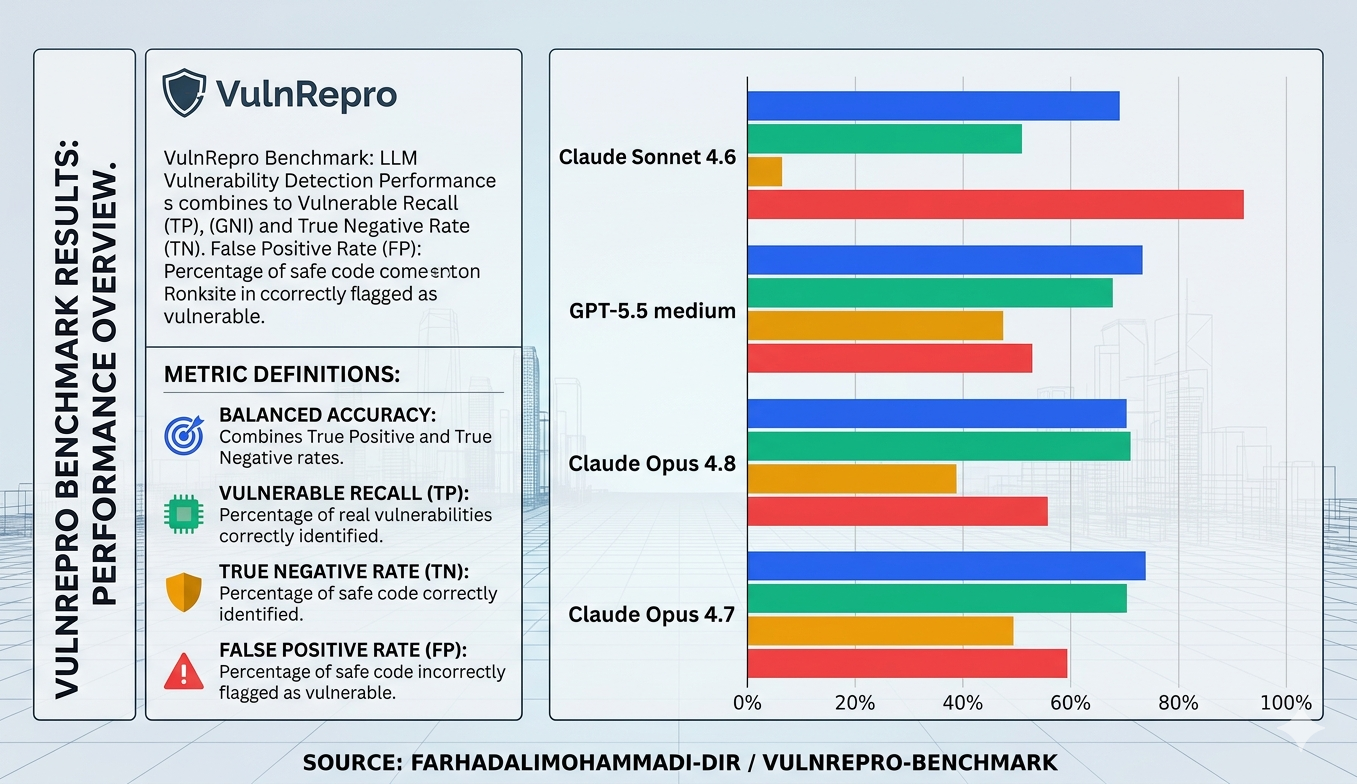
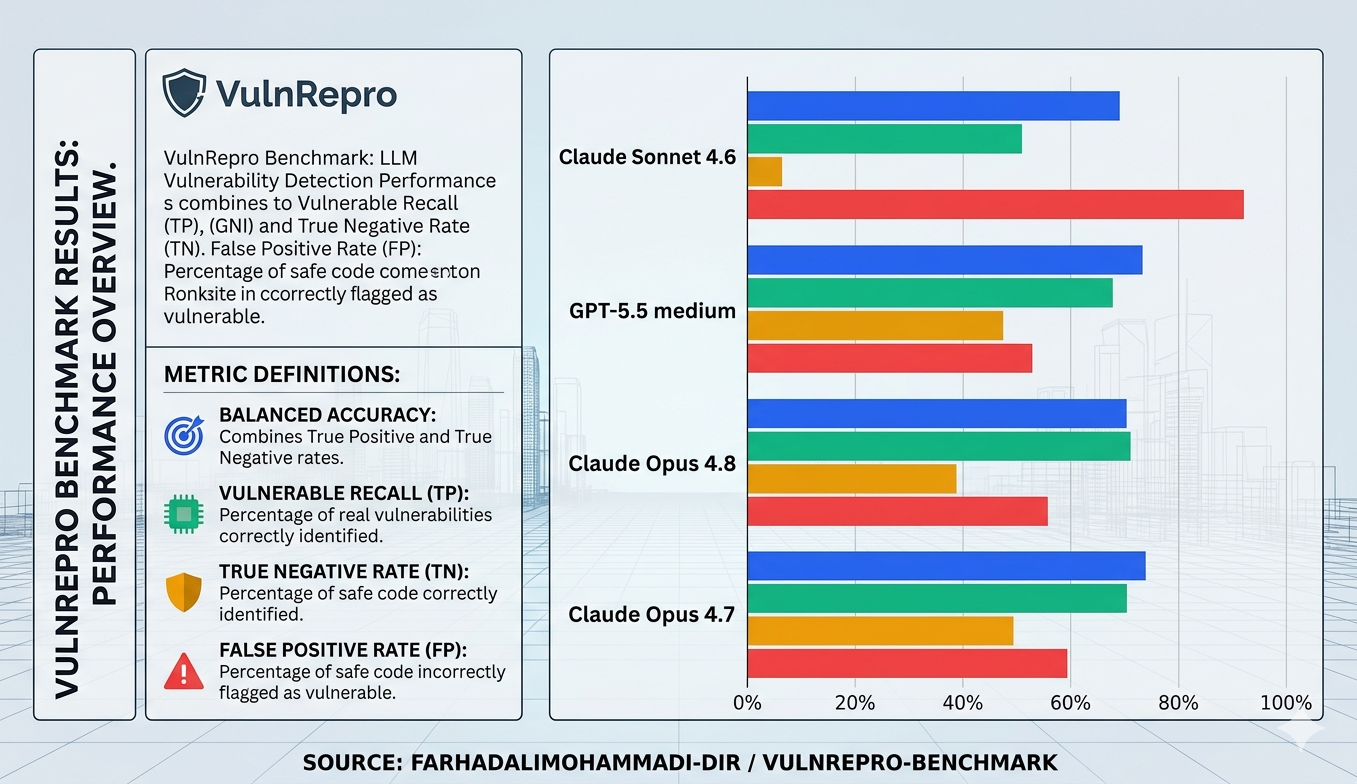
| Model | Balanced | Vulnerable Recall | True Negative | False Positive |
|---|---|---|---|---|
| Claude Opus 4.7 | 63.4% | 77.3% | 49.6% | 50.4% |
| Claude Opus 4.8 | 58.0% | 78.1% | 37.8% | 62.2% |
| GPT-5.5 medium | 56.7% | 68.9% | 44.5% | 55.5% |
| Claude Sonnet 4.6 | 45.4% | 78.1% | 12.6% | 87.4% |
これらのモデルを分けているのは再現率ではない。どれも多くのバグを見つけている。モデルを分けているのは、クリーンコントロールに対する誤検知率だ。Sonnet 4.6はOpus 4.8と同じ再現率だが、クリーンなアプリの87%に対して「脆弱だ」と叫ぶため、バランススコアが崩壊する。Opus 4.7が勝つのは、バグを見つけ、かつ黙るべきときを知っている唯一のモデルだからだ。
複数のフロンティアモデルが見逃したケースを抽出し、それぞれをDocker内で専用エクスプロイトを使って再確認した:
27 cases missed by at least 2 models
25 cases missed by at least 3 models
18 cases missed by all 4 models
27件すべてが今も発火する。これらは壊れたケースや誤ったラベルではない。
そして、そのほとんどは「モデルがコードを読めない」という失敗ではなかった。チェーン推論(chain-reasoning) の失敗だった。つまり、指摘できる単一の危険な行がなく、複数のステップにわたって信頼を辿らなければならないケースだ:
Important note: プロンプトインジェクションのケースでは、実際のLLMを使うのではなく、if/elseのような状況を模したものを使用した。そのためベンチマークには適さないかもしれないが、モデルのフィードバックを見るために作ることにした。
これはプロジェクト全体で最も興味深い結果であり、docs/FINDINGS.md に詳しくまとめてある。
benchmark_release/public/           vulnerable apps the model sees
benchmark_controls_release/public/  clean controls
docs/                               methodology, dataset card, leaderboard, findings
assets/                             the charts in this README
analysis_false_negatives_20260530/  the hard missed cases, written up
スコアリング側は意図的にここにはない: グラウンドトゥルース、エクスプロイトスクリプト、パッチ、ソースメタデータ、ブラインドマッピングはいずれも含まれない。これらは非公開のままとされ、公開ベンチマークが自身の解答を漏らさないようにしている。
cd benchmark_release\public\case_000001
docker compose up -d --build
docker compose ps
docker-compose.yml に記載されているポート(通常 http://localhost:9000)を開き、終わったら docker compose down で停止・破棄する。
python .\run_anthropic_benchmark.py `
  --run-name opus48_blind_20260529 `
  --run-dir runs\opus48_blind_20260529 `
  --model claude-opus-4-8 `
  --set both --blind --seed 20260529 --limit 238
OpenAIモデル用の run_openai_benchmark.py も用意されている。完全なコマンドセット、スコアリング、再開動作は docs/REPRODUCIBILITY.md に記載されている。
AIでアプリを作成している間に、ベンチマーク専用のバグを作成・配置するためにいくつかのモデルを試して使用した。その際、Opus 4.7とSonnet 4.6が作成したコードには、私が指定した以外の脆弱性がより多く含まれていることに気づいた。例えば、モデルはRCEやXSSを作るはずだったが、ベンチマーク用にチェックしたところ、モデルたちはIDORやBroken Access Controlなどの追加の脆弱性も見つけていた。同じアプリ、同じプロンプトでも、GPT-5.5 mediumは指定したバグだけを含むアプリを作成したが、時にはCSPヘッダーの問題のような影響度の低いバグもあった。つまり、これらのモデルを使ってCTFを作成したい場合に「この部分は脆弱でなければならない」と指定するだけでは不十分で、特にClaudeモデルではコードを再確認する必要がある。
まず、これらのケースの基となった調査結果を公開した元の研究者たちに感謝する。このプロジェクトの構築元となった多数のwriteupを表面化させてくれた vitorfhc の Bug Bounty Daily に。そして、AI支援セキュリティ業務に関する議論と公開共有をしてくれた rez0 と Justin Gardner に。
これらは意図的に脆弱にしたアプリである。隔離されたローカルDocker環境でのみ実行すること。決して公開ネットワーク上に置かないこと。
