 biniamf/ai-reverse-engineering
Ghidraを使用したAI支援リバースエンジニアリング

# Rev·Deck — Ghidra を用いた AI 支援リバースエンジニアリング

Rev·Deck は、ローカルで動作するシングルユーザー向け静的解析ワークステーションです。エビデンスを最優先する Web UI と、ヘッドレス Ghidra サービスで解析されたバイナリを対象とする LLM コパイロットを組み合わせています。関数、文字列、インポート、クロスリファレンス、限定されたコールグラフといった確定的なエビデンスを直接参照したり、事実主張には検査可能なエビデンスの引用を必須とする、範囲を限定した質問をアシスタントに行うことができます。

解析対象のバイナリが実行されることはありません。ブラウザはこの Flask アプリとのみ通信し、アプリは検証・型付けされたリクエストを Ghidra サービスにプロキシします。

## デモ

https://github.com/user-attachments/assets/fba14dc5-7ad5-4137-9349-ed824da64fbe

## クイックスタート(Docker)

```bash
cp .env.example .env      # API_BASE と MODEL_NAME を設定。必要な場合は API_KEY も設定
docker compose up --build
```

Docker Compose は補間のために `.env` を自動的に読み込みます。`API_BASE` または `MODEL_NAME` が欠けていると、起動前に失敗します。`API_KEY=not-used` はローカル/キーレスプロバイダーでは有効です。スタックは両方のサービスを起動します。http://127.0.0.1:5000 を開いてください。

Ghidra サービスのみを実行する場合:

```bash
docker pull biniamfd/ghidra-headless-rest:latest   # 最新イメージを確実に取得

docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:latest
```

再現性のあるピンを利用するには、`latest` の代わりにテスト済みリリースのダイジェストを使用してください:

```bash
docker run --rm \
  -p 127.0.0.1:9090:9090 \
  -v "$(pwd)/data:/data/ghidra_projects" \
  --security-opt no-new-privileges:true \
  biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3a8448d8ed969079b452306e806f36079c3ddd298f4a618d6e2f1442d
```

## 前提条件

- Docker および Docker Compose(クイックスタートの場合)、または Python 3.10+ と Node.js 18+(ソースから実行する場合)
- OpenAI 互換の LLM エンドポイント(ローカルまたはホスト)とモデル名
- 公開 Ghidra イメージ: `biniamfd/ghidra-headless-rest:latest`

## 必須環境変数

`.env.example` を `.env` にコピーし、必要事項を入力してください。完全なリストとデフォルト値は同ファイルを参照してください。

| 変数 | デフォルト | 意味 |
| --- | --- | --- |
| `API_BASE` | 必須 | OpenAI 互換のベース URL(http/https)。Compose は値がないと早期に失敗します。 |
| `API_KEY` | `not-used` | プロバイダーのキー。ログに記録されたりブラウザに送信されることはありません。`not-used` はキーレスのローカルプロバイダーで有効です。 |
| `MODEL_NAME` | 必須 | 設定されたエンドポイントが期待するモデル ID。Compose は値がないと早期に失敗します。 |
| `LLM_STREAM` | `auto` | ストリーミング転送: `auto`(ストリーム、出力前の互換性エラーが一度発生した場合はブロッキングにフォールバック)、`true`(常にストリーム)、`false`(常にブロッキング)。 |
| `GHIDRA_API_BASE` | `http://127.0.0.1:9090` | Ghidra サービスのベース URL。 |
| `GHIDRA_IMAGE` | `biniamfd/ghidra-headless-rest:1.2.1@sha256:971591a3...` | 不変ダイジェストでピン留めされたテスト済みリリース。`:latest` もこのダイジェストに解決されます。別のリリースをピン留めするには上書きします。 |
| `HOST` / `PORT` | `127.0.0.1` / `5000` | 開発サーバーのバインド。 |
| `MAX_UPLOAD_BYTES` | `104857600` | アップロードサイズの上限。 |
| `CHATS_DIR` | `webui/chats` | チャット履歴のディレクトリ。 |

## LLM プロバイダー

Rev·Deck は OpenAI SDK を通じて **OpenAI 互換の Chat Completions エンドポイント** と通信します。設定はすべて `API_BASE` / `API_KEY` / `MODEL_NAME` で行います。プロバイダー固有のヘッダー、パラメーター、モデルロジックはありません。ローカルの [Ollama](https://ollama.com) サーバー(`API_BASE=http://127.0.0.1:11434/v1`)、セルフホストの vLLM/llama.cpp/LM Studio エンドポイント、OpenAI 自身、または OpenRouter などのゲートウェイもすべて同様に動作します。

`.env` プロバイダー設定の例(プレースホルダーを使用し、実際のキーをコミットしないでください):

```dotenv
# Ollama
API_BASE=http://127.0.0.1:11434/v1
API_KEY=not-used
MODEL_NAME=qwen3:8b
```

```dotenv
# OpenRouter
API_BASE=https://openrouter.ai/api/v1
API_KEY=replace-with-your-key
MODEL_NAME=anthropic/claude-opus-4.8
```

```dotenv
# OpenAI
API_BASE=https://api.openai.com/v1
API_KEY=replace-with-your-key
MODEL_NAME=replace-with-a-supported-model-id
```

```dotenv
# LM Studio、vLLM、または llama.cpp(ポート/モデルはサーバーに合わせて調整)
API_BASE=http://127.0.0.1:1234/v1
API_KEY=not-used
MODEL_NAME=replace-with-the-served-model-id
```

デフォルト(`LLM_STREAM=auto`)では、アシスタントは**ストリーム**応答を要求し、トークンが到着するたびにブラウザに中継します。ストリーミングはキャンセル保証も強化します: 応答を停止したりタブを閉じたりすると、Rev·Deck はプロバイダーのストリームを直ちに閉じ、それ以上のツールやモデルのラウンドを実行しないため、バックグラウンドで完了まで実行されることなく、上流の生成が強制的に終了されます。

注意点:

- **課金**。キャンセルは当社側のストリームを即座に閉じますが、一部のホスト型プロバイダーは、早期のクライアント切断にかかわらず、すでに生成したトークン(または完了全体)に対して課金する場合があります。保証は*それ以上の作業を行わない*ことについてであり、プロバイダーの課金ポリシーについてではありません。
- **互換性**。すべての OpenAI 互換エンドポイントがツールを使用したストリーミングを受け入れるわけではありません。`auto` では、プロバイダーがコンテンツやツールコール出力の前にストリームリクエストを互換性エラー(HTTP 400/404/405/422)で拒否した場合、Rev·Deck は一度だけブロッキング呼び出しにフォールバックし、以降のプロセスでそれを記憶します。認証エラー(401/403)、レート制限(429)、サーバーエラー(5xx)は互換性の問題として扱われず、エラーとして表示され、サイレントに再試行されることはありません。ストリーミングを完全にスキップするには `LLM_STREAM=false` を、ストリーミングを必須にするには `LLM_STREAM=true` を設定してください(フォールバックなし)。

## 使い方

アプリを開き、バイナリをアップロードして解析ジョブを開始します。明らかにプレーンテキストのコンテンツは、Ghidra に送信する前に確認を求めます。実行可能形式ではなく意図的にファームウェア/データである場合にのみ、明示的な raw バイナリ上書きオプションを使用してください。解析が完了したら、2 つのワークスペースタブを切り替えます:

- **Analysis** — 確定的なエビデンスビュー: サマリー、関数(フィルター/ページネーション)、インポート、文字列、クエリビュー、関数インスペクター(疑似コード、クロスリファレンス、限定コールグラフ、16 進ダンプ)、そして接続された Ghidra サービスがサポートする場合には、型、グローバル、サイドカーアノテーション、アーカイブエクスポート、説明可能な肯定/緩和シグナルとエビデンスカバレッジを備えた確定的な Attack Surface ランキング。
- **Chat** — アシスタント。2 つのモードがあります:
  - **Copilot**(デフォルト): メッセージごとに 1 ステップ/ツールコールに制限。アドホックな質問向け。
  - **Autonomous**: 名前付きの予算制限付きワークフローを開始し、自律的に複数の制限されたステップを実行。作業中はライブアクティビティタイムラインを表示。

どちらのモードもタスクごとに**ステップ予算**を設定でき、**ステップ制限なし**オプションではタスクが完了するまで実行されます(それでも `MAX_STEP_BUDGET` で上限が設定されるため、ループするモデルが暴走することはありません)。実行が予算に達すると、部分的な結果を報告し、「**Continue**」を提供します。これは、完了したツールコールをやり直すことなく、すでに取得したエビデンスを使用して同じ会話を再開します。コストはツール/モデル呼び出しの回数に応じて増加するため、予算が高いほどコストが高くなります。

利用可能なワークフロー:

| ワークフロー | 目的 | ターゲット関数アドレスが必要 |
| --- | --- | --- |
| `program_triage` | メタデータ、インポート、文字列、関数からプログラムの推定目的を要約する。 | いいえ |
| `suspicious_behavior` | 最初に確定的な指標を表示し、その後、範囲を限定し明確にラベル付けされた仮説を提示する。 | いいえ |
| `selected_function` | 関数を逆コンパイルし、その呼び出し元/呼び出し先とともに説明する。 | はい |
| `call_chain` | 開始関数から、限定されたネイティブ/合成コールグラフの近傍を探索する。 | はい |
| `attack_surface_triage` | 確定的スコアのカバレッジ/Top-K を読み取り、その後最大 3 つの候補を深く調査する。スコアは優先度であり、判定ではない。 | いいえ |
| `vulnerability_hypothesis` | 1 つの限定された候補を選択し、エビデンス、反証、未解決の質問を提示する。決して自動確認はしない。 | いいえ |

### フォーカスされたサブ調査

各解析ジョブには、**Main** チャットに加えて、オプションのフォーカスされたサブスレッドがあります。**New sub-investigation** を選択し、1 行のブリーフィングを入力すると、同じバイナリと同一の読み取り専用ツールに対して、新しい会話コンテキストで作業できます。スレッド履歴は分離され、同時にストリーミングされるのは 1 つのスレッドのみです。

フォーカスされた作業が完了したら、**Return conclusion to parent** を選択します。Rev·Deck はそのサブスレッドのみに対して 1 回の制限付きモデル呼び出しを行い、そのエビデンス引用を検証し、証明マーク付きの結論カードを親に追加します。ブランチ全体は再開可能なままですが、親コンテキストにはコンパクトな結論のみが受け取られます(ブランチのトランスクリプトは受け取りません)。検証済み引用がないまま戻されたカードは、明示的に未検証とマークされます。

アシスタントの回答は、`[function:0xADDR]`、`[string:0xADDR]`、`[import:name]` のようにエビデンスをインラインで引用します。引用はそのターン中に実際に取得されたものと照合され、一致しない引用は「(未検証)」とフラグが立てられ、未確認の主張として扱う必要があります(事実ではありません)。

アシスタント出力内の Mermaid 図(コールグラフのスケッチなど)は、外部ネットワークアクセスのないサンドボックスフレームでレンダリングされます。

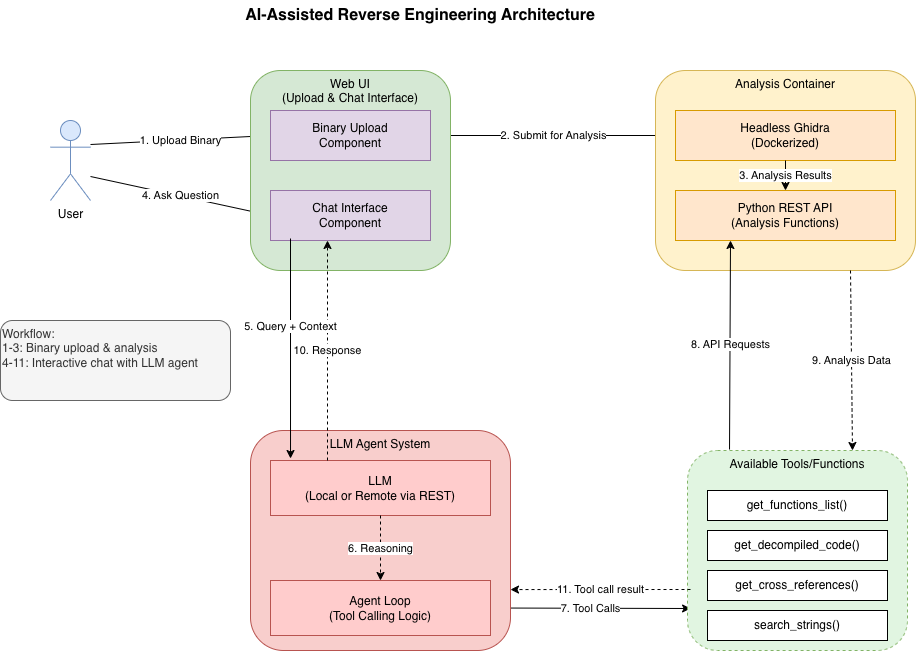
## アーキテクチャ

ブラウザは Rev·Deck Web アプリケーションとのみ通信します。Rev·Deck は設定された LLM とヘッドレス Ghidra サービスを調整し、結果のエビデンスとエージェントアクティビティを 1 つのワークスペースに表示します。

<img width="916" height="651" alt="Rev·Deck アーキテクチャ" src="https://assets.kitploit.com/production/public/readmes/9561/40809484745cf03bf42790c8abff0146755ebb953a3774c8fac17fbc3c0552de.png" />

## ソースからの実行

```bash
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
npm ci && npm run vendor        # 1 回のみ: 固定された Mermaid ランタイムをベンダリング

cp .env.example .env            # API_BASE / MODEL_NAME / API_KEY を編集
set -a; source .env; set +a     # 通常の Python は .env を自動的に読み込まない

# 別の Ghidra サービスを起動し、次に:
python webui/app.py
```

http://127.0.0.1:5000 を開いてください。Docker Compose は `.env` を自動的に読み込みますが、ソース実行の場合は上記のようにエクスポートする必要があります。Flask 開発サーバーはローカル使用には十分です。Docker イメージは Gunicorn を実行します。

## セキュリティ / ローカルオンリーの境界

これは、自分のマシン上で作業する信頼できる 1 人のアナリスト向けに設計されています。マルチユーザーや公開ホスティング向けではありません。デフォルトでは、アプリと Ghidra サービスは `127.0.0.1` のみにバインドされ、デバッグモードはオフ、アップロードされたバイナリは決して実行されず、LLM プロバイダーのキーはサーバーサイドに留まります。

## テスト

```bash
pip install -r requirements.txt -r requirements-dev.txt
python -m pytest
node --test "webui/static/js/tests/**/*.test.mjs"
npm ci && npm run vendor:verify   # ベンダリングされた Mermaid バンドルの整合性を検証
```

## トラブルシューティング

- **"Service offline" / `/readyz` が 503 を返す** — Ghidra サービスが `GHIDRA_API_BASE` で到達不能、または `API_BASE`/`MODEL_NAME` が未設定です。
- **Types/Globals/Annotations に "requires v1" と表示される** — 接続された Ghidra サービスがその機能を宣言していません。古いサービスでは想定内です。
- **チャットが即座にエラーになる** — `API_BASE`/`API_KEY`/`MODEL_NAME` を確認し、プロバイダーが `LLM_TIMEOUT` 内に到達可能であることを確認してください。
- **アップロードが大きすぎると拒否される** — `MAX_UPLOAD_BYTES` を増やしてください。
- **アップロードがプレーンテキストに見える** — Rev·Deck は Ghidra に送信する前に確認を求めます。意図的な場合のみ raw バイナリとして続行してください。
- **大規模解析がタイムアウトする** — Ghidra コンテナの `ANALYSIS_TIMEOUT` を増やし(例: 1 万以上の関数を含む C++/Android バイナリの場合は `5400`)、再アップロードしてください。`LLM_TIMEOUT` は関係ありません。
- **引用に "(未検証)" と表示される** — モデルが実際には取得していないエビデンスを引用しました。その主張は未確認の仮説として扱ってください。
