 andreyglauzer/vigilantonion
🐍 - Torネットワーク上のサイトをクロールし、キーワードを検索します。



torネットワーク上のサイトをクロールし、キーワードを検索します。
VigilantOnionは、サイバー脅威インテリジェンスチームがtorネットワーク上で実施する調査を監視し、最良の結果を得られるよう支援するために補完するツールです。
管理とダッシュボード作成にdjangoを使用した最初のバージョンでは、利用が非常に困難でした。この新しいバージョンでは、調査と、誤検知を排除するための手法が改善されています。
誤検知を排除し、正確性のレベルを向上させるために、私はyararuleとノートを使用し、最も関連性が高いと判断したルールには高い値を設定しています。以下の図に示すとおりです:
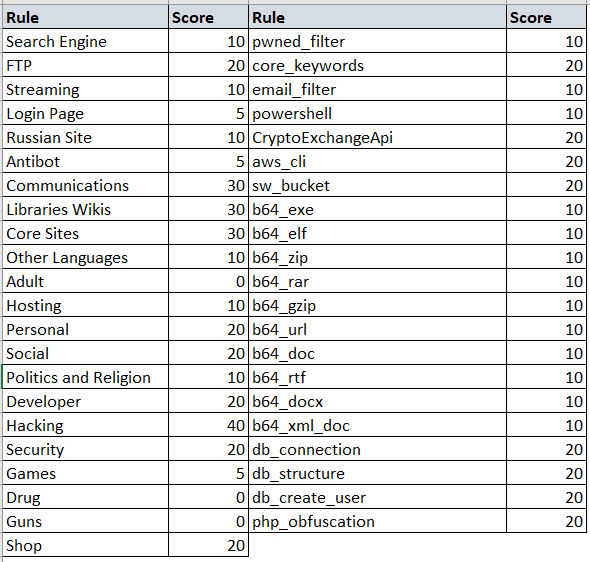
これらの値は動的であり、必要に応じて変更できます。
新しいyararuleはカテゴリファイルとキーワードファイルの両方に追加できるため、誤検知を排除し、より快適な結果を得ることができます。
設定ファイルで変更する必要がある項目はわずかですが、スクリプトを使用する上で非常に重要です。
以下のフィールドはtorネットワークプロキシを設定するためのものです。Windowsでスクリプトを実行している場合、ポートは通常9051に変わります。
server_proxy:  localhost
port_proxy:  9050
type_proxy:  socks5h
timeoutサーバーフィールドは、リクエストを待機する時間を決定するためのものです。時間が長いほど、スクリプトの実行に時間がかかる場合があります。
timeout: 30
scoreサーバーフィールドは、URLがクロールされsyslogに送信されるための最小スコア値を決定するためのものです。
score_categorie:  20
score_keywords:  40
一部のURLはオフラインになっており、復旧するかどうかを判断するのは困難です。そのため、最大試行回数を決定できるカウンターを作成しました。この回数に達すると、スクリプトはそのURLへのアクセスを試みなくなります。
count_categories: 5
URLがクロールされるたびに、その最後のスキャン日時とともに保存されます。同じURLに対して、あるスキャンと次のスキャンの間の日数制限を設定できます。
daystime: 10
そして最後に、私はもはやdjangoを使用していません。結果を表示するにはSplunkやELKなどのsyslogが必要であり、ここでそれらを定義するだけです。
sendlog:  True
logport:  5151
logip:  "localhost"
使用方法はよりシンプルです。torとPythonライブラリがインストールされている必要があるだけです。そのためには、以下のコマンドを実行してください:
pip install -r requirements.txt
torクライアントとライブラリをインストールした後、--helpコマンドを使用して使用方法の詳細を確認してください。
➜  python3 observer.py -h
usage: observer.py [-h] [--config CONFIG] [--crawler] [--url URL] [--search]
                   [--engines ENGINES] [--find FIND] [--pastebin PASTEBIN]

VigilantOnion is a script to collect as many sites from the onion network as
possible and add them to a database. With all possible sites collected, a
crawler will be created so that we can monitor the search for keywords defined
by you.

optional arguments:
  -h, --help            show this help message and exit
  --config CONFIG, -c CONFIG
                        Configuration file in yaml format
  --crawler             Starts the TOR network URL crawler process.
  --url URL, -u URL     Specifies the URL to crawl.
  --search              Start the URL search process on the surface. Select a
                        framework where you want to search for urls.
  --engines ENGINES, -e ENGINES
                        Validates the available engines for searching URLs.
  --find FIND, -f FIND  Search for arguments on .onion network research sites
  --pastebin PASTEBIN   Search for .onion urls in pastebin paste.

You can also develop new framework so that the database has more urls onions.
スクリプトを動作させるには新しいURLが必要であり、そのために以下の例のように表面を検索してURLを探すメソッドを作成しました:
python3.6 observer.py --config config/config.yml --search -e "gist,reddit,cybersecuritynews,discoverdarkwebservice"
以下の例のように、pastebin ファイルから直接URLを取得することもできます:
python3.6 observer.py --config config/config.yml --search --pastebin "s7TPZCKz,kSaYqtVX,0GYEEApe,3qkqyqiM,RfgBLg5Q,gtksBij4,FpPzQKHg,wB0uh00r,jDGJhQCC,q6DZ9U,ac2TnUjY,pv4xRWXQ,PgLUE7pF,9XW5Pc7R,hqyGMi7e,UZRM2z8y,7tQvV5CU,9JhVq3H3,Cb5HTydt,kMW5wp3N,v5Yq66sH,2q3SsR3a,gnd8jx97,QwSJYhYF,iNydrDfe"
いくつかのURLを収集したら、クローラープロセスを開始できます。 最初の実行が最も時間がかかることに注意してください。これは、ウェブサイトコンテンツの分類とカテゴリ化がそこで行われるためです。
python3.6 observer.py --config config/config.yml --crawler
単一のURLをクロールしたい場合は、以下を使用します:
python3.6 observer.py --config config/config.yml --crawler --url "76qugh5bey5gum7l.onion"
結果の出力はjsonであり、同じフォーマットで選択したsyslogに送信されます。
{
  "lastscan": "2020-06-29",
  "id": 10760,
  "type": "URI",
  "url": "lolitmhfkpif7sky.onion",
  "title": "Lolita Club",
  "baseurl": "vyqi2nm36otufrgg.onion",
  "status": "Online",
  "count_status": 0,
  "source": "Script",
  "categorie": [
    {
      "full_categorie": [
        "no_match"
      ],
      "score_categorie": 0
    }
  ],
  "keywords": [
    {
      "full_keywords": [
        "no_match"
      ],
      "score_keywords": 0
    }
  ],
  "discovery_date": "2020-06-29 14:24"
}
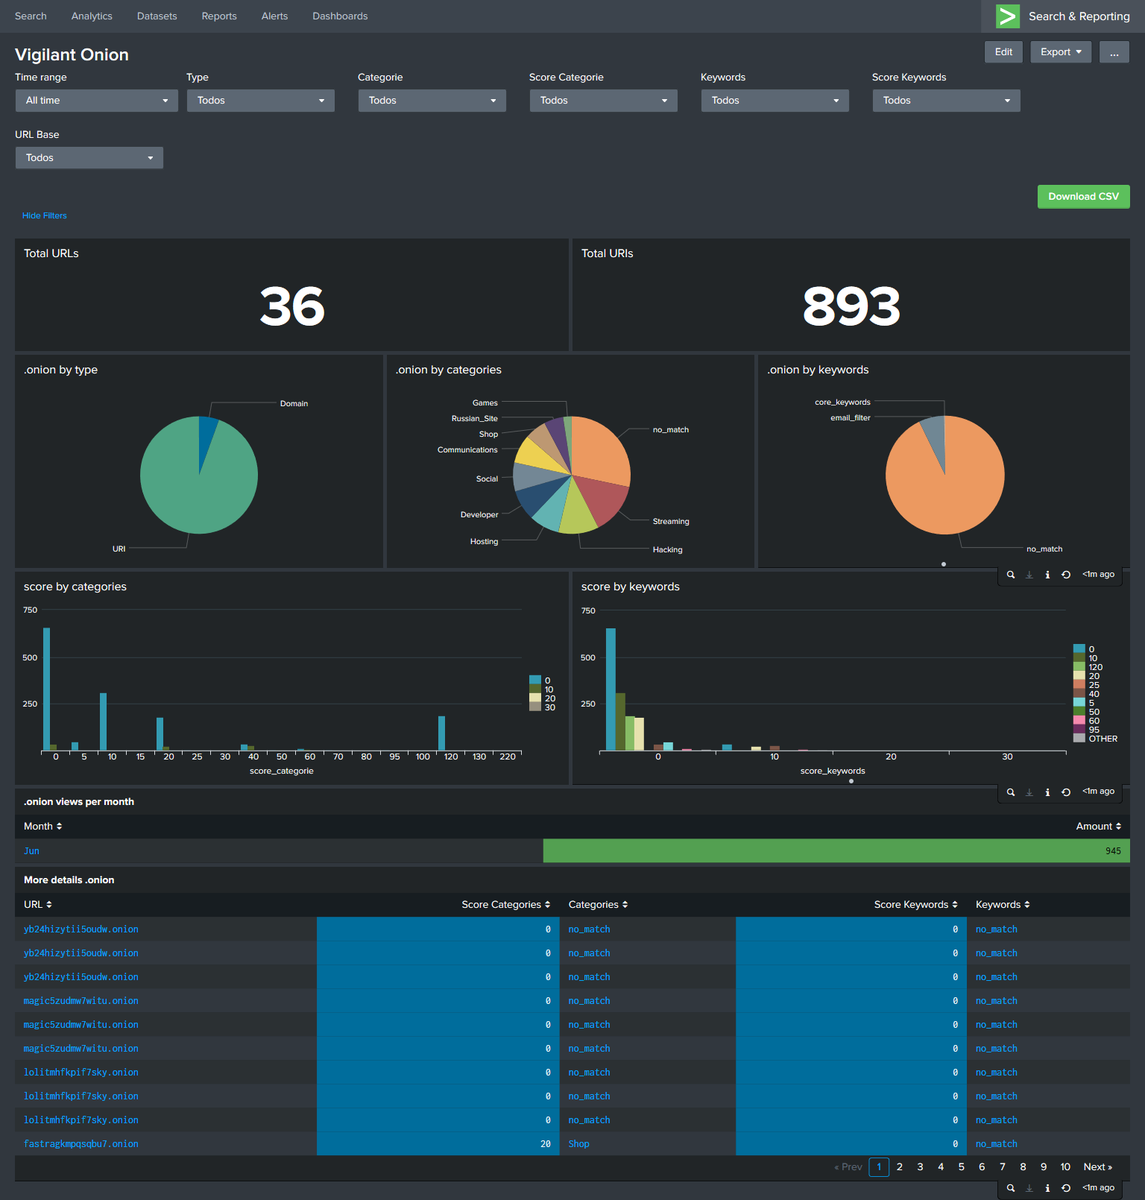
私はSplunkを使用しており、あなたのダッシュボードを私のものと同じように見せることができます:
プロジェクトに協力するために、自由にフォークするか、issueを開いてください。
