
darts v0.47.0
時系列データのユーザーフレンドリーな予測と異常検知のためのPythonライブラリ。
Pythonで時系列を簡単に




Darts は、時系列に対するユーザーフレンドリーな予測と異常検知のための Python ライブラリです。ARIMA のような古典的なものから深層ニューラルネットワークまで、さまざまなモデルを含んでいます。予測モデルはすべて、scikit-learn と同様に fit() と predict() 関数を使って同じ方法で使用できます。
このライブラリは、モデルのバックテスト、複数モデルの予測の組み合わせ、外部データの考慮も簡単にします。
Darts は単変量および多変量の時系列とモデルの両方をサポートしています。
ML ベースのモデルは、複数の時系列を含む潜在的に大規模なデータセットでトレーニングでき、一部のモデルは確率的予測を豊富にサポートしています。
Darts はまた、広範な異常検知機能も提供しています。 たとえば、PyOD モデルを時系列に適用して異常スコアを取得したり、Darts の予測モデルやフィルタリングモデルをラップして本格的な異常検知モデルを得ることは簡単です。
ドキュメント
高レベルな紹介
特定のトピックに関する記事
クイックインストール
まず、お気に入りのツール(conda、venv、virtualenv を virtualenvwrapper ありまたはなしで)を使って、Python 3.11+ のクリーンな Python 環境をプロジェクト用にセットアップすることをお勧めします。
環境がセットアップされたら、pip を使って darts をインストールできます:
pip install darts
詳細については、インストール手順を参照してください。
使用例
予測
Pandas DataFrame から TimeSeries オブジェクトを作成し、訓練用と検証用の系列に分割します:
import pandas as pd
from darts import TimeSeries

# Read a pandas DataFrame
df = pd.read_csv("AirPassengers.csv", delimiter=",")

# Create a TimeSeries, specifying the time and value columns
series = TimeSeries.from_dataframe(df, "Month", "#Passengers")

# Set aside the last 36 months as a validation series
train, val = series[:-36], series[-36:]
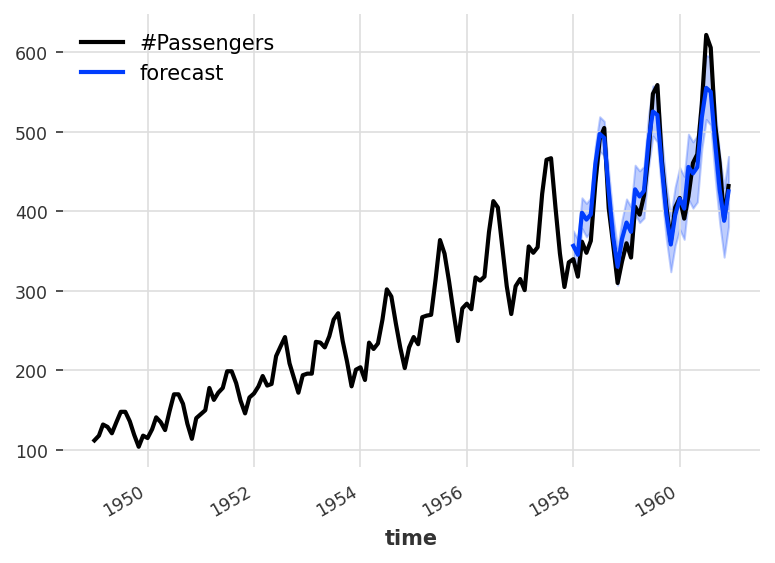
指数平滑モデルを適合させ、検証系列の期間にわたって(確率的な)予測を行います:
from darts.models import ExponentialSmoothing

model = ExponentialSmoothing()
model.fit(train)
prediction = model.predict(len(val), num_samples=1000)
中央値、5パーセンタイル、95パーセンタイルをプロットします:
import matplotlib.pyplot as plt

series.plot()
prediction.plot(label="forecast", low_quantile=0.05, high_quantile=0.95)
plt.legend()
異常検知
多変量系列を読み込み、トリミングし、2つのコンポーネントを保持して、訓練セットと検証セットに分割します:
from darts.datasets import ETTh2Dataset

series = ETTh2Dataset().load()[:10000][["MUFL", "LULL"]]
train, val = series.split_before(0.6)
k-means 異常スコアラーを構築し、訓練セットで学習させ、 検証セットで使用して異常スコアを取得します:
from darts.ad import KMeansScorer

scorer = KMeansScorer(k=2, window=5)
scorer.fit(train)
anom_score = scorer.score(val)
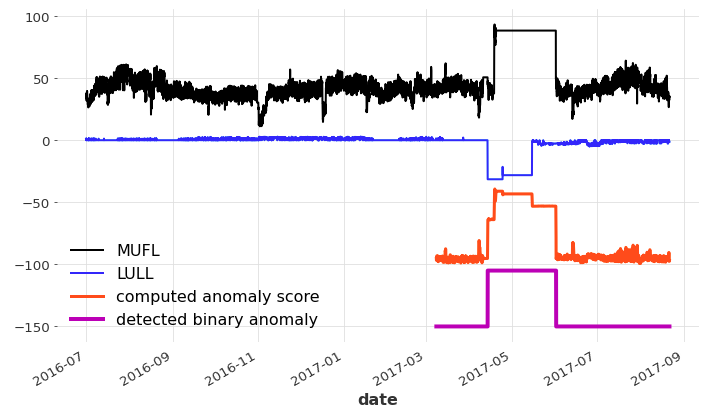
バイナリ異常検出器を構築し、trainスコアで学習させ、 その後validationスコアに対して使用してバイナリ異常分類を取得します:
from darts.ad import QuantileDetector

detector = QuantileDetector(high_quantile=0.99)
detector.fit(scorer.score(train))
binary_anom = detector.detect(anom_score)
プロット(一部の系列をシフトおよびスケーリングして、すべてが同じ図に表示されるようにする):
import matplotlib.pyplot as plt

series.plot()
(anom_score / 2. - 100).plot(label="computed anomaly score", c="orangered", lw=3)
(binary_anom * 45 - 150).plot(label="detected binary anomaly", lw=4)
特徴
-
予測モデル: 回帰タスクおよび分類タスク向けの予測モデルを多数収録。統計モデル( ARIMA など)から深層学習モデル(N-BEATS など)まで対応。以下に示す予測モデルを参照。
-
異常検知
darts.adモジュールには、異常スコアラー、 検出器、アグリゲーターが揃っており、これらを組み合わせて時系列の異常を検知できます。 Darts の予測モデルやフィルタリングモデルをラップして、予測値と実測値を比較する 本格的な異常検知モデルを簡単に構築できます。PyODScorerを使えば、PyOD の検出器を時系列に適用するのも容易です。 -
多変量サポート:
TimeSeriesは多変量、つまり単一のスカラー値ではなく 複数の時間変化する次元/列を持つことができます。多くのモデルが多変量系列を入力として受け取り、出力できます。 -
複数系列の学習(グローバルモデル): すべての機械学習ベースのモデル(すべてのニューラルネットワークを含む)は、 複数の(多変量の場合もある)系列で学習することをサポートしています。大規模なデータセットにもスケールできます。
-
確率的サポート:
TimeSeriesオブジェクトは(オプションで)確率的な 時系列を表現できます。これは例えば信頼区間を得るために使用でき、多くのモデルがさまざまな 確率的予測(パラメトリック分布や分位点の推定など)をサポートしています。 一部の異常検知スコアラーも、これらの予測分布を活用できます。 -
Conformal Prediction サポート: 当社の conformal prediction モデルは、 任意の事前学習済みグローバル予測モデルに対して、キャリブレーションされた分位点区間を伴う確率的予測を生成できます。
-
過去および未来の共変量サポート: Darts の多くのモデルは、予測を生成するための入力として、 過去に観測された共変量および/または未来に既知の共変量(外部データ)の時系列をサポートしています。
-
静的共変量サポート: 時間依存データに加えて、
TimeSeriesは各次元の 静的データも保持でき、一部のモデルでこれを活用できます。 -
階層的整合: Darts は整合(reconciliation)を行うためのトランスフォーマーを提供しています。 これにより、基盤となる階層を尊重する形で予測を合計できるようにできます。
-
回帰モデル: 対象系列と共変量のラグ値の関数として予測を得るために、 scikit-learn 互換の任意のモデルをプラグインできます。
-
サンプル重み付き学習: すべてのグローバルモデルはサンプル重み付きでの学習をサポートしています。 各観測値、予測タイムステップ、対象列に適用できます。
-
予測開始のシフト: すべてのグローバルモデルは、シフトされた出力ウィンドウでの学習と予測をサポートしています。 これは例えば Day-Ahead Market の予測や、共変量(または対象系列)が 遅延して報告される場合に有用です。
-
説明可能性: Darts は SHAP 値を用いて一部の予測モデルを説明する機能を持っています。
-
データ処理: 時系列データに対する一般的な変換(スケーリング、欠損値の補完、差分、boxcox など)を 簡単に適用(および元に戻す)するためのツール。
-
メトリクス: 時系列の適合度を評価するための多様なメトリクス。 R2 スコアから Mean Absolute Scaled Error まで。
-
バックテスト: 移動時間ウィンドウを用いて過去の予測をシミュレートするためのユーティリティ。
-
PyTorch Lightning サポート: すべての深層学習モデルは PyTorch Lightning を用いて実装されており、 カスタムコールバック、GPU/TPU トレーニング、カスタムトレーナーなどをサポートしています。
-
MLflow 統合: Darts 予測モデルの実験の自動トラッキング、比較、永続化のための MLflow との統合。 例については MLflow クイックスタートノートブックを参照。
-
フィルタリングモデル: Darts は
KalmanFilter、GaussianProcessFilter、MovingAverageFilterの 3 つのフィルタリングモデルを提供しており、時系列をフィルタリングでき、 場合によっては基盤となる状態/値の確率的推論を得ることもできます。