

Guardrails v0.24.1
LLMチャットアプリ向けのプログラム可能なガードレール:入出力レールの適用、ジェイルブレイクとプロンプトインジェクションのブロック、ハルシネーションの検出、機密データのマスキング。
NVIDIA NeMo Guardrails ライブラリ





ドキュメント · クイックスタート · ユースケース · 統合 · ガードレールカタログ · サンプル · コミュニティ · セキュリティ · リリース · 変更履歴
NeMo Guardrails は、LLM およびエージェント型アプリケーションにプログラム可能な安全性とセキュリティの制御を適用するためのオープンソースライブラリです。エージェントはコマンドを実行し、API を呼び出し、データを照会し、ウェブを読み取ります。対話型アプリケーションは入力と出力のチェックを適用し、検索拡張生成(RAG)システムは取得したコンテンツをフィルタリングし、回答を根拠と照合して検証します。
NeMo Guardrails ライブラリを使用すると、各エージェントがポリシー内で実行できることを宣言でき、低レイテンシのローカルルールと、ジェイルブレイク、注入された指示、安全でないツール呼び出しに対するモデルベースのチェックを組み合わせることができます。アプリケーションまたはエージェントハーネスがこれらのチェックを実行し、その結果を使用して処理を続行するかどうかを決定します。
pip install nemoguardrails
Python 3.11~3.13 が必要です。オプションパッケージとセットアップについてはインストールガイドを参照してください。
[!NOTE] バージョン 0.25.0 では
LLMRailsが非推奨となり、削除は 0.27.0 以降を予定しています。新しい統合にはGuardrailsを使用し、移行ガイドに従ってください。
構築できるもの
- AI エージェントとコーディングアシスタント: tool rails で提案されたツール呼び出しと返された結果をチェックするか、hooks サーバー経由でエージェントを接続します。
- 対話型アプリケーション: 入力と出力のチェックを適用します。
- 検索拡張生成 (RAG): 取得したコンテンツ内の機密データを検出またはマスクし、回答が根拠に基づいているかをチェックします。
仕組み
NVIDIA NeMo Guardrails ライブラリを使用して、使用するレール、モデル、プロンプトを指定する設定ファイルでポリシーを定義します。 ライブラリを Python アプリケーション内で実行するか、サーバーとしてデプロイします。 アプリケーションがモデルリクエストをどのように管理するかに応じて、チェックモードまたはプロキシモードを選択します。
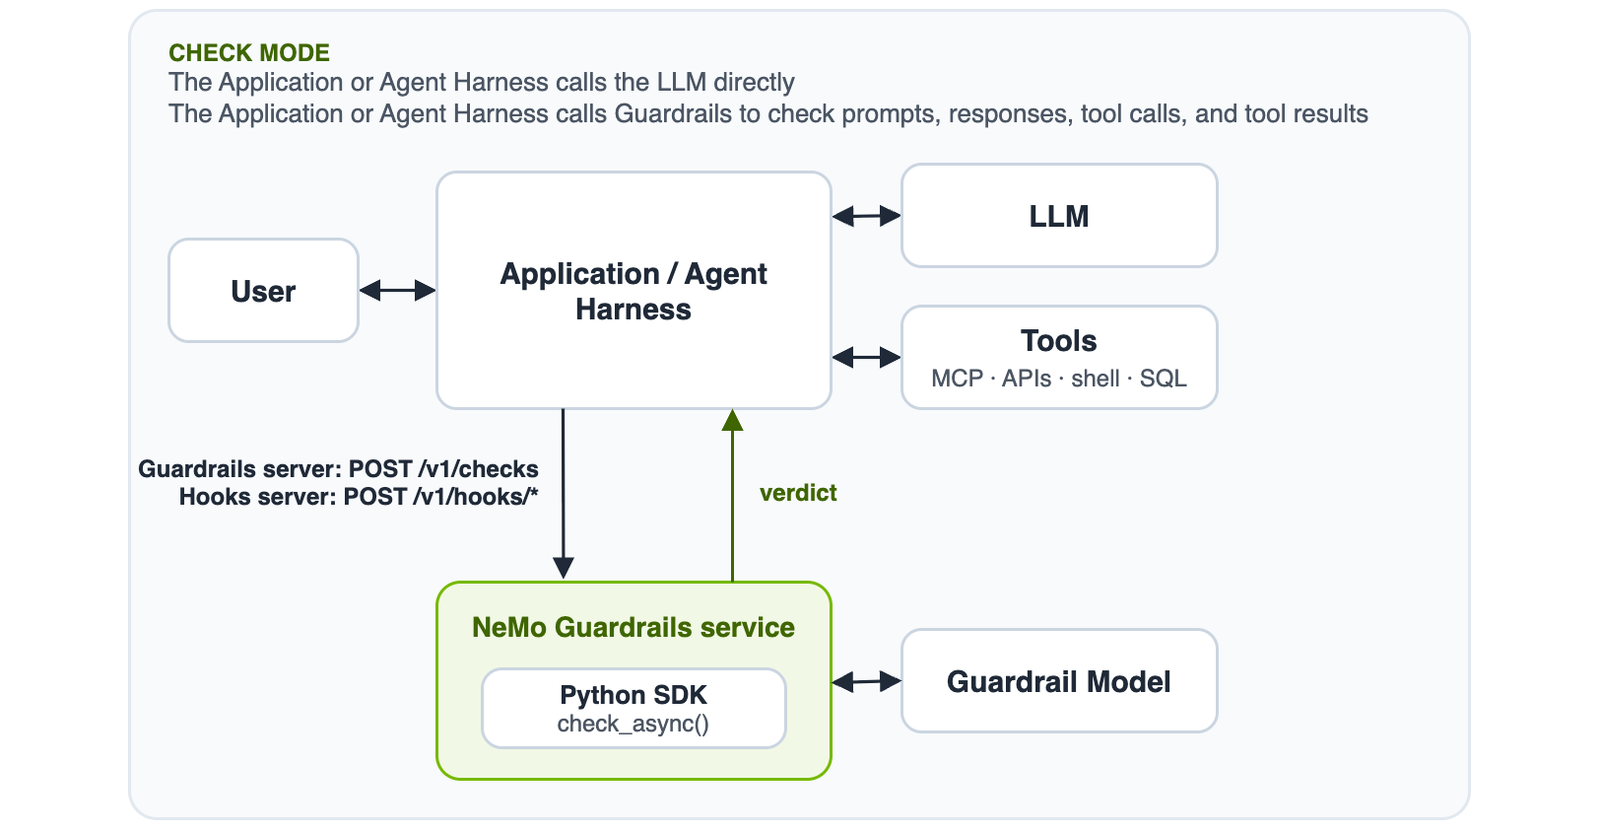
チェックモード
アプリケーションまたはエージェントハーネスが LLM を呼び出し、ツールを直接実行します。 ポリシー判断が必要な各ポイントで、関連するプロンプト、モデル応答、ツール呼び出し、またはツール結果をライブラリに送信してチェックします。 ツールを実行する前、応答を返す前、またはツール結果をモデルに渡す前に、結果を使用してブロックまたは変更されたコンテンツを処理します。
Python では check_async()、Guardrails サーバーでは POST /v1/checks、コーディングエージェントでは hooks サーバーを使用します。
check_async() でツールチェックを行うには、IORails エンジンを使用し、rail_types に RailType.TOOL_CALL または RailType.TOOL_RESULT を指定します。
ツール呼び出しは実行前に、ツール結果は実行後にチェックします。
プロキシモード
設定された入力レールと出力レールを適用するために、モデルリクエストをライブラリ経由でルーティングします。 入力レールは、リクエストがアプリケーションの LLM に到達する前にブロックできます。 非ストリーミングリクエストの場合、出力レールはライブラリが応答を返す前にチェックします。 ブロックされたコンテンツは、統合と設定に応じて拒否またはエラーを生成します。
Python では generate_async() または stream_async()、Guardrails サーバーでは POST /v1/chat/completions を使用します。
ツールはアプリケーションが実行します。サポートされている統合では、モデル応答内のツール呼び出しと後続リクエスト内のツール結果をチェックできます。
ゲートウェイサーバーも POST /v1/chat/completions と POST /v1/responses をサポートしますが、組み込みプロファイルはツールコンテンツをサポートしていません。
ゲートウェイの各 /v1/responses リクエストには "store": false を含める必要があります。
stream_async() で出力ストリーミングが有効な場合、デフォルトの stream_first: true 設定ではチャンクをチェックする前に配信します。
各チャンクを配信前にチェックするには、rails.output.streaming.stream_first: false を設定します。
設定の詳細については、出力レールのストリーミングを参照してください。
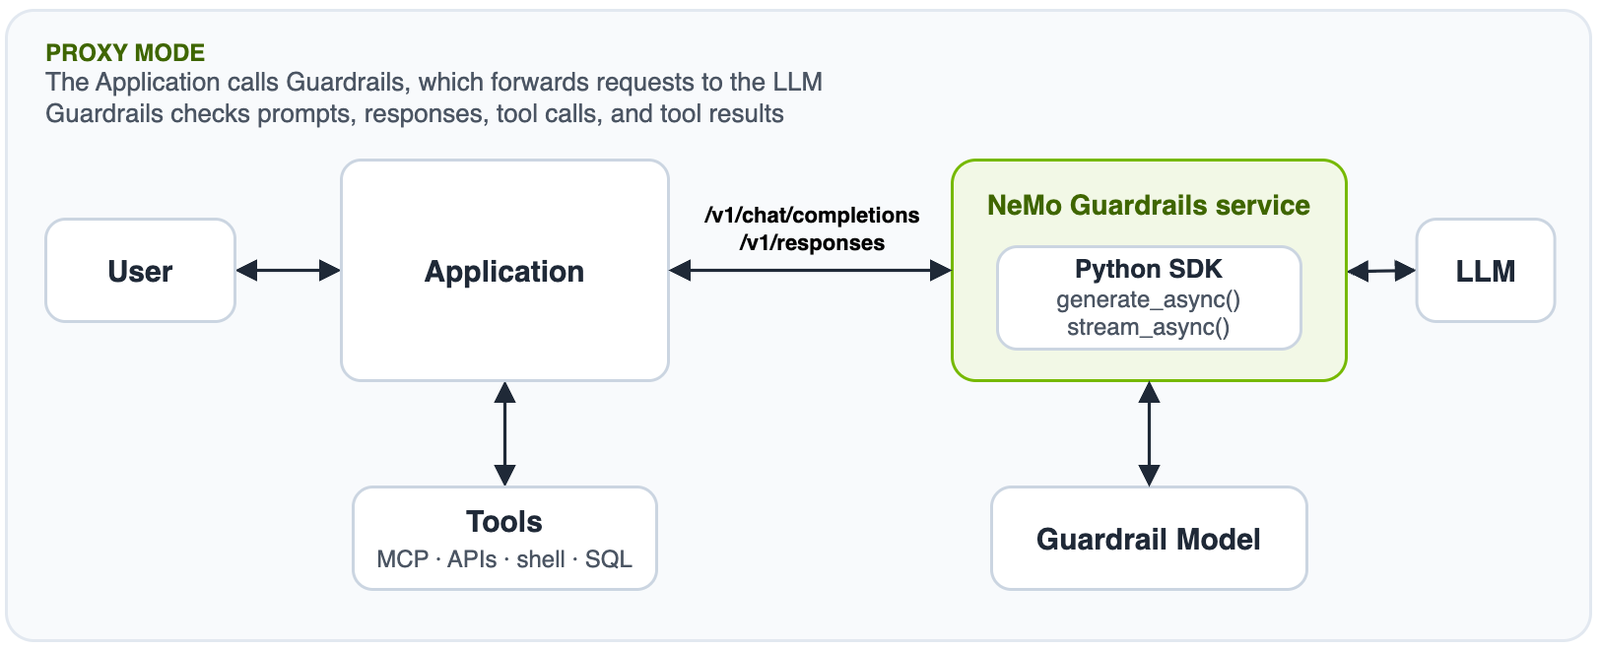
レイテンシは、設定されたルール、モデル、サービスによって異なります。 Rail のサポートはエンジンと統合によって異なります。 詳細は rail エンジンのサポート、設定、統合の選択 を参照してください。
NeMo Guardrails を選ぶ理由
- エージェントの動作を統制する。 実行前にツール名と引数スキーマを検証します。ツールの結果を確認し、モデルに返す前にツールごとのポリシーを適用します。
- モデルとエージェントループをそのまま維持する。 メインモデルの生成を伴わないチェック を使用して、既存のアプリケーションにガードレールを追加します。モデルベースのチェックは、設定されたモデルまたはサービスを引き続き呼び出します。
- 必要なポリシーを組み合わせる。 ローカルの regex ルールおよび CEL ルールを、安全性モデルやサードパーティのチェックと組み合わせます。
- ランタイムを接続する。 アプリケーション、共有サービス、またはコーディングエージェント向けの統合を選択します。
- オープンで、自由に実行可能。 このライブラリは Apache 2.0 ライセンスです。サポートされているモデルプロバイダーを選択し、ローカル検出器またはホスト型推論エンドポイントでチェックを実行します。
クイックスタート
サポートエージェントが提案した返金を、モデルや API キーを使わずに 500 ドルの上限に対してチェックします。 この例では、オプションの CEL 追加パッケージをインストールします:
pip install "nemoguardrails[cel]"
この例はツールの引数スキーマを検証し、上限を超える呼び出しをブロックします。これを拡張して check_refund.py として保存します:
完全な Python の例
import asyncio
import json

from nemoguardrails import Guardrails, RailsConfig
from nemoguardrails.rails.llm.options import RailStatus, RailType