




最新リリース / 開発バージョン: develop ブランチは最新の開発ツリーのトップを追跡しています。最新のリリースバージョンは 0.24.1 です。
✨✨✨
📌 NeMo Guardrails ライブラリの公式ドキュメントは docs.nvidia.com/nemo/guardrails で入手できます。
✨✨✨
NVIDIA NeMo Guardrails ライブラリは、LLM ベースの対話アプリケーションにプログラマブルなガードレールを簡単に追加するためのオープンソースツールキットです。ガードレール(略して「レール」)とは、政治について話さない、特定のユーザーリクエストに対して特定の方法で応答する、事前定義された対話パスに従う、特定の言語スタイルを使用する、構造化データを抽出するなど、大規模言語モデルの出力を制御する特定の方法です。
こちらの論文では NeMo Guardrails ライブラリを紹介し、システムの技術的概要と現在の評価について説明しています。
Python 3.10、3.11、3.12 または 3.13。
pip を使用してインストールするには:```bash
pip install nemoguardrails
詳細な手順については、[インストールガイド](https://docs.nvidia.com/nemo/guardrails/get-started/installation-guide)を参照してください。

## 概要

<!-- start-documentation-reuse -->

NeMo Guardrails ライブラリは、LLM ベースのアプリケーションを構築する開発者が、アプリケーションコードと LLM の間に**プログラマブルガードレール**を追加できるようにします。

<div align="center">
  <img src="https://raw.githubusercontent.com/NVIDIA-NeMo/Guardrails/develop/docs/_static/images/programmable_guardrails.png"  width="75%" alt="Programmable Guardrails">
</div>

*プログラマブルガードレール*を追加する主な利点は次のとおりです。

- **信頼でき、安全でセキュアな LLM ベースのアプリケーションの構築:** レールを定義して会話を導き、保護することができます。特定のトピックに対する LLM ベースのアプリケーションの動作を定義し、望ましくないトピックに関する議論に参加することを防ぐことができます。

- **モデル、チェーン、その他のサービスへの安全な接続:** LLM を他のサービス(別名ツール)にシームレスかつ安全に接続できます。

- **制御可能な対話**: LLM を誘導して事前定義された会話パスに従わせることができ、会話設計のベストプラクティスに従ってインタラクションを設計し、標準操作手順(例: 認証、サポート)を実施できます。

<!-- end-documentation-reuse -->

### LLM 脆弱性からの保護

NeMo Guardrails ライブラリは、ジェイルブレイクやプロンプトインジェクションなど、一般的な LLM 脆弱性から LLM を活用したチャットアプリケーションを保護するためのいくつかのメカニズムを提供します。以下は、このリポジトリに含まれるサンプル [ABC Bot](https://github.com/nvidia-nemo/guardrails/blob/develop/examples/bots/abc) に対して、さまざまなガードレール設定が提供する保護の概要サンプルです。詳細については、[LLM 脆弱性スキャン](https://docs.nvidia.com/nemo/guardrails/evaluation/llm-vulnerability-scanning.html)ページを参照してください。

<div align="center">
<img src="https://raw.githubusercontent.com/NVIDIA-NeMo/Guardrails/develop/docs/_static/images/abc-llm-vulnerability-scan-results.png" width="500">
</div>

### ユースケース

プログラマブルガードレールは、さまざまな種類のユースケースで使用できます。

1. 一連のドキュメントに対する**質問応答**(別名 Retrieval Augmented Generation): ファクトチェックと出力のモデレーションを実施します。
2. **ドメイン固有のアシスタント**(別名チャットボット): アシスタントがトピックから外れず、設計された会話フローに従うようにします。
3. **LLM エンドポイント**: カスタム LLM にガードレールを追加して、より安全な顧客とのやり取りを実現します。
4. **LangChain チェーン**(オプション): 任意のユースケースで LangChain を使用している場合、チェーンの周囲にガードレールレイヤーを追加できます。この統合を有効にするには、`NEMOGUARDRAILS_LLM_FRAMEWORK=langchain` 環境変数を設定するか、`set_default_framework("langchain")` を呼び出します。

### 使用方法

アプリケーションにプログラマブルガードレールを追加するには、Python API またはガードレールサーバーを使用できます(詳細については、[サーバーガイド](https://docs.nvidia.com/nemo/guardrails/get-started/integrate-into-application)を参照してください)。Python API の使用は、LLM を直接使用する場合と似ています。LLM の代わりにガードレールレイヤーを呼び出すには、コードベースへの最小限の変更のみが必要で、次の 2 つの簡単なステップが含まれます。

1. ガードレール設定を読み込み、`LLMRails` インスタンスを作成します。
2. `generate`/`generate_async` メソッドを使用して LLM を呼び出します。```python
from nemoguardrails import LLMRails, RailsConfig

# Load a guardrails configuration from the specified path.
config = RailsConfig.from_path("PATH/TO/CONFIG")
rails = LLMRails(config)

completion = rails.generate(
    messages=[{"role": "user", "content": "Hello world!"}]
)
サンプル出力:```json {"role": "assistant", "content": "Hi! How can I help you?"}
`generate` メソッドの入力および出力形式は、OpenAI の [Chat Completions API](https://platform.openai.com/docs/guides/gpt/chat-completions-api) と同様です。

#### 非同期 API

NeMo Guardrails ライブラリは、コアメカニズムが Python の非同期モデルを使用して実装されているため、非同期ファーストのツールキットです。パブリックメソッドには同期版と非同期版の両方があります。例えば、`LLMRails.generate` と `LLMRails.generate_async` です。

### サポートされている LLM

NeMo Guardrails は、OpenAI GPT-3.5、GPT-4、LLaMa-2、Falcon、Vicuna、Mosaic など、複数の LLM で使用できます。詳細については、設定ガイドの [サポートされている LLM モデル](https://docs.nvidia.com/nemo/guardrails/about-nemo-guardrails-library/supported-llms) セクションを参照してください。

### ガードレールの種類

NeMo Guardrails ライブラリは、主に 5 種類のガードレールをサポートしています。

<div align="center">
  <img src="https://raw.githubusercontent.com/NVIDIA-NeMo/Guardrails/develop/docs/_static/images/programmable_guardrails_flow.png"  width="75%" alt="Programmable Guardrails Flow">
</div>

1. **入力レール**: ユーザーからの入力に適用されます。入力レールは入力を拒否して以降の処理を停止したり、入力を変更したりできます(例: 潜在的に機密性の高いデータのマスク、言い換え)。

2. **対話レール**: LLM へのプロンプト方法に影響を与えます。対話レールは正規形メッセージに対して動作し(詳細は [Colang ガイド](https://docs.nvidia.com/nemo/guardrails/configure-guardrails/colang) を参照)、アクションを実行すべきか、次のステップや応答を生成するために LLM を呼び出すべきか、代わりに定義済みの応答を使用すべきかなどを決定します。

3. **検索レール**: RAG(Retrieval Augmented Generation)シナリオの場合に、検索されたチャンクに適用されます。検索レールはチャンクを拒否して LLM へのプロンプトに使用されるのを防いだり、関連するチャンクを変更したりできます(例: 潜在的に機密性の高いデータのマスク)。

4. **実行レール**: LLM によって呼び出される必要があるカスタムアクション(別名ツール)の入力/出力に適用されます。

5. **出力レール**: LLM によって生成された出力に適用されます。出力レールは出力を拒否してユーザーに返されるのを防いだり、出力を変更したりできます(例: 機密データの削除)。

### ガードレールの設定

ガードレール設定は、使用する **LLM** と **1 つ以上のガードレール** を定義します。ガードレール設定には、任意の数の入力/対話/出力/検索/実行レールを含めることができます。レールが設定されていない設定では、基本的にリクエストが LLM に転送されます。

ガードレール設定フォルダの標準的な構造は次のようになります。```
.
├── config
│   ├── actions.py
│   ├── config.py
│   ├── config.yml
│   ├── rails.co
│   ├── ...
config.yml には、LLM モデル、アクティブなレール、カスタム設定データなど、すべての一般的な設定オプションが含まれています。config.py ファイルにはカスタム初期化コードが含まれ、actions.py にはカスタム Python アクションが含まれています。完全な概要については、Configuration Guide を参照してください。
以下は config.yml の例です:```yaml
models:
rails:
input: flows: - check jailbreak - mask sensitive data on input
output: flows: - self check facts - self check hallucination - activefence moderation on input
config: # Configure the types of entities that should be masked on user input. sensitive_data_detection: input: entities: - PERSON - EMAIL_ADDRESS
ガードレール構成に含まれる `.co` ファイルには、さまざまな種類のレールを定義する Colang 定義(Colang の概要については次のセクションを参照)が含まれています。以下は、ユーザーへの挨拶のためのダイアログレールを定義する `greeting.co` ファイルの例です。```colang
define user express greeting
  "Hello!"
  "Good afternoon!"

define flow
  user express greeting
  bot express greeting
  bot offer to help

define bot express greeting
  "Hello there!"

define bot offer to help
  "How can I help you today?"
以下は、侮辱に対する対話レールのためのColang定義の追加例です:```colang define user express insult "You are stupid"
define flow user express insult bot express calmly willingness to help
### Colang

さまざまな種類のガードレールを構成および実装するために、このツールキットは **Colang** を導入しています。これは、柔軟でありながら制御可能な対話フローを設計するために特別に作成されたモデリング言語です。Colang は Python に似た構文を持ち、特に開発者にとってシンプルで直感的になるように設計されています。```{note}
Two versions of Colang, 1.0 and 2.0, are supported and Colang 1.0 is the default.
Colang 1.0 構文の簡単な紹介については、Colang 1.0 Language Syntax Guide を参照してください。
Colang 2.0 を始めるには、Colang 2.0 Documentation を参照してください。
NeMo Guardrails には、組み込みの guardrails のセットが付属しています。```{note} The built-in guardrails may or may not be suitable for a given production use case. As always, developers should work with their internal application team to ensure guardrails meets requirements for the relevant industry and use case and address unforeseen product misuse.
このライブラリには、LLMのセルフチェック(入力/出力モデレーション、ファクトチェック、ハルシネーション検出)、NVIDIAの安全性モデル(コンテンツ安全性、トピック安全性)、ジェイルブレイクおよびインジェクション検出、ならびにコミュニティモデルやサードパーティAPIとの統合のためのガードレールが含まれています。完全なリストについては、[Guardrails Library documentation](https://docs.nvidia.com/nemo/guardrails/user-guides/guardrails-library.html)を参照してください。

## CLI

NeMo Guardrailsライブラリには、組み込みのCLIも付属しています。```bash
$ nemoguardrails --help

Usage: nemoguardrails [OPTIONS] COMMAND [ARGS]...

actions-server    Start a NeMo Guardrails actions server.
chat              Start an interactive chat session.
evaluate          Run an evaluation task.
server            Start a NeMo Guardrails server.
NeMo Guardrails ライブラリの CLI を使用して、guardrails サーバーを起動できます。このサーバーは、指定されたフォルダから1つ以上の設定を読み込み、それらを使用するための HTTP API を公開できます。``` nemoguardrails server [--config PATH/TO/CONFIGS] [--port PORT]
例えば、`sample` 設定のチャット補完を取得するには、`/v1/chat/completions` エンドポイントを使用できます:```
POST /v1/chat/completions
--detect を指定して実行すると、検出のみが実行されます。detections.json に保存されます。id、title、severity、description、evidence、remediation、references、cwe、owasp、confidence、location が含まれます。--fail-on のしきい値に基づいて終了コードを決定します。--report を指定して実行すると、レポートが生成されます。report.json、report.md、report.html に保存されます。--report-format で指定した形式で生成されます。--config を指定して実行すると、設定ファイルが読み込まれます。--config で指定したパスから読み込まれます。KITPLOIT_CONFIG を指定すると、設定ファイルのパスが設定されます。KITPLOIT_LOG_LEVEL を指定すると、ログレベルが設定されます。KITPLOIT_OUTPUT_DIR を指定すると、出力ディレクトリが設定されます。KITPLOIT_FAIL_ON を指定すると、失敗時のしきい値が設定されます。0 は、スキャンが成功し、検出結果がしきい値を下回ったことを示します。1 は、スキャンが成功し、検出結果がしきい値を上回ったことを示します。2 は、スキャンが失敗したことを示します。3 は、設定エラーが発生したことを示します。kitploit --detect --fail-on high
kitploit --report --report-format html
kitploit --config config.yaml
このプロジェクトは、MIT ライセンスの下でライセンスされています。詳細については、LICENSE ファイルを参照してください。
コントリビューションは歓迎します。詳細については、CONTRIBUTING.md を参照してください。
セキュリティ上の問題を発見した場合は、SECURITY.md を参照してください。
このプロジェクトは、Contributor Covenant の行動規範に従っています。詳細については、CODE_OF_CONDUCT.md を参照してください。
このプロジェクトは、以下のオープンソースプロジェクトの上に構築されています。
サンプル出力:```json
{"role": "assistant", "content": "Hi! How can I help you?"}
guardrails サーバーを起動するには、Docker コンテナを使用することもできます。NeMo Guardrails ライブラリは、nemoguardrails イメージをビルドするために使用できる Dockerfile を提供しています。詳細については、Docker の使用セクションを参照してください。
LangChain 統合はオプトインです。有効にするには、NEMOGUARDRAILS_LLM_FRAMEWORK=langchain 環境変数を設定するか、set_default_framework("langchain") を呼び出します。次に、構成に必要な LangChain パッケージをインストールします。統合を有効にすると、LangChain チェーン(または任意の Runnable)を guardrails 構成でラップしたり、guardrails 構成内から LangChain チェーンを呼び出したりできます。詳細については、LangChain 統合ドキュメントを参照してください。
LLM ベースの対話型アプリケーションの安全性を評価することは複雑な作業であり、依然として未解決の研究課題です。適切な評価を支援するために、NeMo Guardrails ライブラリは以下を提供します:
nemoguardrails evaluate。トピカルレール、ファクトチェック、モデレーション(ジェイルブレイクおよび出力モデレーション)、ハルシネーションをサポートします。LLM ベースの対話型アプリケーションに guardrails を追加する方法は多数あります。例えば、明示的なモデレーションエンドポイント(OpenAI、ActiveFence、PolicyAI など)、批評チェーン(constitutional chain など)、出力の解析(guardrails.ai など)、個別の guardrails(LLM-Guard など)、RAG アプリケーション向けのハルシネーション検出(Got It AI、Patronus Lynx など)があります。
NeMo Guardrails ライブラリは、これらすべての補完的なアプローチを統合された LLM guardrails レイヤーに統合できる柔軟なツールキットを提供することを目指しています。例えば、このツールキットは ActiveFence、PolicyAI、AlignScore、LangChain チェーンとのすぐに使える統合を提供します。
私たちの知る限り、NeMo Guardrails ライブラリは、ユーザーと LLM 間の対話をモデル化するソリューションも提供する唯一の guardrails ツールキットです。これにより、一方では対話を正確な方法で誘導する能力が可能になり、他方では特定の guardrails をいつ使用すべきかについてきめ細かい制御が可能になります。例えば、特定の種類の質問に対してのみファクトチェックを使用するなどです。
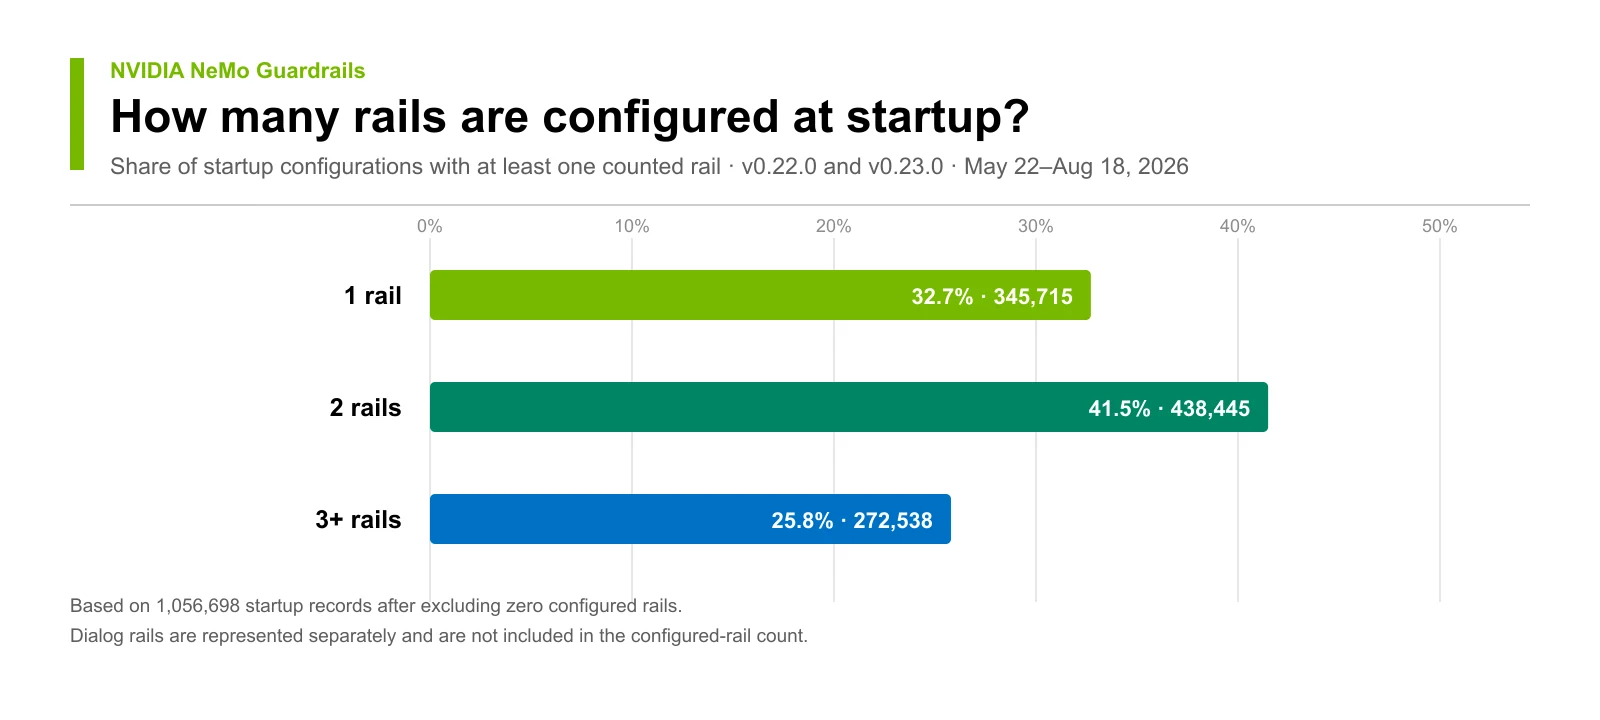
NVIDIA NeMo Guardrails ライブラリは、NVIDIA がどのデプロイメントパターンと安全機能が最も使用されているかを把握できるよう、匿名のテレメトリを収集します。このライブラリは、LLMRails、IORails、または Guardrails をインスタンス化すると 1 つの使用イベントを発行し、その後、プロセスごとに 1 つのデーモンスレッドから定期的なハートビートを発行します。このテレメトリは、リクエストごとのトレーシングとは別のものです。トレーシングは guardrails 構成で設定し、独自の可観測性バックエンドに送信します。テレメトリは NVIDIA への最小限の匿名 ping です。
正確な 0.22.0 および 0.23.0 リリースビルド全体にわたる匿名使用状況の集計、2026年5月22日~8月18日:
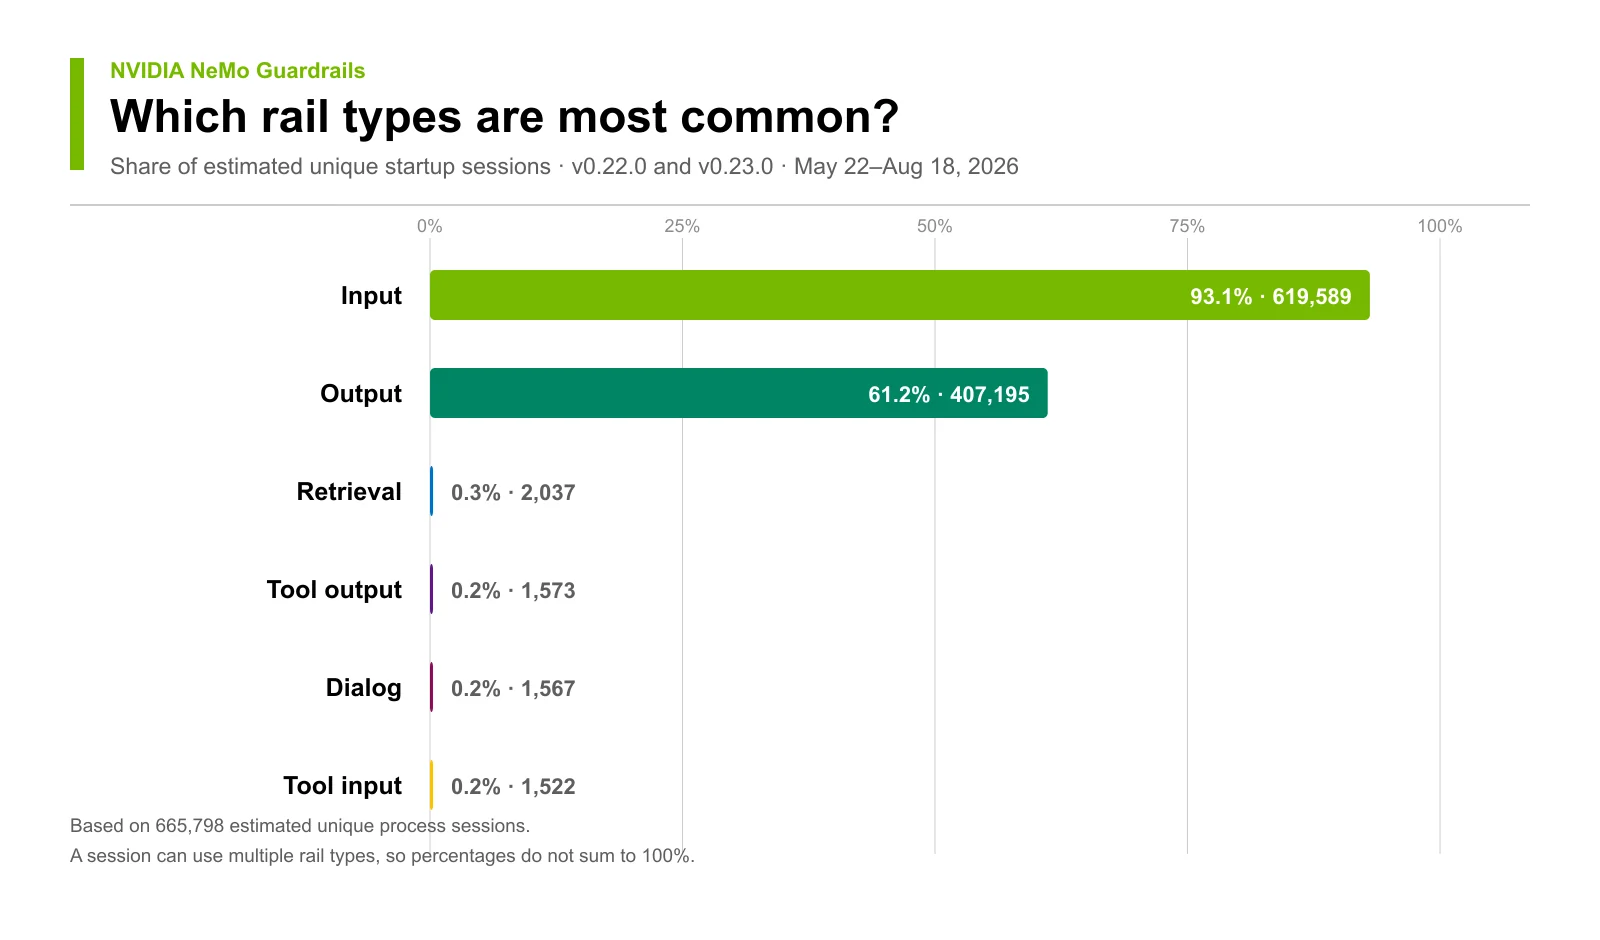
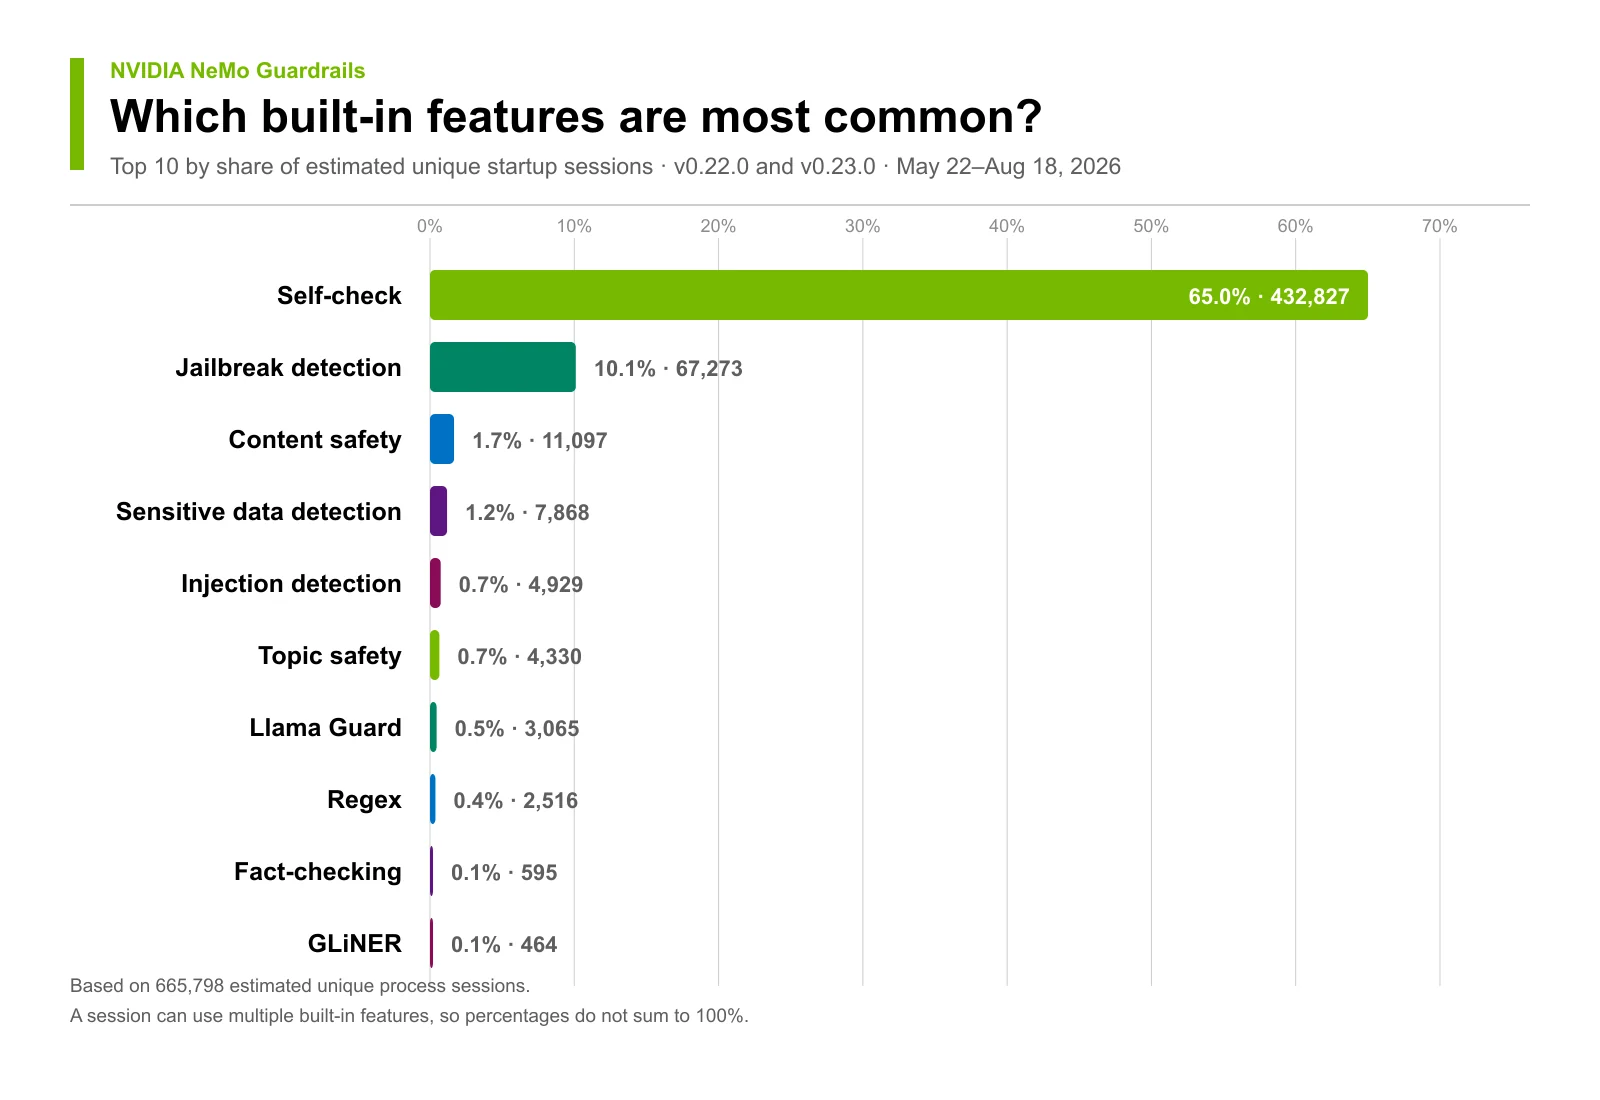
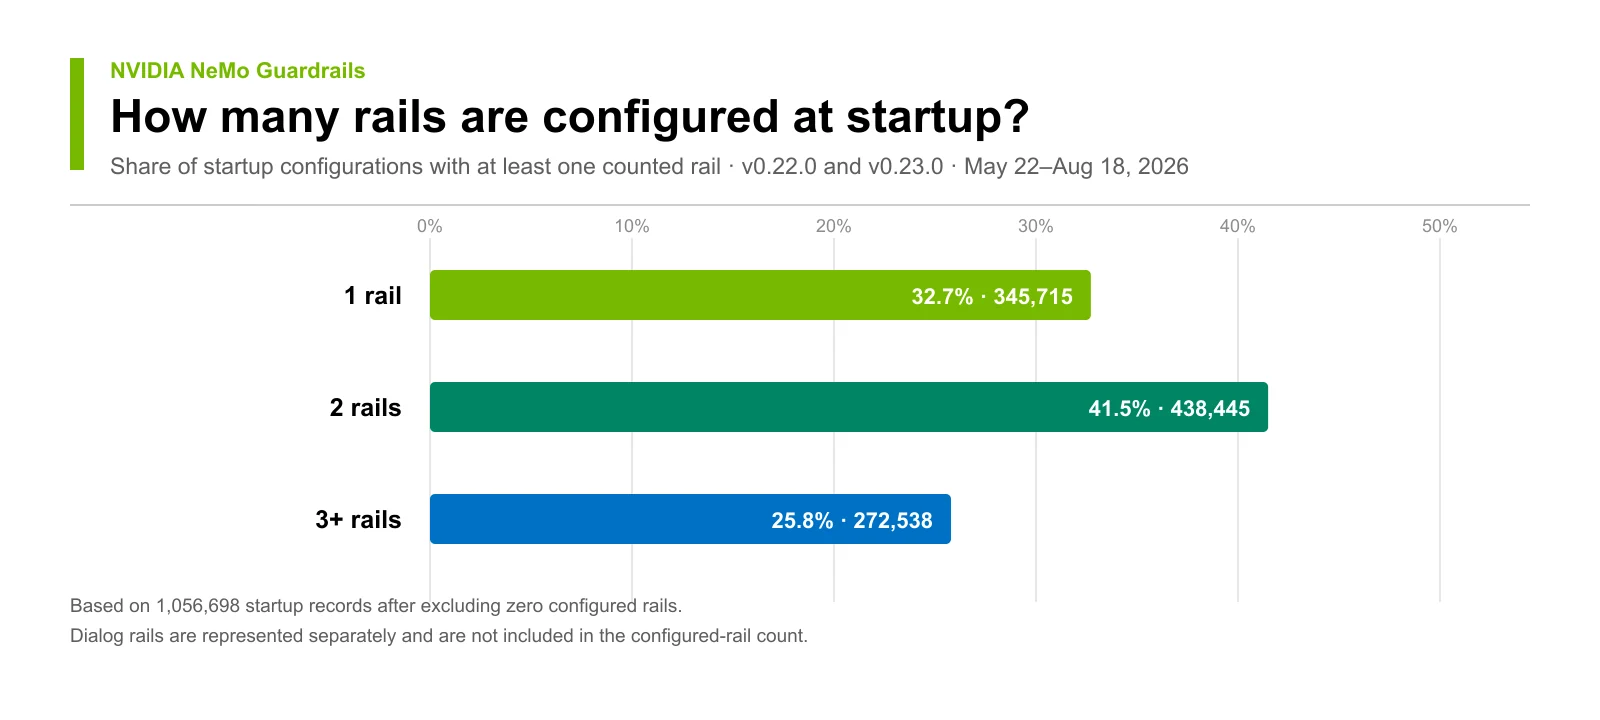
最終更新日:2026年8月18日
テレメトリには以下が含まれます:
openai、nim、nvidia_ai_endpoints など)。モデル名や認証情報は含まれませんjailbreak_detection、content_safety、topic_safety など)library、api、または cli サーバー)LLMRails または IORails)イベントペイロードにユーザーコンテンツは収集されません。ペイロードには、モデル名、API キー、エンドポイント、プロンプト、補完、トークン数、リクエストごとのメトリクス、ファイルパス、ユーザー名、IP アドレスは含まれません。NVIDIA はデータを集計してエンジニアリング作業の優先順位付けに使用し、採用動向をコミュニティと共有します。
また、このライブラリは各イベントペイロードを ~/.config/nemoguardrails/usage_stats.json にあるローカル監査ファイルに書き込もうとします。監査ファイルにはイベント JSONL が保存され、完全な NVIDIA テレメトリエンベロープは保存されません。監査の書き込みはベストエフォートであり、ローカル監査の書き込みが失敗してもテレメトリの送信は続行されます。
テレメトリを無効にするには、以下のいずれかのオプションを設定します:```bash export NEMO_GUARDRAILS_NO_USAGE_STATS=1
export DO_NOT_TRACK=1
mkdir -p ~/.config/nemoguardrails && touch ~/.config/nemoguardrails/do_not_track
NVIDIA NeMo Guardrails ライブラリが起動する前にオプトアウトを設定してください。テレメトリが開始された後に環境変数を変更したり `do_not_track` を作成したりしても、すでに実行中のハートビートスレッドは停止しません。

完全なスキーマとフィールドごとの説明については、[docs/telemetry.md](https://docs.nvidia.com/nemo/guardrails/latest/telemetry.html) を参照してください。

テレメトリの収集はいつでもオプトアウトできます。オプトアウトは NVIDIA NeMo Guardrails ライブラリ自体によるデータ収集にのみ適用されます。

サードパーティのエンドポイントには、それぞれ独自の利用規約とプライバシー慣行があります。NVIDIA NeMo Guardrails ライブラリは、NVIDIA Build (`build.nvidia.com`) などの推論エンドポイントを使用できます。NVIDIA Build または別のサードパーティエンドポイントを使用する場合、そのエンドポイントの利用規約とプライバシー慣行がライブラリとは独立して適用されます。NVIDIA NeMo Guardrails ライブラリにおけるテレメトリのオプトアウトは、選択したエンドポイントには及びません。NVIDIA Build は評価およびテスト専用であり、本番環境で使用してはなりません。NVIDIA Build を使用する際は、機密情報や個人データを送信しないでください。

## コミュニティへのコントリビューションの呼びかけ

リポジトリにあるサンプルレールは、優れた出発点です。信頼でき、安全で、セキュアな LLM の力を誰もが利用できるようにするため、コミュニティの皆様のコントリビューションを心よりお待ちしています。開発環境のセットアップ方法や NeMo Guardrails ライブラリへのコントリビューション方法については、[contributing guidelines](https://github.com/nvidia-nemo/guardrails/blob/develop/CONTRIBUTING.md) を参照してください。

## ライセンス

NeMo Guardrails ライブラリは、[Apache License, Version 2.0](http://www.apache.org/licenses/LICENSE-2.0) の下でライセンスされています。

## 引用方法

NeMo Guardrails ライブラリを使用する場合は、それを紹介した [EMNLP 2023 論文](https://aclanthology.org/2023.emnlp-demo.40) を引用してください。```bibtex
@inproceedings{rebedea-etal-2023-nemo,
    title = "{N}e{M}o Guardrails: A Toolkit for Controllable and Safe {LLM} Applications with Programmable Rails",
    author = "Rebedea, Traian  and
      Dinu, Razvan  and
      Sreedhar, Makesh Narsimhan  and
      Parisien, Christopher  and
      Cohen, Jonathan",
    editor = "Feng, Yansong  and
      Lefever, Els",
    booktitle = "Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing: System Demonstrations",
    month = dec,
    year = "2023",
    address = "Singapore",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2023.emnlp-demo.40",
    doi = "10.18653/v1/2023.emnlp-demo.40",
    pages = "431--445",
}