
Ciphey v0.12.1
⚡ 鍵や暗号方式を知らなくても暗号を自動的に復号し、エンコーディングをデコードし、ハッシュを解析します ⚡
➡️
Discord |
Documentation
⬅️
Project ciphey
cipheyは次世代のデコードツールであり、あなたにCipheyを提供した同じ人々によって作られました。
私たちはCipheyをcipheyで完全に置き換えるつもりです。
✨ cipheyについてもっと知りたい方はこちら https://skerritt.blog/introducing-ciphey/ ✨
使い方
cipheyを使う最も簡単な方法は、Discord Serverに参加し、#botsチャンネルで$cipheyを使ってcipheyを利用することです。$helpと入力すると役立つ情報が得られます!
次に良い方法は、cargo install cipheyを使ってインストールし、cipheyで呼び出すことです。
このリポジトリをgit cloneしてdocker build .を実行し、イメージを取得することもできます。
機能
興味を持っていただけるかもしれない、私たちが誇りに思っている機能をいくつか紹介します。
高速
cipheyは高速です。非常に高速です。Cipheyのような他のデコーダーは、デコードするためにどのパスを取るべきか(次にCaesarを試すのか、Base64を試すのかなど)を判断するために高度な人工知能を必要とします。
cipheyは非常に高速なので、現在このことを心配する必要がありません。Cipheyが1回のデコードを行う間に、cipheyは約7回行えます。つまり700%の速度向上です。
ライブラリファースト
cipheyにはライブラリとCLIという2つの主要な部分があります。CLIは単にライブラリを使用しているだけなので、cipheyの上に構築することができます。私たちが構築した機能には以下があります:
- Discord Bot
- プログラム全体のより良いテスト 💖
- このCLI
デコーダー
cipheyは現在16のデコーダーをサポートしており、急速に増えています。Cipheyは約50をサポートしており、私たちは毎日さらに追加しています。
タイマー
Cipheyの大きな問題の1つは、永遠に実行され続ける可能性があることでした。テキストをデコードできなければ、そのことに永遠に気づかないのです!
cipheyにはタイマー(ライブラリとCLIに組み込まれています)があり、最終的に期限切れになります。CLIのデフォルトは5秒、Discord Botのデフォルトは10秒です(ネットワークメッセージの送受信を考慮しています)。
より良いドキュメント、より良いテスト
cipheyにはすでに約120のテスト、ドキュメントテスト(ドキュメントが最新であることを保証するため)があり、すべての主要コンポーネントにドキュメントを義務付けています。これは素晴らしいことです。
LemmeKnow
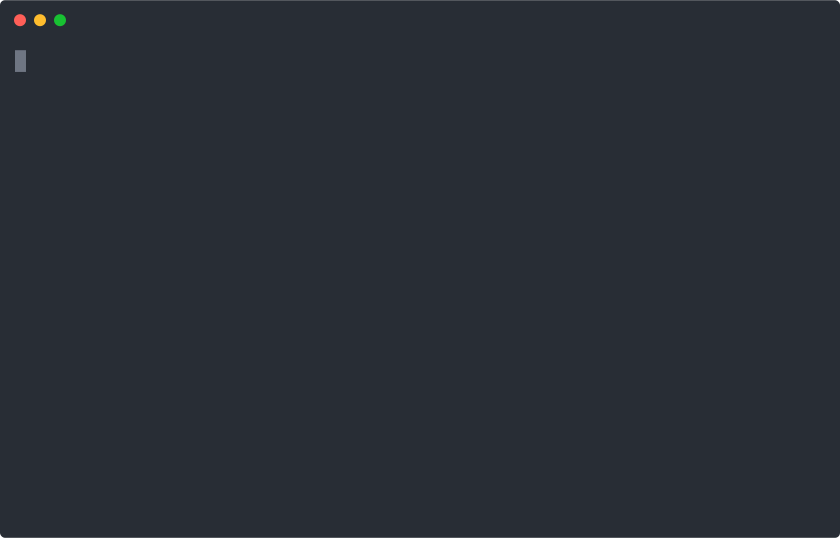

LemmeKnowはPyWhatのRust版です。33倍高速なので、何かがIPアドレスであるかどうかなどをPythonよりも3300%高速にデコードおよび判定できるようになりました。
マルチスレッド
Cipheyはマルチスレッドをサポートしておらず、かなり遅かったです。cipheyはRayon(最も高速なマルチスレッドライブラリの1つ)を使用してネイティブにサポートしています。
16のデコーダー(しかもかなり高速なもの)だけではその効果を完全には実感できませんが、より多くのデコーダー(そしてより遅いもの)を追加するにつれて、プログラム全体の速度にそれほど影響を与えないことがわかるでしょう。
マルチレベルデコード
CipheyはRot13 -> Base64 -> Rot13のようなパスのマルチレベル復号をサポートしていませんでした。あまりにも遅かったからです。cipheyはこれをサポートできるほど高速ですが、最終的には無効にする予定です。
平文検出のための設定可能な感度
cipheyはギバリッシュ検出のための設定可能な感度レベルをサポートするようになり、さまざまな種類のエンコーディングにわたってより正確な平文識別を可能にしました。Caesarのような古典暗号は英語らしい結果をより適切に処理するために低感度を使用し、他のほとんどのデコーダーはデフォルトで中感度を使用します。
この機能は平文検出における偽陽性と偽陰性を減らし、cipheyをより広範囲のエンコードされたテキストにわたってより信頼性の高いものにします。
BERTによる強化された平文検出
cipheyはgibberish-or-notクレートのBERTベースのモデルを使用した強化された平文検出を提供するようになりました。この機能は:
- 平文検出の精度を約40%向上させます
- 平文を識別する際の偽陽性と偽陰性を減らします
- 初回実行時のセットアップ中、または後で
ciphey --enable-enhanced-detectionで有効にできます - 500MBのAIモデルの一度限りのダウンロードが必要です(無料のHugging Faceアカウントが必要です)
新機能
より良い検索アルゴリズム
私たちは今、A*探索を使用しています。これは非常に高速です。
A*は、現在の状態から目標に到達するコストを見積もるためにヒューリスティックを使用することで機能します。
まず、Base64のような非常に高速なデコーダーについてはヒューリスティックを無視し、各ノードで毎回最初に実行されるようにします。
次に、cipher_identifierを使用して残りのデコーダーのヒューリスティックを計算します。これは、与えられた文字列が特定の暗号である確率を判定できます。
同じパスを再計算するのを避けるために、以前の結果をキャッシュに保存します。
不要な計算を避け、メモリ使用量が悪化した場合に抑えるために、探索木を枝刈りします。
また、デコーダーの統計を追跡して、より良く機能するデコーダーを動的に優先します(例:caesarは人気がありますが、Beaufortはそうではないので、CaesarはBeaufortよりも動的に優先されます)。
最後に、人気のあるペアを追跡します。つまりbase64 -> base64は非常に人気があるので、そのパス(と他のパス)を優先します。
カスタムテーマ
cipheyにカスタムテーマを設定できるようになりました。これはcipheyを異なる見た目にしたい場合に便利です。
これはアクセシビリティにも役立ちます。
Vigenere
私たちは今、おそらくVigenereにとって最良のアルゴリズムを使用しています。
高速で正確であり、他のどのアルゴリズムよりも非文字文字をうまく処理します。
より良い英語チェック
私たちはquadgram / trigram / 英語辞書チェッカーを使用して平文の確率を計算します。
暗号に応じてしきい値を変更します。例として、Caesarは英語に「見える」テキストを返しますが、base64はそうではありません。
これに加えて、APIキー、MACアドレスなどの人気のある正規表現(約500)のデータベースがあります。
また、文字列がデータダンプで見られた正確なパスワードであるかどうかを判定するis_password関数もあります。
より多くの暗号
- Braille
- Atbash
- Vigenere
データベース
私たちは今、統計をデータベースに保存しています。これはcipheyが時間の経過とともにどのように機能しているかを確認するのに便利です。
AIの使用
私たちは2つのことにAIを使用しています:
- TUIは完全にvibe codingされています。
- 私はAIに、世の中のあらゆるCTFチャレンジを何時間もかけて調査させました。それは15,071のCTFのリストを作成しました。その後、すべてのCTFを調べてwriteupを探しました。それらのwriteupの中で、エンコーディング/デコーディングに関連するものを探しました。そしてそれらからテストを作成しました。これにより、テストカバレッジを増やし、すべてのCTFエンコーディング/デコーディングチャレンジがこのツールで解決可能であることを確認できるようになりました。